
AWS liet agents een cloud-emulator bouwen zonder menselijke code review. De review verhuisde naar de tests

By Surya Pratap
13 november 2026
8 min read
AI & Technology

13 november 2026
8 min read
 Bekijk het proces en de scoresHover to explore
Op 11 november bracht AWS AWS Emulator uit, een lokale vervanger van zijn diensten die je op je laptop draait om applicaties te bouwen en te testen zonder de cloud aan te roepen. De tool is handig, maar voor founders is de bewering die erbij hoorde belangrijker. In de woorden van Matthew Goldberg, de senior principal engineer die de aankondiging schreef: "De emulator is volledig geschreven door autonome agents. Ons team heeft geen enkele regel van de code geschreven of gereviewd." De meeste startups hebben dit jaar gemerkt dat menselijke review de traagste stap is in een team dat sterk op agents leunt. AWS heeft één manier laten zien om die stap te schrappen, en de voorwaarden die dat mogelijk maakten zijn het nuttige deel.
AWS beschrijft het product eenvoudig: "een lokale emulator van AWS-diensten die je op je eigen machine draait om je AWS-applicaties te bouwen en te testen." De berichtgeving vult de details aan:
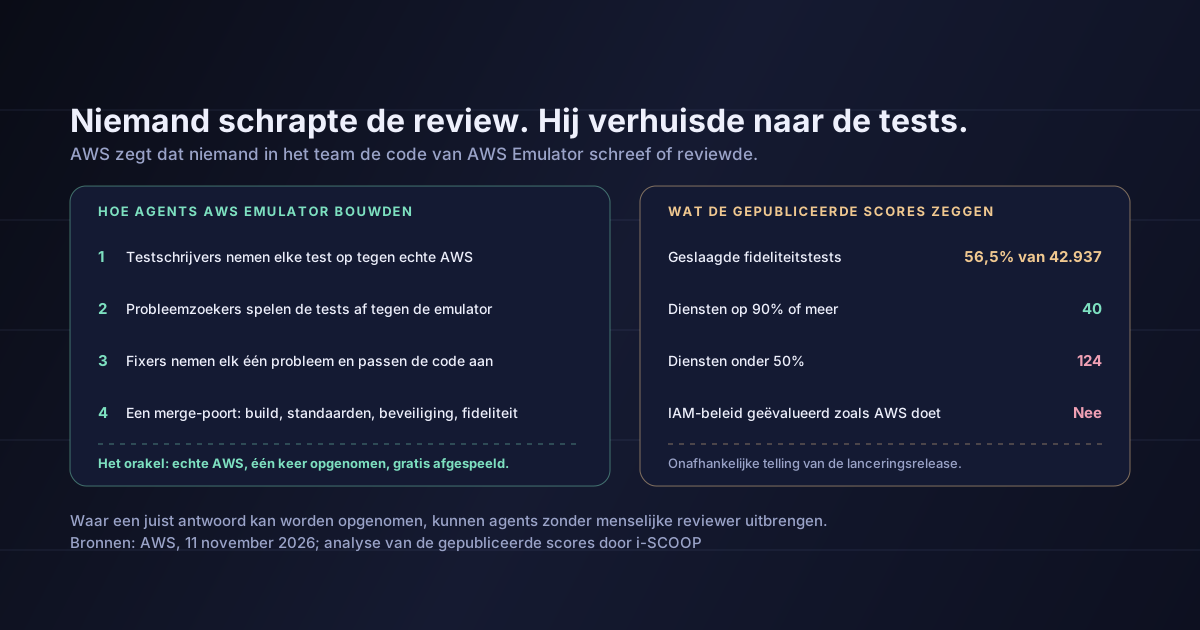
AWS legt uit dat de emulator "in de kern wordt gebouwd door drie teams van agents. Eén team beheert een testsuite; één team vindt problemen in de emulator; en één team lost die problemen op." Een vierde fase bepaalt wat er wordt uitgebracht.
De schaal is groot. AWS zegt dat "honderden agents tegelijk aan de codebase werken" en dat het "dagelijks duizenden opgeloste problemen" ziet. Het project begon als weekendexperiment: een lege webserver die verzoeken voor alle API-modellen accepteerde "maar niets deed", met de testsuite als specificatie.
Niemand schrapte de review. AWS verplaatste hem van een persoon die diffs leest naar een testsuite die tegen het echte systeem is gecontroleerd.
De post van AWS geeft geen slagingspercentages; er wordt een latere post beloofd over hoe fideliteit wordt gemeten. Help Net Security meldt dat AWS bij elke release fideliteitsscores per dienst publiceert, en i-SCOOP telde ze voor de lanceringsrelease. De resultaten:
Lees die cijfers met de kanttekening van i-SCOOP zelf: "een test slaagt alleen als de emulator precies teruggeeft wat AWS teruggaf", en "een mislukte test betekent vaak één verkeerde foutmelding, geen kapotte dienst." De samenvatting van i-SCOOP is redelijk: een snelle, gratis emulator "die de gangbare paden van de populaire diensten grotendeels goed heeft."
De beperkingen zijn duidelijker dan de scores. Help Net Security meldt dat de emulator "AWS Identity and Access Management (IAM) en resource-based policies niet evalueert zoals AWS dat doet", alles in het geheugen bewaart en met één regio en één account moet worden gebruikt. i-SCOOP voegt toe dat een verzoek dat AWS zou weigeren lokaal kan slagen, en omgekeerd.
Eén voorwaarde deed het meeste werk: AWS had een orakel. Voor elk verzoek geeft echte AWS het juiste antwoord, en dat antwoord kun je één keer opnemen en duizenden keren gratis afspelen. De wijziging van een agent wordt niet beoordeeld op de vraag of een reviewer de diff mooi vindt. Ze wordt beoordeeld op de vraag of de emulator nu overeenkomt met het systeem dat hij nabootst. Dat is een sterkere controle dan de meeste menselijke reviews, en hij wordt nooit moe.
De meeste startupcode heeft zo'n orakel niet. Niemand kan het juiste antwoord opnemen op "is deze onboardingflow goed?" of "klopt deze prijspagina?". Maar veel onderdelen van een product hebben er wel een, en die onderdelen kunnen richting het AWS-model bewegen:
import json, pathlib

CASES = pathlib.Path("fidelity_cases")

def record(name: str, request: dict, call_real) -> None:
    """Run once against the real system and save its answer."""
    response = call_real(request)
    CASES.joinpath(f"{name}.json").write_text(
        json.dumps({"request": request, "expected": response}, indent=2))

def replay(call_ours) -> dict:
    """Run every saved case against our code; no calls to the real system."""
    results = {"pass": 0, "fail": []}
    for path in sorted(CASES.glob("*.json")):
        case = json.loads(path.read_text())
        if call_ours(case["request"]) == case["expected"]:
            results["pass"] += 1
        else:
            results["fail"].append(path.stem)
    return results

def gate(before: dict, after: dict) -> bool:
    """Merge only if nothing that passed before fails now."""
    newly_failing = set(after["fail"]) - set(before["fail"])
    return not newly_failing
Vind je orakels. Maak een lijst van de delen van je codebase waarvoor buiten je code een juist antwoord bestaat: de API van een leverancier, het oude systeem, een referentiedataset. Daar kunnen agents met de minste menselijke review werken.
Neem op voordat je delegeert. Leg eerst de antwoorden van het echte systeem vast, zoals de testschrijvers van AWS deden, en laat elk antwoord tegen de bron controleren. Een test die een agent schrijft zonder hem tegen het echte systeem te controleren, bevestigt alleen wat de agent al gelooft.
Filter op regressies, niet op smaak. Merge alleen als de build slaagt, de controles op standaarden en beveiliging slagen en niets wat eerder slaagde nu faalt. Die regel is goedkoop om te draaien en moeilijk om tegen in te gaan.
Publiceer je eigen score. Houd het slagingspercentage per onderdeel bij en laat het aan het team zien. Een cijfer dat 56,5% toegeeft, is nuttiger dan een belofte van volledigheid, omdat mensen zien waar ze de code kunnen vertrouwen.
Houd mensen betrokken waar geen orakel is: productoordeel, beveiligingsgrenzen en alles wat met rechten te maken heeft. Het resultaat van AWS wijst dezelfde kant op. Het enige gebied dat de emulator niet probeert na te bootsen, toegangscontrole, is precies het gebied waar een fout antwoord het gevaarlijkst is. In juli betoogden we dat een startup de reviewer moet aannemen vóór de programmeur. AWS Emulator verfijnt dat advies: neem de reviewer aan voor de delen zonder orakel, en besteed de rest van de moeite aan het bouwen van een orakel. Voor de delen van een AI-product waar je juist gedrag kunt definiëren, begin je met een evaluatieset van echte gebruikerstaken.
Als je AWS Emulator wilt gebruiken
Behandel het als een snelle lokale lus, niet als bewijs dat je code op AWS werkt. Gebruik het niet om toegangscontrole te testen, want IAM- en resourcebeleid worden niet geëvalueerd zoals AWS dat doet. Gebruik één regio en één account, reken erop dat de toestand verdwijnt als de emulator stopt, en bekijk de score per dienst voor de diensten waarvan je afhankelijk bent. i-SCOOP waarschuwt bovendien dat je SDK, als die niet naar de emulator wijst, "stilletjes echte AWS aanroept met de inloggegevens die hij vindt." Doe je laatste controles op echte AWS.
Dat er geen mens bij betrokken was. Volgens AWS heeft geen mens de code geschreven of gereviewd. Toch kozen mensen het orakel, ontwierpen ze de drie teams, legden ze de codestandaarden vast en bouwden ze de merge-poort. AWS schrijft het toe aan "de vangrails die we hebben ingericht". Het menselijke werk verschoof naar eerder in het proces; het verdween niet.
Dat 56,5% betekent dat de helft van de emulator kapot is. De tests eisen exacte overeenkomsten, inclusief foutmeldingen. De gangbare paden van populaire diensten scoren veel hoger dan de lange staart.
Dat jouw product hetzelfde kan. AWS had een perfect, goedkoop te raadplegen referentiesysteem en het budget om honderden agents te draaien. De meeste startups hebben geen van beide voor het grootste deel van hun code. Neem de methode over waar je een orakel hebt, niet overal.
Dat de cijfers vaststaan. De aankondiging van AWS spreekt zowel van "duizenden" als van "honderden" agents, en de slagingspercentages komen uit een externe telling van één release, niet van AWS. Reken erop dat beide veranderen naarmate AWS meer publiceert.
Op 11 november 2026 bracht AWS AWS Emulator uit, een gratis lokale emulator van zijn diensten, en zei dat niemand in het team de code had geschreven of gereviewd. Agents schreven tests die tegen echte AWS waren gecontroleerd, andere agents speelden ze af om afwijkingen te vinden, een derde groep loste elk probleem op, en een merge-poort controleerde build, standaarden, beveiliging en fideliteit. Een onafhankelijke telling van de scores bij de lancering vond dat 56,5% van 42.937 fideliteitstests slaagde, met grote verschillen tussen diensten en zonder evaluatie van IAM-beleid.
Voor founders is de les niet dat review achterhaald is. De les is dat review naar de tests kan verhuizen als je een betrouwbare bron van juiste antwoorden hebt, en bij mensen moet blijven als je die niet hebt.
Kies deze week één deel van je codebase dat een orakel heeft, neem er twintig echte antwoorden van op, en maak "niets wat eerder slaagde faalt nu" een merge-regel voor wijzigingen van agents in dat deel.
Bronnen: Matthew Goldberg, AWS, AWS Emulator: a local emulator built 100% by autonomous AI agents (11 november 2026) — de productbeschrijving, de 438 API-modellen, de CC0-licentie, de drie teams van agents, de merge-poort, het aantal agents en problemen, en de verklaring dat het team de code niet had geschreven of gereviewd; Anamarija Pogorelec, Help Net Security, AWS Emulator: Open-source tool for testing AWS apps locally, built by autonomous AI agents (12 november 2026) — de vier manieren om het te draaien, de scores per dienst die bij elke release worden gepubliceerd, en de beperkingen rond IAM, regio's, accounts en geheugen; Tom Cuylaerts, i-SCOOP, AWS Emulator was built by AI agents nobody reviewed, and its own test scores show where to trust it (12 november 2026) — de telling van de scores bij de lancering, de cijfers per dienst, de kanttekeningen bij exacte overeenkomsten, de opmerking over pull requests en Apache-gelicentieerde code van derden, en de waarschuwing over SDK-endpoints. De code in sectie 4 is mijn illustratie, en de analyse in secties 4 en 5 is van mij.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.