
Twee agent-harnesses in 48 uur — en ze maken tegengestelde gokken (2026)

By Surya Pratap
7 augustus 2026
11 min read
AI & Technology

7 augustus 2026
11 min read
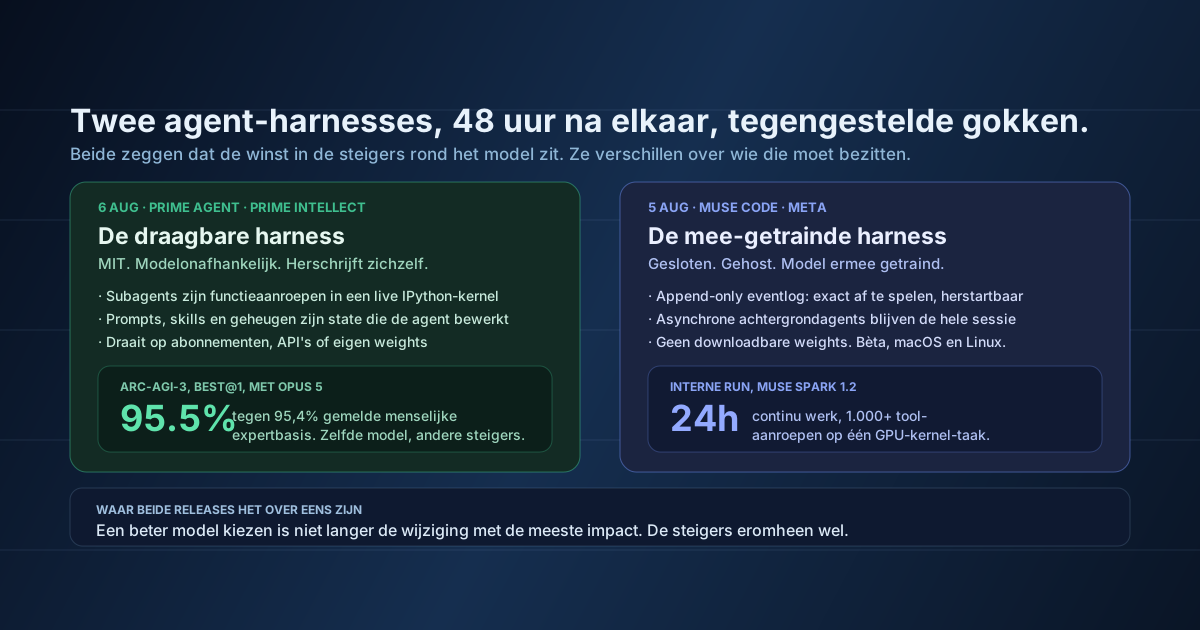
Op 5 augustus bracht Meta Muse Code uit — een coding agent voor de terminal die draait op Muse Spark 1.2, een model dat samen met de agent zelf is getraind. Op 6 augustus maakte Prime Intellect Prime Agent open source onder MIT, een harness die elk model draait waarop je hem richt, en die met Opus 5 erachter 95,5% haalde op ARC-AGI-3.
Geen van beide releases gaat in de kern over een model. Beide gaan over de steigers eromheen: hoe context wordt beheerd, hoe subagents worden gestart, wat een crash overleeft, wat de agent halverwege een taak aan zichzelf mag veranderen. Dat is een verschuiving die een naam verdient. Twee jaar lang waren de interessante releases checkpoints, en de vraag voor founders was naar welk model je routeert. Deze twee zeggen dat de resterende winst niet meer in het model zit.
Wat het tweetal echt nuttig maakt, is dat ze het eens zijn over de premisse en het volledig oneens over de conclusie. De een zegt dat de harness draagbaar is en van jou moet zijn. De ander zegt dat de harness alleen werkt als het model erin is getraind, en dus van het lab moet zijn. Je zult een kant moeten kiezen, dus het is de moeite waard het argument te begrijpen.
Prime Agent rust op twee ideeën, en allebei zijn ze ongebruikelijk genoeg om ze helder te benoemen.
Het eerste is het Recursive Language Model. In plaats van context als een venster dat volloopt en wordt afgekapt, is context een variabele in een persistente IPython-kernel. Het model schrijft code die op zijn eigen geschiedenis werkt — die doorzoekt, opknipt, delen ervan samenvat — in plaats van een kant-en-klare prompt te krijgen. Delegeren aan een subagent is geen aparte orkestratielaag; het is een functieaanroep in dezelfde REPL. Als je ooit een supervisor-node in LangGraph hebt geschreven, is dit hetzelfde probleem een niveau lager opgelost: de agent programmeert zijn eigen delegatie in plaats van dat jij die bedraadt.
Het tweede is de Continual Harness. Prompts, skills, geheugen en definities van subagents worden behandeld als state die de agent vanuit zijn eigen run kan aanmaken, lezen, bijwerken en verwijderen. Het commando /refine analyseert het traject tot dan toe en stelt gerichte wijzigingen aan die state voor — op de achtergrond gepland zodat het niet blokkeert, toegepast op de grenzen tussen turns, onderbouwd met bewijs en terug te draaien via een rollbackgeschiedenis. De agent herschrijft, in beperkte en controleerbare zin, zijn eigen steigers terwijl hij werkt.
Het kopcijfer: 95,5% RHAE Best@1 op ARC-AGI-3 met Opus 5, tegenover de door ARC gemelde menselijke expertbaseline van 95,4%. De runs kwamen uit op 95,0, 95,2 en 95,5, dus het resultaat is stabiel en geen gelukstreffer. Best@3 haalt 99,97%, met alle 183 van de 183 levels voltooid. Prime Intellect meldt ook een betere tokenefficiëntie dan de eigen harnesses van de modellen, en dat telt zwaarder dan de score.
Toch is het niet het ARC-cijfer dat je aandacht moet trekken. Het is de vergelijking eronder: Prime Agent met GLM-5.2 was even goed als of beter dan Claude Code met Opus 5 en Codex met GPT-5.6 Sol op een reeks benchmarks met lange context — OOLONG, OOLONG-Pairs, OBLIQ-Bench, LongBenchPro en ManyIH. Als dat onafhankelijk standhoudt, betekent het dat een open middenklassemodel in een betere harness een frontiermodel kan evenaren in de harness die zijn eigen lab bouwde. Dat is een veel grotere uitspraak dan één benchmarkrecord.
De demo's, ter kalibratie
Prime Agent maakte werkende Rust-emulators voor de SEGA Genesis en de Game Boy Color zonder referentiecode, en haalde binnen enkele uren een productiescore van meer dan 100.000 in Factorio. Lees ze zoals je elke lanceringsdemo zou moeten lezen — als bewijs dat het systeem heel lang samenhangend werk kan volhouden, niet als bewijs over jouw codebase. Emulators en fabrieksgames hebben iets wat jouw product niet heeft: een snel, eenduidig en automatisch signaal of de laatste wijziging klopte.
De release van Meta is conceptueel minder vernieuwend en operationeel een stuk serieuzer. Muse Code is een terminalagent in bèta voor macOS en Linux, te installeren met één shellcommando, die Muse Spark 1.2 draait via Muse Code of de Meta Model API. Er zijn geen downloadbare weights.
Drie ontwerpkeuzes zijn het overnemen waard, of je hem nu ooit draait of niet.
De append-only eventlog. Elke modelaanroep, toolrun, goedkeuring en bewerking wordt toegevoegd aan een lokale log, waardoor de runtime exact opnieuw af te spelen en veilig te herstarten is. Als de agent na veertig minuten in een taak crasht, gaat hij verder waar hij was in plaats van opnieuw te beginnen. Dit is de meest onderschatte eigenschap van de release. Iedereen die lange agentsessies in productie heeft gedraaid, weet dat de fout die pijn doet geen verkeerd antwoord is — het is dertig minuten opgebouwde state verliezen aan een time-out, zonder enige manier om te reconstrueren wat de agent dacht op het moment dat het misging.
Persistente achtergrondagents. In plaats van per taak een nieuwe subagent te starten, houdt Muse Code een set asynchrone achtergrondagents de hele sessie in leven. De opgegeven reden is dubbel informatie verzamelen vermijden — de tweede subagent leest de repository niet opnieuw die de eerste net heeft gelezen. Als jouw orkestratie per stap een schone agent start, betaal je die herontdekkingstol bij elke stap, en die stapelt zich op.
Plannen met goedkeuring als standaardskill. Muse Code wordt geleverd met /plan om van een taak een plan te maken dat je goedkeurt vóór uitvoering, /grill om dat plan onder druk te zetten tot het standhoudt, en /goal om naar voltooiing te sturen. Een adversariële ronde over het plan voordat er code wordt geschreven, is een goedkope ingreep die de meeste teams overslaan.
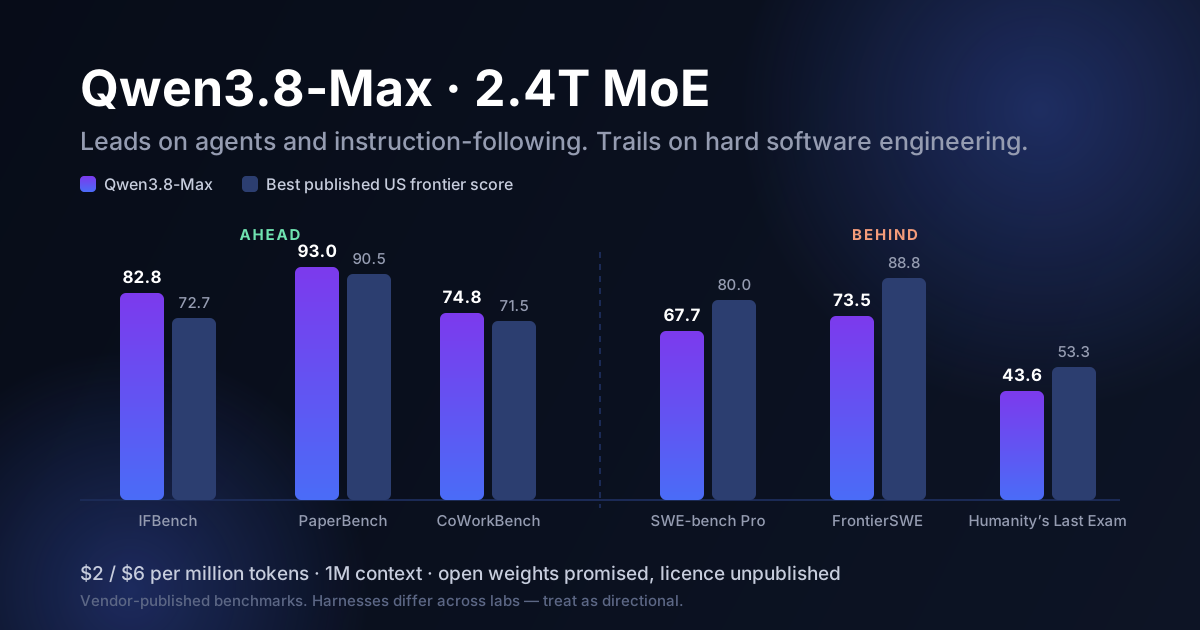
Meta evalueerde op Terminal-Bench 2.1 (89 taken, pass@1 over vijf pogingen), DeepSWE v1.1 (113 taken in 91 repositories en vijf talen) en een interne benchmark van 440 taken op basis van echte pull requests, vergeleken met Grok 4.5, Claude Opus 5, GPT-5.6 Terra, Gemini 3.6 Flash en Kimi K3. Ik heb de gepubliceerde cijfers van Muse Spark 1.2 niet in een primaire bron kunnen verifiëren — ze staan in afbeeldingen van grafieken in de post van Meta — dus ik ga ze niet citeren. Ter vergelijking: Muse Spark 1.1 scoorde 80,0 op Terminal-Bench 2.1, en Qwen3.8-Max meldde vorige week 86,6 op dezelfde benchmark. De claim die makkelijker te beoordelen is, is de interne run waarin het model GPU-kernels optimaliseerde over meer dan 1.000 toolaanroepen en tot 24 uur onafgebroken werk. Een duur van die omvang is een eigenschap van de harness, niet van het model.
Dit is het deel dat het tweetal interessant maakt in plaats van alleen druk.
Prime Intellect is ongewoon openhartig over zijn eigen beperking. Hun verslag noemt wrijving bij het draaien van Prime Agent met verschillende modellen, en zegt ronduit dat geen enkel model is getraind rond Prime Agent of zijn kernfuncties. De 95,5% komt van een frontiermodel dat iets doet waarvoor het nooit specifiek is getraind, in een harness die het nooit eerder heeft gezien. Ze behandelen de resterende wrijving als de afstand tussen waar ze nu zijn en waar de aanpak naartoe zou kunnen.
Meta dichtte precies die kloof, in de andere richting. Muse Spark 1.2 is samen met de tool getraind. Model en harness zijn ontwikkeld als één artefact, en daarom kan Meta sessies van 24 uur en herstel met exacte replay beloven — het model is gevormd om zich goed te gedragen in precies die runtime.
Beide partijen zijn het dus eens over het inhoudelijke technische punt: model en harness zijn gekoppeld, en de prestatie zit in die koppeling. Ze verschillen over wie de koppeling mag bezitten. Prime Intellect gokt erop dat een open, draagbare, zichzelf aanpassende harness sneller verbeteringen opbouwt dan welk lab ook, en dat modellen uiteindelijk naar harnesses zoals deze toe getraind zullen worden. Meta gokt erop dat co-training een slotgracht is, en dat de beste agent altijd die is waarvan het model erin is opgegroeid.
Waarom dit jou specifiek aangaat
Als de draagbare gok wint, zijn de steigers van je agent een duurzaam bezit en blijft van model wisselen goedkoop — dan moet je in je harness investeren. Als de mee-getrainde gok wint, zijn je steigers een tijdelijke brug naar welk lab op dat moment voorligt, en moet je investeren in het vermogen om te migreren. Dat leidt dit kwartaal tot andere technische beslissingen, en daarom is het de moeite waard om een standpunt te hebben in plaats van op het antwoord te wachten.
Vier kanttekeningen, want het cijfer gaat deze week vaak zonder die kanttekeningen worden geciteerd.
De meeste teams die dit lezen, moeten deze week niet van harness wisselen. Maar bijna elk team zou van allebei moeten lenen.
/grill-patroon — een plan genereren en het aanvallen vóór uitvoering — vangt het soort fout waarbij de agent veertig correcte stappen zet richting een verkeerd doel. De diff aan het eind reviewen kan dat niet vangen.Vorige week schreef ik dat de gaten in de benchmarks van Qwen3.8-Max niet in de pure intelligentie zaten — GPQA Diamond op 92,6 is frontierniveau — maar in agentisch werk over een lange horizon, waarin een model een plan over veertig stappen moet vasthouden en moet herstellen van zijn eigen fouten. Deze week brachten twee labs releases uit die precies dat gat aanpakken, en geen van beide deed dat door het model slimmer te maken.
Dat is het patroon om mee te nemen. De resterende afstand tussen een indrukwekkende demo en een systeem dat een echte workload overleeft, wordt gedicht met engineering: duurzame state, hervatbaarheid, contextbeheer, delegatie die niet kwijtraakt wat ze heeft geleerd, een plan waar iemand mee in discussie ging vóór uitvoering. Niets daarvan komt in een checkpoint. Alles is te bouwen door een competent team, wat betekent dat het binnen je bereik ligt, en dat het voordeel niet verloopt als het volgende model uitkomt.
De ongemakkelijke implicatie is dat als je agent ondermaats presteert, het model waarschijnlijk niet je probleem is. Van checkpoint wisselen is het makkelijkste experiment en daarom het experiment dat de meeste teams als eerste draaien. Het is zelden het experiment dat het cijfer verschuift. Bouw de log, repareer de delegatie, ga in discussie met het plan — en ga dan pas op zoek naar een model.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.