
Qwen3.8-Max: Alibaba maakte een model van 2,4T open en prijsde het als een gesloten model (2026)

By Surya Pratap
6 augustus 2026
12 min read
AI & Technology

6 augustus 2026
12 min read
Op 3 augustus bracht Alibaba Qwen3.8-Max uit: 2,4 biljoen parameters in totaal, 95 miljard actief per token, een contextvenster van een miljoen tokens, en tekst, beeld en video als input. Het is het grootste model dat het Qwen-team ooit heeft uitgebracht, en het is de eerste Qwen van Max-klasse waarvan Alibaba heeft gezegd dat het open source wordt.
Twee details zijn interessanter dan het aantal parameters. Het eerste is de prijs: $2 per miljoen inputtokens, $6 per miljoen outputtokens. Dat is geen korting. Het is ongeveer wat Amerikaanse gesloten labs vragen, van een bedrijf waarvan het hele concurrentieverhaal twee jaar lang was dat het onder hun prijs dook. Het tweede is dat de weights op het moment van schrijven niet op Hugging Face staan en dat er geen licentietekst is gepubliceerd — de aankondiging zei "volgende week".
Die twee dingen vertellen je meer over je volgende stap dan de benchmarktabel. Dit is de eerlijke lezing.
Qwen3.8-Max is een sparse mixture-of-experts-model: 2,4T in totaal, ongeveer 95 miljard geactiveerd per token, en daarom kan het worden aangeboden voor een prijs die niets met zijn omvang te maken heeft. Het contextvenster is 1M tokens — maximaal 991.000 input, wat zakt naar 983.000 met redeneren aan, maximaal 131.000 output, en een redeneerbudget dat tot 262.000 tokens kan oplopen. Input is tekst, beeld en video; output is alleen tekst.
De API is direct beschikbaar via Alibaba Cloud Model Studio en QwenCloud, in OpenAI-compatibele en DashScope-formaten, en ook compatibel met het protocol van Anthropic. De gepubliceerde limieten zijn ruim: 2M tokens per minuut, 15.000 verzoeken per minuut. Function calling, gestructureerde output, batching, prefix completion en fine-tuning worden allemaal ondersteund, naast vijf ingebouwde tools — code interpreter, webzoeken, webextractie, en zoeken van beeld naar beeld en van tekst naar beeld.
Bij caching wordt de prijsstelling interessant. Impliciete cache-reads kosten $0,25 per miljoen tokens, een achtste van de prijs zonder cache. Expliciete cache aanmaken kost $2,50, met reads voor $0,17. Voor een agent die elke turn een grote, stabiele prefix opnieuw afspeelt, is dat de regel op de factuur die bepaalt of een workflow betaalbaar is.
Tegelijk werd een tweede checkpoint aangekondigd, Qwen3.8-27B, ook met open weights in het vooruitzicht. Het heeft nog geen specificaties, geen benchmarktabel en geen prijs. Onthoud dat — voor de meeste lezers is de 27B de release die ertoe doet, en het is de release waarover we het minst weten.
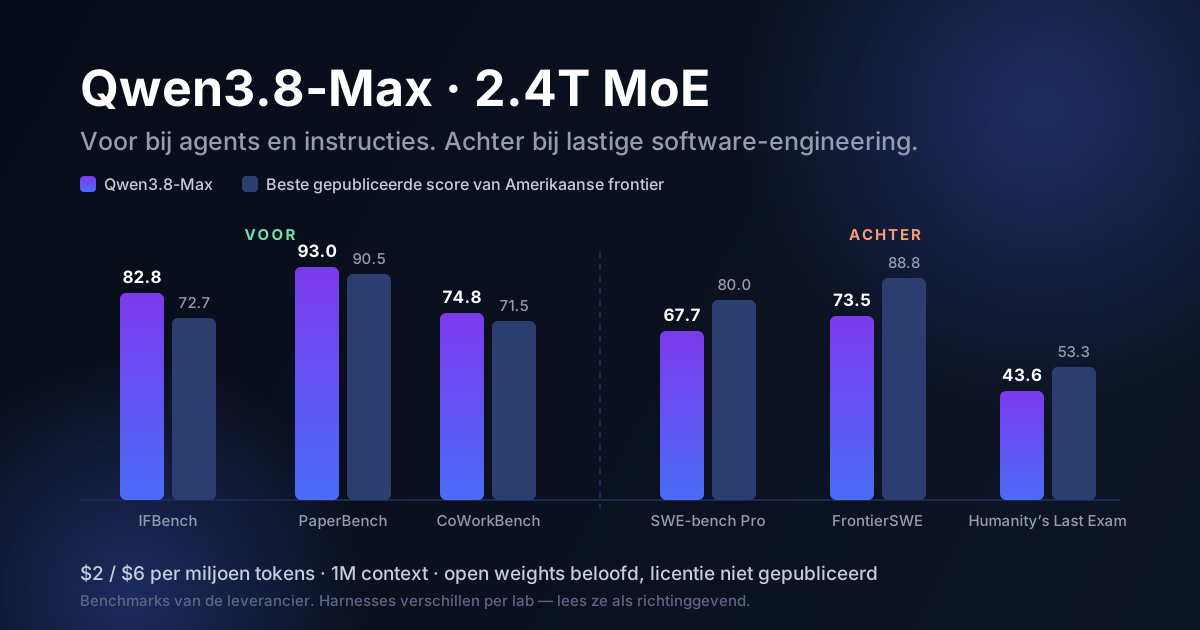
Alibaba publiceerde een brede set vergelijkingen. Lees die als twee verschillende verhalen, want dat is het.
| Benchmark | Qwen3.8-Max | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| IFBench (instructies volgen) | 82,8 | 72,7 | 63,5 |
| PaperBench | 93,0 | 90,5 | — |
| CoWorkBench | 74,8 | 71,5 | — |
| WorkSpaceBench | 67,7 | 65,6 | — |
| GPQA Diamond | 92,6 | — | — |
| OmniDocBench 1.5 | 92,1 | — | — |
| Terminal-Bench 2.1 | 86,6 | 88,8 | — |
| SWE-bench Pro | 67,7 | — | 80,0 |
| DeepSWE 1.1 | 56,6 | — | 70,0 |
| FrontierSWE | 73,5 | — | 88,8 |
| Humanity's Last Exam | 43,6 | 47,2 | 53,3 |
| MRCR v2 (lange context) | 92,9 | 93,8 | — |
Het patroon is helder genoeg om op te routeren. Qwen3.8-Max loopt voorop bij het volgen van instructies, documentbegrip, ophalen uit lange context en afgebakend agentisch kantoorwerk. Het loopt met dubbele cijfers achter bij lastige software-engineering en open redeneren — 12 punten minder op SWE-bench Pro, 15 op FrontierSWE, 13 op DeepSWE, 10 op Humanity's Last Exam.
IFBench verdient een tweede blik, want het is het meest onderschatte getal in de tabel en het getal dat het directst raakt aan betrouwbaarheid in productie. 82,8 tegenover 72,7 en 63,5 is geen marginale voorsprong. Instructies volgen bepaalt of je JSON-schema geldig terugkomt, of het model stopt als dat wordt gevraagd, of de toolaanroep de vorm heeft die je harness verwacht. Tien punten voorsprong daar zie je terug in je foutpercentage voordat je het ziet in welke capaciteitsdemo ook.
De kleurrijke resultaten zijn kleurrijk. In een gesimuleerde e-commercebenchmark van 365 dagen eindigde het model met ¥416.252, ongeveer 38% meer dan GLM 5.2 en ruim het dubbele van wat Qwen3.7-Max haalde. In een chipontwerptaak bracht het een cryptografische accelerator terug van 8.298 logische poorten naar 678, een verkleining van het die-oppervlak met 81%. Zie die als capaciteitsdemonstraties, niet als bewijs over jouw workload.
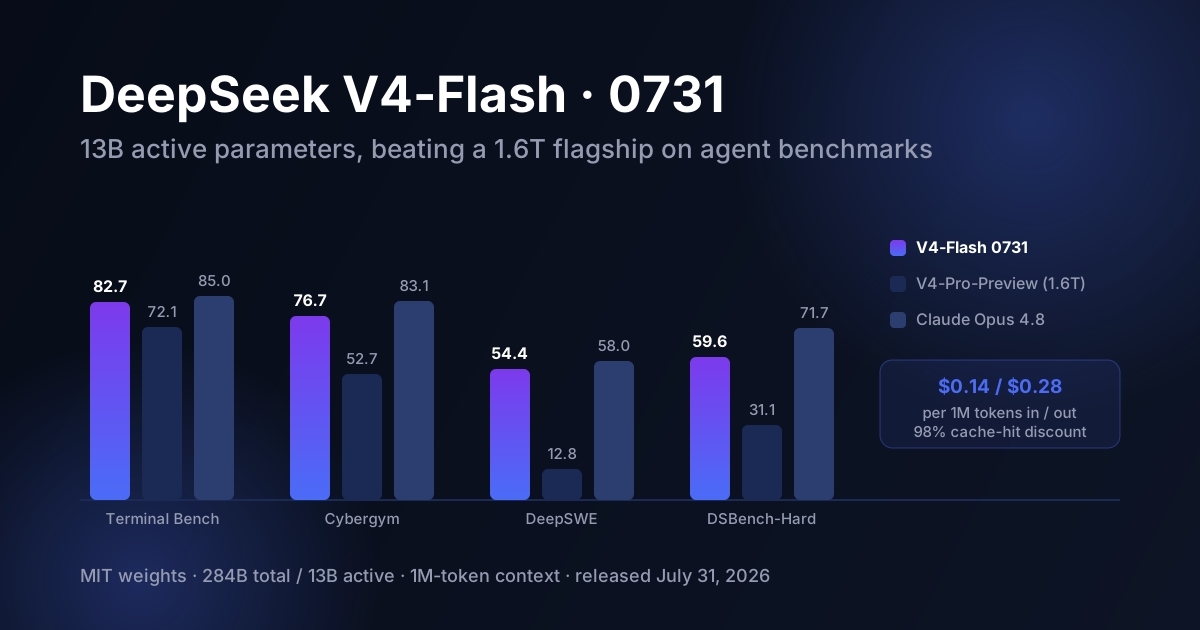
Leg Qwen3.8-Max naast wat drie dagen eerder uit China kwam. V4-Flash van DeepSeek kost $0,14 voor input en $0,28 voor output. Qwen3.8-Max kost $2 en $6 — veertien en eenentwintig keer zo duur, uit hetzelfde brede ecosysteem, in dezelfde week.
Dat is een bewuste positionering, en het markeert een verandering. Twee jaar lang concurreerden de Chinese labs door drastisch goedkoper te zijn dan de frontier. Alibaba heeft daar nu van afgezien. Het prijsde gelijk aan Amerikaanse gesloten modellen en liet de benchmarktabel het pleidooi voeren. De gok is dat bedrijven die een agentplatform kiezen meer geven om de vraag of het model de taak afmaakt dan om de vraag of het een vijfde kost.
Wat dit betekent voor je kostenmodel
Als je ervan uitging dat "de Chinese open-weightoptie altijd de goedkope laag is", dan is die aanname niet langer betrouwbaar. Er zijn nu open-weightmodellen aan beide kanten van de prijscurve, en het label zegt niets over de rekening. Zet dit specifieke model af tegen jouw specifieke verkeer. Het enige onafhankelijke datapunt dat hier het noemen waard is: de Vals Index mat dat Qwen3.8-Max gelijk speelt met Claude Opus 4.7, 66,1 tegen 66,1 — tegen ongeveer 2,3× lagere kosten per test. Dat is een echte efficiëntievoorsprong op de gesloten frontier, en tegelijk nergens in de buurt van de economie van DeepSeek.
Dit is het deel waar de meeste berichtgeving overheen gaat. Er zijn drie dingen tegelijk waar, en je hebt ze alle drie nodig.
Eén: de weights zijn niet uit. Alibaba beloofde ze voor "volgende week" op Hugging Face en ModelScope. Op 6 augustus is er voor geen van beide checkpoints iets gepubliceerd, en is er geen datum gegeven. Een beloofde release is een roadmapitem, geen bezit waarop je kunt plannen. Precedenten wijzen beide kanten op — Qwen3.6-35B-A3B en Qwen 4 Coder kwamen vanaf dag één uit onder Apache 2.0, maar Qwen3.6-Plus, Qwen3.7-Max en Qwen3.7-Plus bleven allemaal gesloten en alleen via API beschikbaar. Deze release keert dat tweede patroon om, en omkeringen zijn het bevestigen waard voordat je erop bouwt.
Twee: er is geen licentietekst gepubliceerd. Mensen uit de praktijk die de aankondiging bekeken, wezen op schijnbare geografische verboden voor de VS, de EU, het VK en Korea, en Alibaba heeft niets verduidelijkt. Zolang het licentiebestand niet bestaat, weet je niet of je Apache 2.0 krijgt, een restrictieve communitylicentie of iets met territoriale clausules dat het onbruikbaar maakt voor je klanten. Een model van 2,4T onder een restrictieve communitylicentie is technisch nog steeds "open weights", terwijl het volledig verandert wat je mag uitbrengen.
Drie: bij 2,4 biljoen parameters betekent "je kunt het downloaden" bijna niets voor een startup. Dit model serveren vraagt minimaal acht GPU's van H100- of B200-klasse. Dat is geen laptop, geen workstation en geen losse cloudinstantie die je opstart om iets te proberen. Voor het overgrote deel van de teams veranderen de open weights operationeel niets: je gebruikt de API, precies zoals bij een gesloten model. Wat de weights echt opleveren, is optionaliteit voor grote bedrijven met eisen rond dataresidentie, en een basis voor het distillatie- en fine-tuningwerk dat de modellen gaat opleveren die je uiteindelijk draait.
Daarom is de 27B het interessante checkpoint. Dat is het model dat draait op hardware die een startup bezit, dat je op je codebase kunt fine-tunen, dat voor je marges kan tellen. En het heeft op dit moment helemaal geen gepubliceerde specificatie. Als Qwen3.8 voor je bedrijf gaat tellen, dan waarschijnlijk via dat model — let dus op de modelkaart van de 27B, niet op de kop over de Max.
reasoning_effort — zonder waarschuwing en zonder effect. Als je harness verzoeken in OpenAI-vorm stuurt, configureer je misschien niets terwijl je denkt iets te hebben ingesteld. Controleer dat het gedrag verandert als je de parameter verandert; vertrouw niet op het ontbreken van een foutmelding.Gezien de vorm van het bewijs is dit wat ik echt zou doen.
De verleiding bij een release van deze omvang is om hem te lezen als een update van het scorebord. Nuttiger is hem te lezen als aanwijzing waar de concurrentie naartoe is verschoven.
Twee jaar lang concurreerden de Chinese labs op prijs, en de strategische vraag voor founders was hoe ver de bodem zou zakken. Alibaba weigerde dat spel nu met zijn vlaggenschip. Het prijsde gelijk, maakte de weights open van een model dat bijna niemand zelf kan hosten, en richtte de hele release op agentworkloads voor bedrijven — kantoortaken, documentverwerking, werk met lange context, het naleven van instructies. DeepSeek drukt de bodem nog steeds omlaag; Alibaba concurreert om het plafond. Dat zijn verschillende oorlogen, en ze worden nu tegelijk gevoerd.
In de praktijk betekent dat dat de modellaag op elk prijspunt capabeler blijft worden en zich steeds minder onderscheidt. Qwen3.8-Max wordt binnen een kwartaal verslagen, waarschijnlijk door iets uit dezelfde familie. De routeringsbeslissing die je deze week neemt, is binnen twee kwartalen verkeerd. Dat is geen reden om releases te negeren — het is een reden om zo te bouwen dat erop reageren goedkoop is: een gateway in plaats van een vastgezette SDK, een evaluatieset in plaats van een onderbuikgevoel, prompts die zijn opgebouwd voor hergebruik van de cache in plaats van ad hoc in elkaar gezet.
En het is de moeite waard om te zien wat de verdeelde benchmarks daarover zeggen. De gaten zitten niet in pure intelligentie — GPQA Diamond op 92,6 is frontierniveau. De gaten zitten in agentisch softwarewerk met een lange horizon, de taken waarbij het model een plan over veertig stappen moet vasthouden en moet herstellen van zijn eigen fouten. Dat is hetzelfde gat waar founders een niveau hoger in de stack tegenaan lopen, als de demo werkt en productie niet. Naar welk model je ook routeert, dat blijft het werk dat van jou is.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.