DeepSeek V4-Flash is officieel en verslaat zijn eigen vlaggenschip: een gids voor founders (2026)

By Surya Pratap
4 augustus 2026
13 min read
AI & Technology

4 augustus 2026
13 min read
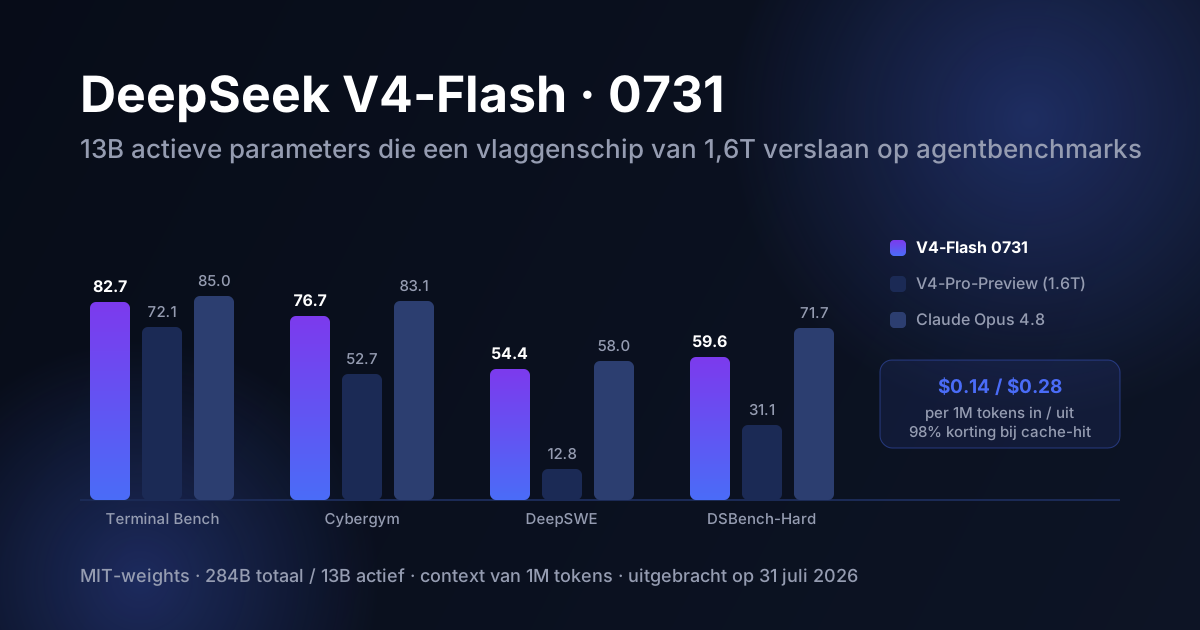
Op 31 juli haalde DeepSeek V4-Flash uit de preview. Op papier is dit het minst interessante soort release: geen nieuwe architectuur, geen nieuw aantal parameters, geen nieuw contextvenster. Het model kwam uit met precies hetzelfde 284B/13B mixture-of-experts-lichaam als in april. Wat veranderde, was de post-training.
En dat opnieuw getrainde kleine model scoort nu hoger dan het eigen vlaggenschip van DeepSeek, de V4-Pro-Preview met 1,6 biljoen parameters, op alle negen gepubliceerde agentbenchmarks — met marges tussen 8,7 en 41,6 punten. Het kost $0,14 per miljoen inputtokens en $0,28 per miljoen outputtokens. Het heeft een MIT-licentie. Je kunt de weights downloaden.
Er zit hier een echte les in voor iedereen die een AI-product bouwt, en die luidt niet "stap over op DeepSeek". Ze gaat over waar capaciteit in 2026 werkelijk vandaan komt, en wat dat doet met de aanname — nog steeds ingebakken in de kostenmodellen van de meeste founders — dat beter agentgedrag een groter, duurder model vereist.
De changelogregel is kort en het waard om letterlijk te lezen. Het endpoint deepseek-v4-flash serveert nu de 0731-build. Architectuur en omvang zijn ongewijzigd ten opzichte van de preview; het model kreeg opnieuw post-training, met een DSpark-module voor speculatieve decodering voor meer doorvoer. Het kreeg native ondersteuning voor het formaat van de Responses API van OpenAI en een Codex-aanpassing vanaf dag één. De redeneercontrole werd uitgebreid naar drie expliciete niveaus — low, high, max — en dat is de vorm die agent-harnesses verwachten van reasoning_effort.
De specificaties eronder: 284B parameters in totaal waarvan 13B geactiveerd, een contextvenster van 1M tokens met tot 384.000 outputtokens, een hybride attention-stack die gecomprimeerde sparse attention combineert met sterk gecomprimeerde attention, experts in FP4 en FP8 elders, en ongeveer 167 GB aan weights op schijf onder een MIT-licentie. De oude identifiers deepseek-chat en deepseek-reasoner zijn op 24 juli uitgefaseerd, dus alleen de twee V4-endpoints werken nog.
De commerciële context telt ook. DeepSeek haalde $7,4 miljard op tegen een waardering van ongeveer 350 miljard yuan, met deelname van Tencent en NetEase, en zei dat het geld gaat naar ruwweg een verdubbeling van het personeelsbestand, met de nadruk op agents. De previewbuild van Flash was al zeven weken op rij het meest gebruikte model op OpenRouter. Dit is geen lab dat een curiositeit uitbrengt.
Dit zijn de gepubliceerde agentcijfers, met de previewbuild erbij zodat je ziet hoeveel van de winst uit post-training komt en niet uit marketing.
| Benchmark | Flash 0731 | Flash Preview | V4-Pro-Preview | Opus 4.8 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 | 85,0 |
| Cybergym | 76,7 | 38,7 | 52,7 | 83,1 |
| DeepSWE | 54,4 | 7,3 | 12,8 | 58,0 |
| NL2Repo | 54,2 | 39,4 | 38,5 | 69,7 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 | 76,2 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 | 71,6 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 | 71,7 |
| Agents' Last Exam | 25,2 | 15,8 | 16,5 | 25,7 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 | 27,2 |
Twee dingen springen eruit. Het eerste is DeepSWE: van 7,3 naar 54,4 met identieke weights. Zo'n grote sprong betekent meestal dat het previewmodel de taak wel kon, maar nooit de harness had geleerd — het faalde op formaat, discipline bij toolaanroepen en weten wanneer te stoppen, niet op redeneren. Post-training repareerde de interface, en de capaciteit die er al zat, kwam tevoorschijn.
Het tweede is de kolom van Opus 4.8. Flash 0731 komt dichtbij op Terminal Bench (82,7 tegen 85,0), Agents' Last Exam (25,2 tegen 25,7) en DeepSWE (54,4 tegen 58,0) — en ligt duidelijk achter op de twee moeilijkste: NL2Repo (54,2 tegen 69,7) en DSBench-Hard (59,6 tegen 71,7). Dat patroon is consistent en het is het patroon dat je routering moet sturen. De kloof sluit zich bij afgebakende, goed gespecificeerde agenttaken. Ze blijft open bij lang, ambigu werk over de hele repository, waar één slechte beslissing bij stap 40 je de run kost.
Onafhankelijke metingen komen ongeveer overeen. Artificial Analysis zet V4-Flash 0731 op 50 in zijn Intelligence Index — derde onder de open-weightmodellen, tegenover een mediaan van 25, gelijk met Gemini 3.6 Flash en achter Claude Opus 5 met ongeveer 59. De outputsnelheid is 113,5 tokens per seconde tegenover een mediaan van 61,4 bij vergelijkbare modellen, met een tijd tot het eerste token van 1,31 seconde.
Benchmarks halen de krantenkoppen; de prijsregel bepaalt wat je kunt bouwen. Artificial Analysis mat wat het kost om de volledige reeks van zijn Intelligence Index door elk model te halen:
Dat is een verschil van ongeveer een factor honderd voor een capaciteitskloof van negen punten op een index van honderd. De cache-economie is nog agressiever: een cache-hit kost $0,003 per miljoen tokens, een korting van 98% en de grootste in de sector. Als je agent elke turn een grote, stabiele systeemprompt en een vast corpus opnieuw afspeelt — en dat doen de meeste agents in productie — is die korting geen afrondingsfout, maar het verschil tussen een workflow die je in een abonnement van $29 kunt aanbieden en een die je helemaal niet kunt aanbieden.
DeepSeek verlaagde met deze release ook de API-kosten met tot 50%, en het patroon is inmiddels bekend genoeg dat Axios het omschreef als een race naar nul, met de opmerking dat de onophoudelijke kortingen van Chinese labs de toekomstige IPO's van OpenAI en Anthropic onder druk zetten. Of die stelling nu klopt of niet, het operationele gevolg voor jou is direct: de bodemprijs voor competent agentisch werk is opnieuw gezakt, en elk prijsmodel dat je bouwde op de aanname dat inferentie duur is, gaat minder lang mee dan je had gepland.
De breedsprakigheidstaks
Artificial Analysis bestempelt V4-Flash als "zeer breedsprakig" — het verbruikte 210M outputtokens in hun evaluatie tegenover een mediaan van 100M bij vergelijkbare modellen. Outputtokens zijn de dure helft van de rekening. Een model met een tiende van de outputprijs dat twee keer zoveel tokens uitspuugt, levert een besparing van een factor vijf op, niet tien, en je werkelijke verhouding hangt af van je prompts. Meet de kosten per voltooide taak op je eigen traces, niet de kosten per miljoen tokens van een prijspagina.
Twee: piekprijzen. DeepSeek heeft een vermenigvuldiger van 2× aangekondigd tussen 09:00 en 12:00 en tussen 14:00 en 18:00 Pekingse tijd. Die gold nog niet bij de release, maar als je verkeer vooral in de Europese of Amerikaanse ochtend valt, reken dan met het vermenigvuldigde tarief in plaats van het aangekondigde voordat je een marge aan een klant toezegt.
Drie, en het minst besproken: dit zijn agentbenchmarks, en agentbenchmarks belonen precies datgene waarop net is getraind. Een sprong van 41 punten op DeepSWE door alleen opnieuw post-trainen zou je iets wantrouwiger moeten maken tegenover de benchmark, niet alleen meer onder de indruk van het model. Het vertelt je dat de score heel gevoelig is voor hoe goed het model bij de harness past. Jouw harness is niet de hunne. Draai je eigen evaluatieset — de kleine, opgebouwd uit echte gebruikerstaken — voordat je productieverkeer ergens nieuw naartoe routeert.
De vergelijking is niet helemaal eerlijk, en begrijpen waarom is het nuttige deel. Flash 0731 is een afgewerkt, op agents afgestemd product. V4-Pro-Preview is een preview — een demonstratie van basiscapaciteit die niet dezelfde behandeling heeft gekregen. DeepSeek zegt dat de officiële release van V4-Pro op handen is, met ondersteuning voor de Responses API en Codex begin augustus, en als die er is, draait de volgorde vrijwel zeker weer om.
Maar "de vergelijking is niet eerlijk" is de bevinding. Wat de twee modellen op negen benchmarks scheidde, waren niet anderhalf biljoen parameters extra aan ruwe capaciteit. Het was de vraag of iemand het model had geleerd hoe het zich in een agentloop moet gedragen: wanneer het een tool aanroept, hoe het die aanroep opmaakt, wanneer het stopt met redeneren en gaat handelen, hoe het herstelt van een mislukte stap. Schaal kocht het onderliggende vermogen. Post-training zette dat om in voltooide taken.
Dat sluit vrijwel precies aan bij wat founders een niveau hoger in de stack steeds weer ontdekken. De demo werkt omdat het model capabel is. Productie faalt omdat niets rond het model een loop betrouwbaar kan draaien — dezelfde reden waarom context engineering, evaluatiesets en rechtensystemen steeds belangrijker blijken dan welk frontiermodel je koos. DeepSeek liet precies hetzelfde principe zien binnen de weights zelf.
V4-Pro is de broer van 1,6T, op 24 april uitgebracht als open-weightpreview onder MIT en geprijsd op $0,435/$0,87 per miljoen tokens. Het scoort ongeveer 80,6 op SWE-bench Verified in de stand voor maximaal redeneren — competitief, niet leidend. Het architectuurverhaal is op efficiëntie echt indrukwekkend: bij een context van 1M tokens heeft V4-Pro naar verluidt ongeveer 27% van de inferentie-FLOPs per token nodig en 10% van de KV-cache die V3.2 vereiste, en dat maakt een context van een miljoen tokens economisch haalbaar in plaats van alleen geadverteerd.
Eén kostenvergelijking uit een analyse van iemand uit de praktijk is het onthouden waard: een representatieve, middelgrote feature implementeren kost ongeveer $0,12 op V4-Pro tegenover ongeveer $10,00 op een premium frontierlaag. Zelfs na aftrek van de breedsprakigheidskanttekening en welk faalpercentage je ook ziet, is dat een andere categorie unit economics — en het is de reden dat "gebruik voor alles het beste model" ongeveer een jaar geleden ophield een verdedigbare standaard te zijn.
De verleiding bij een release als deze is om die te zien als koopsignaal voor één leverancier. Dat is het niet. DeepSeek loopt achter Kimi K3 van Moonshot met 2,8 biljoen parameters, Kimi wordt in oktober door iets anders onderboden, en het goedkoopste competente model van een bepaalde maand is een bewegend doel waarop je nooit de identiteit van een product moet bouwen.
Wat blijvend is, is de richting. Capaciteit tegen een bepaalde prijs daalt snel, de open-weightlaag zit nu zo dicht bij de frontier op afgebakend agentwerk dat de keuze een routeringsbeslissing is in plaats van een kwaliteitsbeslissing, en de marginale kosten van de modellaag gaan richting de bodem. Als het voordeel van je product is dat je toegang hebt tot een goed model, dan wordt dat voordeel in het openbaar weggeprijsd, release na release.
Het voordeel dat overblijft, is precies wat DeepSeek net heeft bewezen dat ertoe doet: het werk om een capabel systeem betrouwbaar te maken binnen een specifieke loop, in een specifiek domein, voor een specifieke gebruiker. Dat was het verschil tussen 7,3 en 54,4 met dezelfde weights. Het is ook, min of meer precies, het verschil tussen een AI-demo en een AI-bedrijf.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.