12月1日、gemini-2.5-proへの呼び出しはGemini 3.8 Flashで動くようになる。Googleに切り替えられる前に、モデル名を自分で変えよう

By Surya Pratap
2026年11月19日
8 min read
AI & Technology

2026年11月19日
8 min read
 ルーティング先と、最初にやることを見るHover to explore
モデルの非推奨化は、たいていエラーで終わる。リクエストが失敗し、アラートが鳴り、移行する。ところがGoogleは、最もよく使われている2つのモデルについて別の終わり方を選んだ。12月1日から、gemini-2.5-proとgemini-2.5-flashへのリクエストは失敗しない。別のモデルが答え、そのモデルの料金で課金される。コードは古いモデルを指定したままだ。誰も知らせてはくれない。だからこそ、今週のうちに手を打つ必要がある。
Googleは11月2日、両モデルを非推奨とし、どちらにも同じ期日を設定した。
gemini-2.5-pro。「2026年12月1日から、gemini-2.5-proへのAPIリクエストはすべて自動的にgemini-3.8-flashにルーティングされ、Gemini 3.8 Flashの料金で課金される」。Google AI Studioのモデル選択からはすでに消えている。gemini-2.5-flash。 同じ日から、リクエストは「自動的にgemini-3.5-flash-liteにルーティングされ、Gemini 3.5 Flash-Liteの料金で課金される」。gemini-2.5-flash-lite。 非推奨ではない。Googleによれば「追って通知があるまでAPIで引き続き利用できる」。thought_signatureの検証、thinking_budgetに代わるthinking_level、サンプリングパラメータと事前入力されたモデルターンの廃止」が含まれる。Googleの助言は明快だ。12月1日より前にモデル名を更新し、新しいモデルの移行ガイドを読むこと。
エラーを返す非推奨化は目立つ。数分で気づく。ルーティングする非推奨化は静かだ。ログには成功したレスポンスが並び、ダッシュボードは緑のまま。手がかりは、見ていなかった場所にしか現れない。いつもと違う調子の回答、ある機能が「悪くなった」というサポートチケット、動いたコストの1行。
それぞれのルートが何をするかを見てほしい。gemini-2.5-proはProモデルで、代わりに入るのはFlashモデルだ。gemini-2.5-flashはFlash-Liteモデルに移る。新しく小さいモデルで大半のトラフィックには十分だ、というGoogleの見立ては正しいのかもしれない。だが「大半のトラフィック」はGoogleの平均であって、あなたのプロダクトではない。安いモデルがテストに通らなかったから2.5 Proを選んだのなら、12月1日はその判断を、あなたに尋ねることなく覆す。
エラーになる非推奨化は、起きたことを教えてくれる。ルーティングする非推奨化は、見ている人にしか教えてくれない。
モデルが変わる。 ルーティングされたリクエストにはgemini-3.8-flashかgemini-3.5-flash-liteが答える。どちらも最大1,048,576トークンを読み、最大65,536トークンを書けるので、コンテキストの上限は問題にならない。未知数なのは、自社のタスクでの品質だ。
既定値が変わる。 Googleの思考レベルの表では、gemini-3.5-flash-liteの既定はminimal、gemini-3.8-flashの既定はmediumとなっている。3.8 Flashについて、Googleは「minimalはサポートされず、エラーを返す」と記している。思考レベルを明示的に設定したことがなければ、回答の裏にある推論の量がひとりでに変わる。
APIの契約が変わる。 破壊的変更は見た目だけの話ではない。thinking_levelがthinking_budgetに取って代わる。関数呼び出しではthought_signatureが検証されるようになる。サンプリングパラメータは廃止され、事前入力されたモデルターンも使えなくなる。古いパラメータを送り続けるルーティング後のリクエストがどうなるのか、つまりエラーになるのか、黙って無視されるのかを、Googleは書いていない。どちらにせよ、ユーザーより先に知っておきたい。
請求が変わる。 リクエストは新しいモデルの料金で課金される。計算は次のセクションにあり、そこには2つ目の期日がある。
Googleの料金ページによる、100万トークンあたりの価格は次のとおりだ。
| 現在のgemini-2.5-pro | 12月31日までのgemini-3.8-flash | 2027年1月1日からのgemini-3.8-flash | |
|---|---|---|---|
| 入力(プロンプト20万トークン以下) | $1.25 | $0.75 | $1.50 |
| 入力(プロンプト20万トークン超) | $2.50 | $0.75 | $1.50 |
| 出力(プロンプト20万トークン以下) | $10.00 | $3.75 | $7.50 |
| 出力(プロンプト20万トークン超) | $15.00 | $3.75 | $7.50 |
3.8 Flashは12月31日まで導入価格だ。入力50,000トークン、出力5,000トークンのエージェントの1ステップで考える。2.5 Proでは約**$0.11**。12月にルーティングされると約**$0.06**。1月からは再び約**$0.11になる。入力の多いステップ、たとえば入力150,000トークン、出力2,000トークンなら、現在は約$0.21**、12月は**$0.12**、1月は**$0.24**で、今より高くなる。
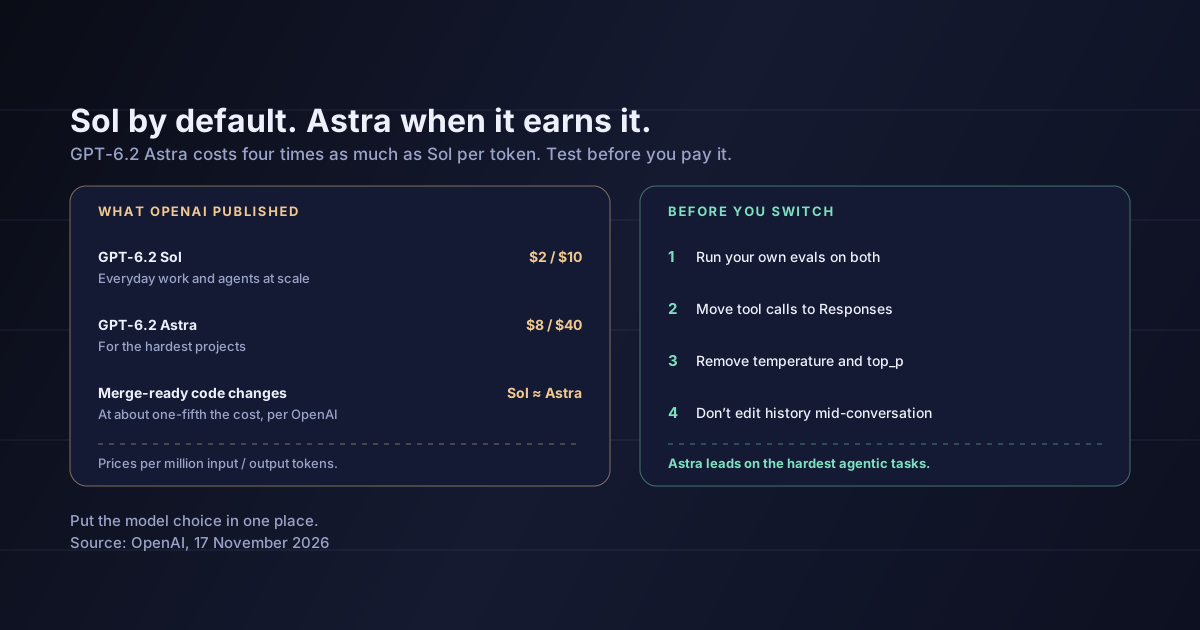
gemini-2.5-flashの価格は変わらない。2.5 Flashも3.5 Flash-Liteも、入力100万トークンあたり$0.30、出力100万トークンあたり$2.50と記載されている。同じ料金で、より小さいモデルを使うことになる。
# gemini_call.py — choose the model explicitly and log what served it
import logging
from google import genai
from google.genai import types

log = logging.getLogger("llm")
client = genai.Client()

MODEL = "gemini-3.8-flash"   # was "gemini-2.5-pro": change it before 1 December

def ask(prompt: str) -> str:
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            # thinking_level replaces thinking_budget on Gemini 3 models
            thinking_config=types.ThinkingConfig(thinking_level="medium"),
        ),
    )
    # modelVersion: "the model version used to generate the response"
    log.info("requested=%s served=%s", MODEL, resp.model_version)
    return resp.text
名前は自分で変える。 コード、設定、プロンプトのリポジトリ、ノーコードツールのすべてでgemini-2.5-proとgemini-2.5-flashを探す。自分で決めた日に移行すれば、テストも段階的な展開もロールバックもできる。Googleの期日にルーティングされるのでは、そのどれもできない。
後継モデルと、その代替案をテストする。 自社の評価セットを、gemini-3.8-flashまたはgemini-3.5-flash-liteで思考レベルごとに実行する。ProレベルのタスクがFlashで失敗するなら、ルーティングを受け入れずに、より大きなモデルを試す。Googleが用意した後継が唯一の選択肢ではない。
破壊的変更を先に直す。 thinking_budgetをthinking_levelに置き換える。サンプリングパラメータと事前入力されたモデルターンを取り除く。関数呼び出しのコードを、新しいthought_signatureの検証に照らして確認する。ツール呼び出しのテストは、単発のプロンプトではなく端から端まで通しで実行する。
すべての呼び出しでmodelVersionを記録する。 APIリファレンスは、レスポンスのmodelVersionフィールドを「レスポンスの生成に使われたモデルのバージョン」と説明している。指定したモデルと並べて記録しておく。両者が食い違えば、翌月の請求書ではなく、その日のうちに気づける。
同じ日に、別の価格も変わる
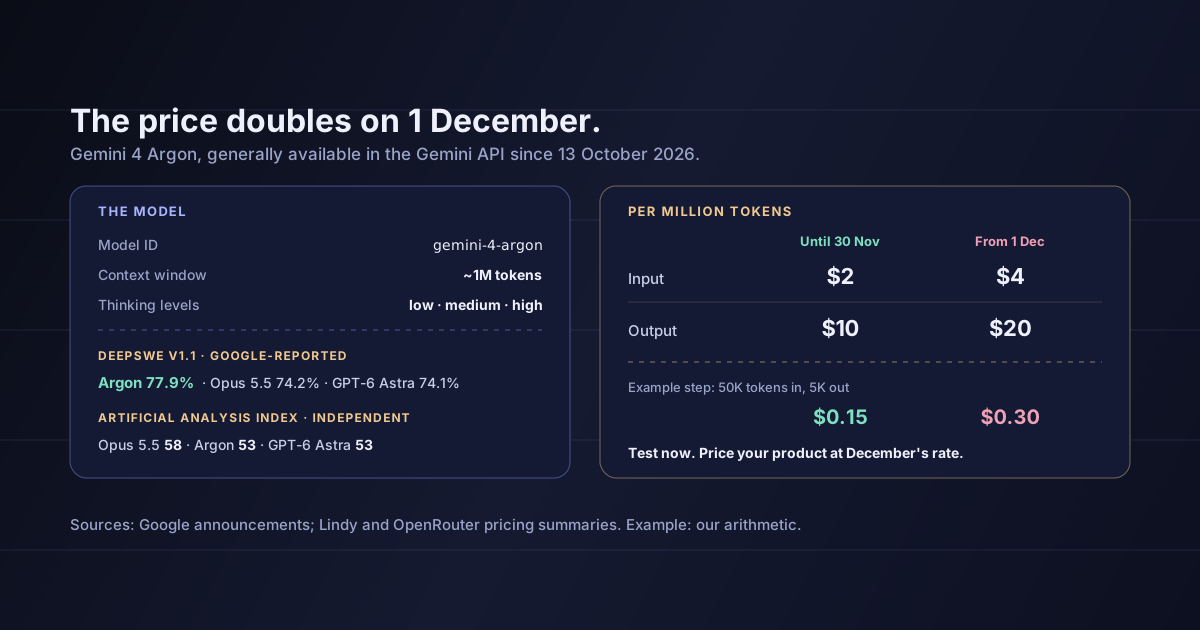
12月1日は、Gemini 4 Carbonの導入価格が終わる日でもある。Googleの料金ページでは、11月30日までは入力100万トークンあたり$2、出力100万トークンあたり$10で、その後は$4と$20になる。導入期間中に何かをCarbonやArgonに移したなら、その利益率も見直してほしい。同じ計算をGemini 4 Argonについても行っている。
3.8 Flashが、あなたにとって2.5 Proより劣るということ。 3.8 Flashのほうが新しく、多くのタスクではむしろ優れているかもしれない。同じタスクで両者を直接比べた結果をGoogleが公開しているのは見ていない。決めるのは自社の評価セットだ。
Vertex AIで何が起きるか。 筆者が読んだchangelog、非推奨ページ、料金ページは、Google AI StudioのGemini APIを対象としている。Vertex AIには触れていない。Vertex経由でGeminiを呼んでいるなら、Vertex側の非推奨スケジュールを確認してほしい。
ルーティングされたリクエストが古いパラメータをどう扱うか。 Googleは破壊的変更を挙げているが、thinking_budgetを送るルーティング後のリクエストが失敗するのか、黙って調整されるのかは書いていない。推測せずに試すこと。
期日が確定しているということ。 Googleの非推奨ページは、提供終了日を「モデルが廃止される可能性のある最も早い日」としている。後ろにずれることはありうる。それでも12月1日を前提に計画するのが安全だ。
2026年12月1日から、gemini-2.5-pro宛てのGemini APIリクエストにはgemini-3.8-flashが答え、その料金で課金される。gemini-2.5-flash宛てのリクエストにはgemini-3.5-flash-liteが答え、価格は変わらない。gemini-2.5-flash-liteは影響を受けない。Googleはこの移行に伴う破壊的なAPI変更を挙げており、thinking_budgetに代わるthinking_level、関数呼び出しの新しい検証、サンプリングパラメータと事前入力ターンの廃止が含まれる。3.8 Flashは12月31日までは2.5 Proより安いが、1月1日から価格が2倍になり、入力の多い処理は今より高くつく。
リスクは新しいモデルそのものではない。エラーも、判断も、テストもないまま変更が起きることだ。
12月1日より前に、すべてのgemini-2.5-proとgemini-2.5-flashをテスト済みのモデルに置き換え、破壊的変更を直し、modelVersionの記録を始めよう。そうすれば、どのリクエストにどのモデルが答えたかがわかる。
出典:Google AI Studio、Gemini APIのchangelog、2026年11月2日の記載。gemini-2.5-proとgemini-2.5-flashの非推奨化、2026年12月1日からの自動ルーティングと課金、破壊的なAPI変更の一覧。非推奨:リリース日と提供終了日、gemini-2.5-flash-liteの状況、提供終了日は最も早い可能性のある日であるという注記。料金:gemini-2.5-pro、gemini-2.5-flash、gemini-3.8-flash、gemini-3.5-flash-lite、Gemini 4 Carbonの価格。Gemini 3.8 FlashとGemini 3.5 Flash-Lite:トークン上限と思考レベル。generateContentのAPIリファレンス:レスポンスのmodelVersionフィールド。いずれも2026年11月19日に確認。コストの例とセクション2〜6の解釈は筆者のもの。
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.