Un tuteur IA a égalé des tuteurs humains experts pour 1/918e du coût. C'était le modèle le moins cher testé

By Surya Pratap
2 octobre 2026
9 min read
AI & Technology

2 octobre 2026
9 min read
 Le prix au point, pas au tokenHover to explore
La plupart des comparaisons entre modèles d'IA portent sur ce que les modèles savent faire. Celle-ci porte sur ce qu'ont appris les personnes qui les ont utilisés, mesuré avant et après, face à un groupe témoin et face à des enseignants humains experts. Son résultat le plus utile pour les fondateurs n'a rien à voir avec l'éducation.
Tout ce qui suit provient de « StudentBench: AI and human tutoring yield equivalent GRE learning gains », de Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner et Jonas Mueller, de Handshake AI Research, une prépublication mise en ligne le 23 septembre 2026 et révisée le 30 septembre. Les données anonymisées sont en accès libre. Handshake exploite aussi la plateforme de tutorat StudentBench utilisée par l'étude. L'interprétation, à partir de la section 3, est la mienne.
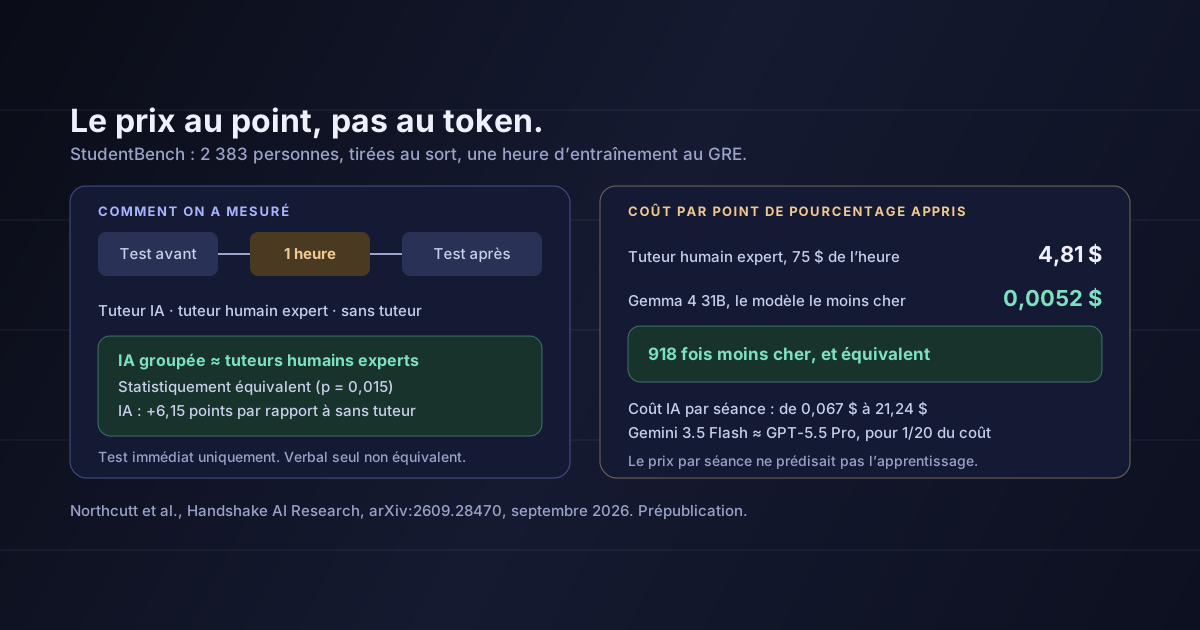
L'étude a recruté 2 383 adultes, pour la plupart âgés de 18 à 24 ans, pour préparer le GRE, un examen d'admission aux études supérieures. Chaque séance suivait le même schéma :
Le gain d'apprentissage correspondait au score du test final moins celui du test préalable, en points de pourcentage. Les tuteurs humains étaient d'anciens rédacteurs de questions du GRE ou des tuteurs ayant au moins cinq ans d'expérience, et ils n'avaient pas accès aux questions du test final.
Le tutorat par IA, pris dans son ensemble, s'est révélé statistiquement équivalent au tutorat par des experts humains sur les gains au GRE (p = 0,015, dans une marge d'un quart d'écart type). L'écart moyen entre IA et humains était de −0,58 point de pourcentage. Les deux ont fait mieux que l'absence de tutorat : le tutorat par IA a ajouté 6,15 points par rapport au groupe témoin.
Six des tuteurs IA ont passé individuellement le test d'équivalence face aux tuteurs humains. Dans cinq des sept domaines du GRE, le meilleur tuteur IA a fait mieux en moyenne que les tuteurs humains.
Vient ensuite le coût.
Le prix d'un modèle ne disait presque rien de ce qu'un étudiant apprendrait avec lui. Seule la mesure de l'apprentissage le disait.
C'est la leçon qui dépasse le tutorat. Les auteurs n'ont pas comparé les modèles sur un benchmark ni sur le prix par token. Ils les ont comparés sur le coût par unité du résultat que le produit est censé produire : ici, des dollars par point de pourcentage d'apprentissage.
Vu sous cet angle, le classement des modèles change. Un modèle 300 fois plus cher par séance ne vaut le coup que s'il produit 300 fois plus de ce que vous vendez, et dans cette étude, le haut de gamme ne l'a pas fait.
La plupart des produits d'IA sont tarifés et construits à l'envers. L'équipe choisit un modèle puissant et cher parce que cela rassure, mesure le coût par appel, et ne mesure jamais ce que chaque appel apporte à l'utilisateur. Sans le résultat, impossible de savoir si un modèle vingt fois moins cher ferait aussi bien l'affaire.
Un résultat secondaire passe facilement inaperçu. Sur les séances de la partie quantitative, des réponses plus rapides de l'IA étaient associées à davantage de messages des étudiants ; davantage de messages, à davantage d'exercices réussis ; et davantage d'exercices réussis, à des gains d'apprentissage plus importants (tous avec p < 0,002).
C'est une corrélation, pas une expérience contrôlée, et les auteurs la présentent comme telle. Mais elle pointe quelque chose que les fondateurs sous-estiment souvent : dans un produit interactif, la latence n'est pas un détail technique. Si un modèle plus lent et plus intelligent signifie moins d'échanges d'entraînement, l'utilisateur peut finir par apprendre — ou obtenir — moins, et non plus.
Ce que StudentBench a de plus précieux pour un fondateur, c'est sa façon de mesurer, et l'essentiel du protocole est peu coûteux à reproduire.
Mesurez avant et après. Définissez le résultat que votre produit fait évoluer et mesurez-le au début et à la fin d'une séance. Les scores de satisfaction et le temps passé dans l'application ne sont pas des résultats.
Gardez un groupe témoin sans IA. Sans lui, impossible de savoir quelle part de l'amélioration revient à votre produit et quelle part se serait produite de toute façon. Ici, même l'absence de tuteur a produit un peu de gain.
Comparez les modèles sur les mêmes utilisateurs. Répartissez au hasard les utilisateurs entre deux ou trois modèles et comparez les résultats, pas seulement les coûts. Un modèle moins cher qui s'avère équivalent, c'est une décision de marge brute qui n'attend que d'être prise.
Divisez le coût par le résultat. Exprimez le coût par unité de résultat — par ticket résolu, par bonne réponse, par point appris — et prenez vos décisions de modèle sur ce chiffre.
Pour les équipes qui achètent ou animent des formations à l'IA, le résultat est encourageant, mais dans un périmètre étroit. Pour l'entraînement de type exercice, avec des réponses clairement justes, un tuteur IA peut égaler un expert humain sur une séance, pour une infime fraction du coût. Il est donc pertinent d'utiliser des tuteurs IA pour s'entraîner entre les séances en direct.
Cela ne montre pas que l'IA remplace un enseignant humain. L'étude a mesuré une heure et un test immédiat. Les gains durent-ils, et le tutorat par IA fonctionne-t-il aussi bien pour des compétences ouvertes ? Ce sont des questions qu'elle ne s'est pas posées.
C'est une prépublication de l'entreprise qui exploite la plateforme. Handshake AI Research a mené l'étude sur le service StudentBench de Handshake. Les données ont été publiées en accès libre, ce qui aide, mais elles n'ont pas été relues par des pairs.
Le groupe avec tuteurs humains était petit. Environ 140 séances avec un tuteur humain contre plus de 2 100 avec l'IA. L'équivalence a été établie pour l'IA dans son ensemble ; les comparaisons individuelles reposent sur moins de données.
La partie verbale n'a pas établi d'équivalence à elle seule. Le résultat global combine les sections quantitative et verbale. Sur la partie verbale seule, l'équivalence n'a pas été démontrée, et les tuteurs humains ont obtenu le gain moyen le plus élevé dans les trois domaines verbaux.
Les gains sont immédiats. Aucun test différé n'a été réalisé. Un apprentissage visible une heure plus tard peut ne plus l'être un mois plus tard, dans un groupe comme dans l'autre.
Le coût humain est un tarif de référence. Le chiffre de 4,81 dollars repose sur un tarif publié de 75 dollars de l'heure tiré d'une source de 2018. Les prix réels du tutorat varient beaucoup, ce qui change le multiple, mais pas le sens.
Je n'ai pas vérifié le résultat individuel de chaque modèle. L'article ne donne certains chiffres que dans des graphiques. Je n'ai utilisé que les résultats énoncés dans le texte.
StudentBench est l'une des comparaisons les plus rigoureuses à ce jour entre l'enseignement par IA et l'enseignement humain : randomisée, contrôlée, avec des tuteurs humains experts et des données ouvertes. Pour une heure d'entraînement au GRE, le tutorat par IA a été aussi efficace qu'un expert humain, et le modèle le moins cher testé figurait parmi ceux qui les ont égalés.
Pour les fondateurs, la leçon la plus durable tient à la méthode. Les auteurs ont choisi leurs modèles au coût par unité du résultat qui comptait pour eux, et ont mesuré ce résultat face à un groupe témoin. Cela a placé un modèle à 0,067 dollar au niveau d'experts humains, et a montré que l'option la plus chère n'était pas celle à retenir.
Avant de choisir un modèle sur son prix ou sa réputation, mesurez ce que chacun produit réellement pour vos utilisateurs, et divisez le coût par ce résultat.
Source : Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner et Jonas Mueller, « StudentBench: AI and human tutoring yield equivalent GRE learning gains », arXiv:2609.28470, v1 du 23 septembre 2026, v2 du 30 septembre 2026 — les 2 383 participants, le protocole test préalable, heure de condition et test final parallèle, les 13 configurations de tuteur IA par section et les tuteurs humains experts, le résultat d'équivalence global (p = 0,015), l'écart de −0,58 point, le gain de 6,15 points par rapport au groupe témoin, les six équivalences individuelles, le résultat dans cinq domaines sur sept, les coûts par séance de 0,067 et 21,24 dollars, l'équivalence de Gemma 4 31B (p = 0,044) et ses 0,0052 dollar contre 4,81 par point de pourcentage à 75 dollars de l'heure, la comparaison entre Gemini 3.5 Flash et GPT-5.5 Pro, les corrélations entre latence et engagement, la taille des groupes, le résultat sur la seule partie verbale et les limites déclarées, tels que publiés. Données anonymisées et code : StudentBench sur GitHub. L'interprétation des sections 3 à 6 est la mienne. Sur les raisons pour lesquelles les petits modèles l'emportent souvent sur des tâches étroites, voir l'essentiel de ce que votre agent demande à un LLM est un oui ou un non. Sur le problème du temps dans la formation à l'IA en entreprise, voir la formation à l'IA a plus que doublé ; 56 % n'ont pas le temps de la suivre.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.