L'essentiel de ce que votre agent demande à un LLM est un oui ou un non

By Surya Pratap
21 septembre 2026
11 min read
AI & Technology

21 septembre 2026
11 min read
 Quatre décisions et une phraseHover to explore
De temps à autre, un lancement mérite d'être lu pour sa prémisse plutôt que pour ses mesures. Celui-ci a une prémisse qui me paraît juste et des chiffres que personne hors de l'entreprise n'a contrôlés, combinaison peu courante qu'il faut séparer soigneusement.
Cet article part de « Building a harness with Jev » de LangChain, par Sydney Runkle et Hunter Lovell, publié le 17 septembre 2026 ; de l'annonce de TypeSafe AI elle-même ; d'un guide pratique de l'API ; et de la lecture sceptique de MindStudio. Tous les chiffres de performance ci-dessous sont ceux de TypeSafe. La section 7 dit ce que cela implique. L'argument à partir de la section 2 est le mien.
TypeSafe AI a publié Jev, qu'elle appelle un modèle System One : une classe qu'elle définit comme des modèles conçus pour prendre des décisions rapides et structurées que le logiciel consomme directement, plutôt que pour générer du texte. LangChain a publié un harness bâti dessus la même semaine.
La forme de la chose : vous lui remettez un état et un ensemble de questions typées, et il répond à toutes en une passe, probabilités à l'appui. Trois types de question :
Choice — choisir parmi 255 options au plus, avec une probabilité par optionScore — placer l'entrée sur une échelle ordonnée de 2 à 10 niveauxNoul — un oui ou un non, renvoyé sous forme d'un seul nombre entre 0 et 1from typesafe_sdk import Choice, Noul, TypeSafeClient
client = TypeSafeClient()
response = client.system_one(
state={"ticket": "I was charged twice"},
questions={
"department": Choice(
instructions="Which team handles this",
criteria={"billing": "Payment issues", "technical": "Bugs"},
),
"urgent": Noul(instructions="Message conveys urgency"),
},
)
Deux différences d'architecture font le travail. Le modèle échantillonne toutes les sorties en une seule requête, en parallèle plutôt que de façon autorégressive, d'où vient l'affirmation sur la latence. Et il est entraîné avec ce que TypeSafe appelle RLCD, apprentissage par renforcement pour décisions calibrées, qui n'optimise pas pour une réponse qu'un évaluateur humain approuve, mais pour une réponse assortie d'une probabilité qui reflète la fréquence à laquelle cette réponse est juste.
Les chiffres publiés : 70 à 500 ms de bout en bout, 0,042 dollar par million de tokens d'entrée, sortie gratuite, et sur les évaluations de flux de l'entreprise elle-même 193,6× plus rapide et 444,6× moins cher que les modèles de frontière comparés. Le contexte est plafonné à 64k tokens au total, 32k pour l'état.
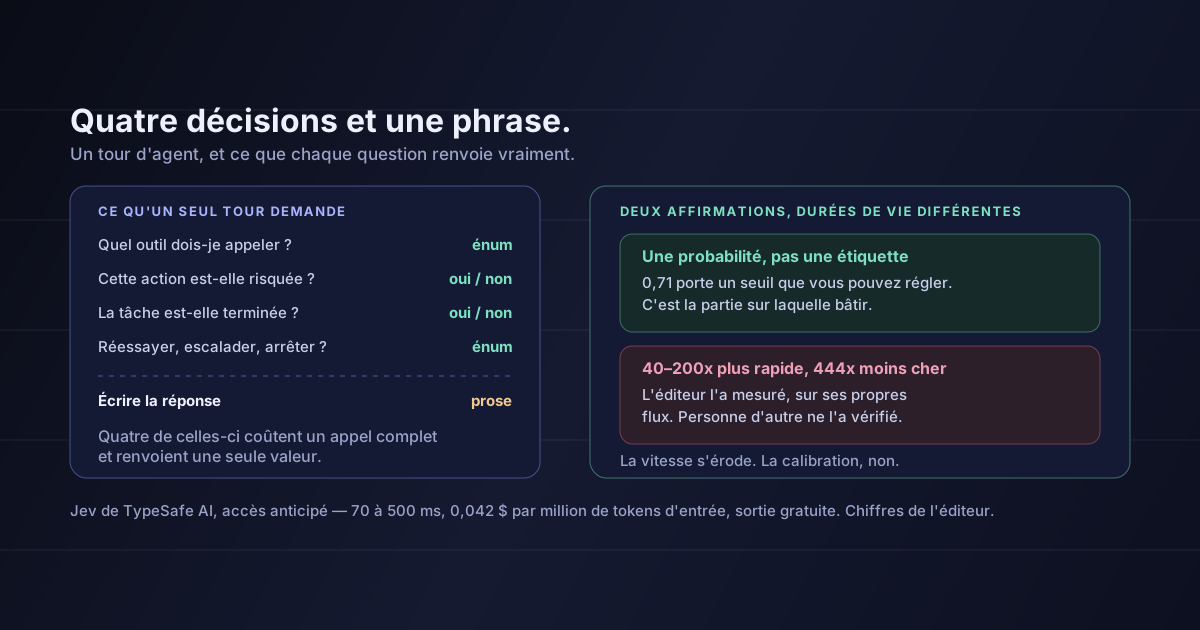
Retirez l'éditeur et regardez en quoi consiste vraiment un tour d'agent.
Quel outil dois-je appeler ? Une énumération. Une parmi onze options.
Cette action est-elle assez risquée pour m'arrêter ? Un oui ou un non.
La tâche est-elle terminée ? Un oui ou un non, posé à chaque tour de boucle.
Réessayer, escalader ou abandonner ? Encore une énumération.
Puis, une fois, à la fin : écrire la réponse. Celle-là demande un modèle de langage, et rien ici ne le remplace.
La partie coûteuse d'un tour d'agent est rarement l'écriture. Ce sont les quarante petites décisions qui coûtent chacune un appel complet au modèle.
Chacune de ces décisions passe aujourd'hui par un modèle conçu pour produire des phrases, facturé au token, générant de façon autorégressive, puis se voit réduite à un seul mot au moment du parsing. Vous payez prix et latence de génération pour un travail dont la sortie entière tient dans un octet.
Cette affirmation ne coûte rien à évaluer et ne dépend d'aucun des chiffres de TypeSafe. C'est le même geste que séparer l'OLTP de l'analytique, ou un cache d'une base de données : deux profils d'accès portant un seul composant parce que personne n'avait encore remarqué qu'il s'agissait de deux choses.
Les avantages de vitesse et de coût s'érodent par la concurrence. Dans deux trimestres il y en aura quatre, et le prix sera celui du deuxième moins cher. La calibration, elle, est la partie sur laquelle je bâtirais.
Voici la différence en pratique. Un LLM à qui l'on demande « est-ce urgent ? » renvoie urgent. Un classifieur calibré renvoie 0,71.
Une étiquette vous donne une branche. Une probabilité vous donne un seuil, et un seuil est un cadran :
Bloquer au-dessus de 0,9, signaler pour relecture à partir de 0,6, journaliser en dessous. Une question, trois comportements, aucun appel supplémentaire. Avec une simple étiquette, vous avez un comportement et aucun moyen d'arbitrer entre précision et rappel.
C'est le contrôle que je défendais dans l'article sur les chiffres de surveillance d'Anthropic : décidez combien d'éléments une personne relira chaque semaine, puis déplacez le seuil jusqu'à ce que ce soit ce qui arrive. Cette arithmétique est impossible sur des étiquettes.
Une confiance basse est précisément le cas qui devrait escalader vers un modèle plus lent et plus capable. La plupart des routages d'aujourd'hui devinent la complexité à partir de l'entrée ; un score calibré mesure l'incertitude sur la sortie, ce que vous vouliez savoir en réalité.
Le mot important est calibrée. N'importe quel modèle émettra un nombre si vous lui en demandez un, et la probabilité softmax d'un token n'est pas une affirmation sur la justesse. Savoir si la calibration de Jev tient est exactement le genre de chose qui demande une mesure par un tiers — et n'en a reçu aucune.
TypeSafe affirme que Jev a un taux garanti de 0 % d'erreurs de sortie structurée, présenté comme une propriété mathématique de l'architecture et non comme un résultat de mesure. Pris au pied de la lettre, et je n'ai pas de raison d'en douter, cela signifie que le modèle ne peut pas renvoyer quelque chose hors du schéma que vous avez déclaré.
La forme n'est pas la justesse
Une garantie sur le type est une garantie que la réponse est bien formée, pas qu'elle est juste. Si vous demandez lequel de onze outils appeler, vous obtiendrez toujours l'un des onze — et ce peut être le mauvais des onze, à chaque fois, sans aucune erreur de parsing pour vous prévenir. Il faut être lucide là-dessus, car « n'hallucine jamais » circule déjà comme description de ce modèle et signifie quelque chose de bien plus étroit que cela n'en a l'air : il n'hallucine jamais une forme. Rien dans l'architecture n'empêche une classification fausse et pleinement confiante.
Cela dit, supprimer les sorties malformées est un gain opérationnel réel, et quiconque a livré un agent sait pourquoi : le chemin de réessai sur échec de parsing héberge une quantité surprenante de latence, de coût et de comportements étranges. Éliminer une classe entière de défaillance vaut quelque chose, même si ce n'est pas la classe qui vous inquiète le plus.
Avant d'évaluer le moindre produit ici, découvrez si la prémisse décrit votre système. C'est une heure de travail et la réponse est durable quel que soit l'éditeur retenu au bout du compte.
Instrumentez chaque appel au modèle que fait votre agent et classez-le :
| Catégorie | Test | Ce que cela vous dit |
|---|---|---|
| Décision | La sortie se réduit à une énumération, un booléen ou un nombre | Candidate pour un classifieur |
| Extraction | La sortie est un petit schéma fixe tiré d'une entrée plus large | Candidate, si le schéma est stable |
| Génération | La sortie est de la prose qu'un humain ou un autre système lira | Reste sur un modèle de langage |
| Raisonnement | La sortie est un plan en plusieurs étapes dont les étapes intermédiaires comptent | Reste, et sans doute sur votre meilleur modèle |
Calculez ensuite deux nombres : la part des appels dans les deux premières catégories, et la part de la dépense. Dans la plupart des piles d'agents que j'ai vues, le premier est élevé et le second plus bas mais loin d'être proportionné — les décisions sont en général des prompts courts, donc peu coûteuses à l'unité et assez nombreuses pour compter en cumul, et elles dominent la latence parce qu'elles sont sur le chemin critique de chaque tour.
Le seuil que j'utiliserais :
Si décisions et extraction pèsent moins d'un tiers de vos appels, c'est une optimisation et vous devriez l'ignorer tant qu'autre chose n'est pas réglé. Si elles dépassent les deux tiers — le cas courant pour tout ce qui comporte une boucle d'outils — alors votre architecture contient déjà deux charges de travail et vous êtes à une décision d'éditeur de pouvoir les séparer.
Jev est en accès anticipé, la question pratique est donc ce que vous pouvez faire maintenant. Trois options, par effort croissant.
Regroupez les questions que vous posez déjà. Le gain le moins cher ici n'a rien à voir avec de nouveaux modèles. Si votre boucle fait quatre appels séparés pour décider quatre choses sur le même état, posez les quatre en un appel avec un schéma structuré. Vous payez l'état une fois au lieu de quatre.
Déplacez dès maintenant les décisions faciles vers un petit modèle. « La tâche est-elle terminée » n'a pas besoin de votre meilleur modèle. Un petit modèle avec décodage contraint traite la plupart des questions de porte, et vous pouvez mesurer le taux de désaccord avec votre modèle actuel avant de changer quoi que ce soit.
Construisez le seuil avant d'avoir la probabilité. Écrivez la porte à deux niveaux — bloquer au-dessus, relire entre, journaliser en dessous — même si le niveau intermédiaire reste bouché. Quand un score calibré arrivera, vous brancherez un nombre au lieu de repenser un flux de contrôle.
Gardez le jeu d'évaluation indépendant du modèle. Si vous voulez un jour déplacer une décision vers un classifieur, ce qui en fait un travail de deux heures plutôt que de deux semaines, c'est de disposer d'un jeu étiqueté des entrées de cette décision et des bonnes réponses. La plupart des équipes l'ont pour leur tâche de bout en bout et pas du tout pour les décisions individuelles à l'intérieur.
Ce dernier point est le vrai prérequis. Vous ne pouvez pas déplacer une décision vers un modèle moins cher en sécurité sans un moyen de savoir si elle s'est dégradée, et construire ce jeu est un travail que vous vous devez, qu'un modèle System One entre en scène ou non.
Tous les chiffres de performance sont auto-déclarés. Aucune partie indépendante n'a mesuré Jev. Le modèle est derrière une liste d'attente, les évaluations ne portent pas sur des mesures publiques, et les chiffres de comparaison viennent de l'entreprise qui vend le produit. Cela ne les rend pas faux ; cela les rend non vérifiés, et ils méritent exactement la décote que vous appliqueriez aux chiffres maison de n'importe quel éditeur.
TypeSafe publie ses propres limites méthodologiques, et elles sont réelles. Les évaluations de flux ont été construites par son équipe capacités modèles, ce dont l'entreprise reconnaît que cela pourrait les biaiser. La base de comparaison est la moyenne de deux modèles de frontière. Les démonstrations utilisaient des requêtes simplifiées à clés lisibles. Crédit pour avoir publié tout cela ; cela n'empêche pas que cela compte.
« 193,6× plus rapide, 444,6× moins cher » est un plafond, pas une attente. TypeSafe le dit : elle s'attend à ce que ces valeurs soient dans le haut des gains réels. Citer le chiffre d'affiche comme ce que vous obtiendrez serait mal lire la réserve de l'entreprise elle-même.
Je ne l'ai pas utilisé. Tout ce qui précède est lu dans des documents publiés. Je recommande la question d'architecture, pas le produit.
Les affirmations de calibration sont celles que je voudrais le plus voir contrôlées. C'est la partie à réelle valeur d'ingénierie et la plus difficile à vérifier de l'extérieur, et une courbe de calibration qui tient sur les flux de l'éditeur peut ne pas tenir sur les vôtres. Si vous faites un pilote, mesurez la calibration sur vos propres données avant de brancher un seuil sur quoi que ce soit d'important.
Le lancement sera discuté sur ses chiffres, et ce débat ne peut encore être tranché par personne hors de l'entreprise.
La partie qui ne dépend pas des chiffres, c'est la décomposition. Une boucle d'agent est surtout un moteur de décision avec un rédacteur boulonné à la fin, et le secteur a passé deux ans à servir les deux moitiés depuis le même composant parce que c'était le seul disponible. Quelqu'un allait le remarquer. Qu'il y ait désormais un éditeur, une méthode d'entraînement et une intégration LangChain accrochés à cette observation est moins intéressant que l'observation.
Instrumentez votre agent et découvrez quelle fraction de ses appels au modèle renvoie quelque chose que vous réduisez immédiatement à une seule valeur. Si ce nombre est de deux tiers, vous avez déjà deux charges de travail — et il aurait toujours fallu les séparer, quel que soit celui qui finit par vendre la seconde.
Sources : LangChain, « Building a harness with Jev », par Sydney Runkle et Hunter Lovell, 17 septembre 2026 — le cadrage du harness, les types de question et les cas d'usage routage et garde-fou. TypeSafe AI, « Introducing System One Models & Jev » — la définition System One, l'échantillonneur parallèle, RLCD, la plage de latence de 70 à 500 ms, les 0,042 dollar par million de tokens d'entrée avec sortie gratuite, les chiffres de flux 193,6× et 444,6×, l'affirmation de zéro erreur de type et les réserves méthodologiques citées en section 7, toutes de TypeSafe. Un guide pratique de Jev — la surface du SDK, le plafond de 255 options sur Choice, et les limites de contexte de 64k au total et 32k pour l'état. MindStudio, « RLCD vs RLHF » — l'absence de toute vérification indépendante. L'argument de la décomposition, le plaidoyer pour la calibration plutôt que la vitesse, la distinction forme/justesse et toutes les recommandations sont les miens. Pour la mécanique de coût sur laquelle tout cela repose, voir chaque fichier que lit votre agent reste sur la facture, et pour l'argument du seuil, voir les chiffres de surveillance d'agents d'Anthropic.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.