Les conditions de Meta pour les entreprises ouvrent votre site à ses crawlers dès le 30 octobre. Meta a retiré « train », pas le crawl

By Surya Pratap
19 octobre 2026
8 min read
Startup Strategy

19 octobre 2026
8 min read
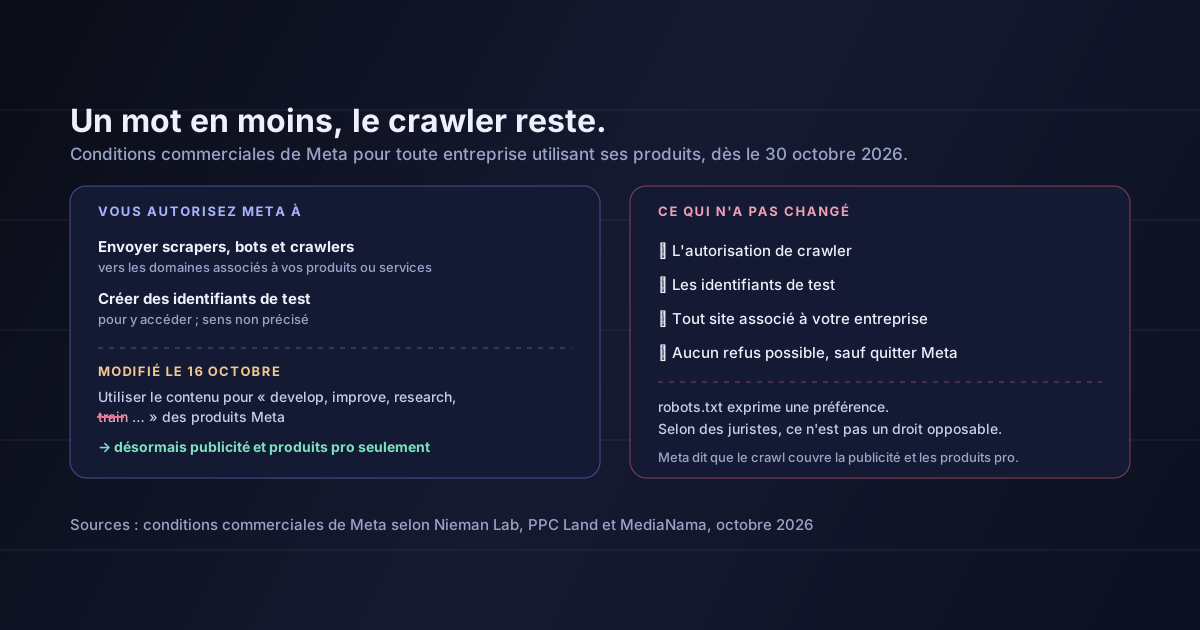 Un mot en moins, le crawler resteHover to explore
La plupart des fondateurs ont accepté les conditions de Meta pour les entreprises sans les lire. Il fallait une page Facebook, un profil professionnel Instagram ou un compte publicitaire, et les conditions venaient avec. La version qui entre en vigueur le 30 octobre mérite d'être lue, car l'un de ses paragraphes concerne votre site web, et non vos comptes Meta.
Cet article s'appuie sur le texte du paragraphe relatif au crawl tel que cité par PPC Land, sur les articles de Nieman Lab (premier article, suite) et sur la couverture de MediaNama. Je n'ai pas vu le texte révisé dans son intégralité ; la description de la modification provient de ces articles. L'analyse à partir de la section 3 est la mienne et ne constitue pas un conseil juridique.
Les conditions commerciales de Meta s'appliquent aux entreprises qui utilisent ses produits à des fins commerciales : pages Facebook, comptes professionnels Instagram, Meta Business Suite, publicité. La version prévue pour le 30 octobre contenait ce paragraphe, reproduit ici dans sa version originale anglaise :
"You authorise us (or any entity acting on our behalf) to use automated software (such as web scrapers, bots, robots, spiders, crawlers and user agents) and create test credentials to access, index, cache, analyse, collect, retrieve or crawl the domains, web pages or URLs (and any content available through them) that are associated with your products or services, or that are made available through your or users' use of Meta Company Products and services, and to periodically pull updates from such domains, web pages or URLs. Meta may use any content from such domains, web pages or URLs to provide, develop, improve, research, train and maintain the integrity of, the Meta Company Products, services and features provided under these Commercial Terms and any other applicable supplemental terms."
Trois éléments comptent :
Le 15 octobre, Nieman Lab a publié l'avis de trois juristes selon lesquels le paragraphe, tel que rédigé, pouvait permettre de soutenir que Meta a le droit de crawler des sites d'information et d'utiliser leur contenu pour entraîner son IA. Presque tous les médias ont un compte professionnel Meta. Le porte-parole de Meta Andy Stone a qualifié de « fausses » les informations selon lesquelles les conditions permettraient de crawler des sites d'information.
Le 16 octobre, Meta a révisé les conditions. Selon les articles publiés, l'entreprise a :
Un porte-parole de Meta a déclaré : « Nous vous avons entendus et voulons clarifier : les conditions de crawl que nous avons regroupées ne s'appliquaient qu'à nos produits publicitaires et professionnels », ajoutant que « les propriétaires de contenu peuvent utiliser robots.txt pour indiquer leurs préférences ».
La révision a changé ce que Meta dit faire du contenu. Selon les articles publiés, elle n'a pas changé l'autorisation de le collecter :
Les juristes n'ont pas été rassurés. James Grimmelmann, de Cornell, a déclaré à Nieman Lab que la formulation révisée restait assez large pour couvrir l'entraînement de l'IA. Benjamin Sobel, de l'université du Wisconsin, a rappelé que robots.txt exprime une préférence mais ne crée pas de droit opposable permettant d'empêcher le crawl. Des associations d'éditeurs européennes, britanniques et américaines ont demandé l'intervention des régulateurs.
Meta a retiré le mot qui décrivait ce qu'il peut faire de votre contenu. Il a gardé le paragraphe qui lui permet de le collecter.
Ce n'est pas qu'un problème d'éditeurs de presse. Si vous avez une page Facebook, un compte professionnel Instagram ou des publicités Meta, vous êtes partie à ces conditions, et votre site est « associé à vos produits ou services ».
Cartographiez ce qui est accessible. Listez les domaines liés à vos comptes et publicités Meta : site marketing, documentation, blog, centre d'aide, application. Décidez lesquels vous acceptez de voir crawlés, mis en cache et analysés par un tiers, selon des conditions que vous n'avez pas négociées.
Séparez le marketing du produit. Gardez votre produit sur son propre sous-domaine, derrière sa propre authentification. Un compte de test créé par le crawler d'un autre ne doit pas pouvoir voir des données clients, des prix négociés en privé ou quoi que ce soit derrière une connexion que vous ne montreriez pas à un inconnu.
Exprimez quand même votre préférence. Robots.txt n'est pas opposable, mais c'est le signal auquel Meta renvoie lui-même. Définissez des règles pour les crawlers publiés par Meta, et pour les crawlers d'IA en général, sur les domaines qui comptent. Vérifiez ensuite vos journaux serveur pour voir ce qui arrive réellement.
Surveillez les inscriptions inconnues. « Identifiants de test » signifie des comptes. Repérez les inscriptions et les connexions qui ne se comportent pas comme des clients, et décidez à l'avance de ce que vous ferez s'il s'avère qu'elles sont automatisées.
Lisez les conditions que vous avez acceptées sans les lire
Programmez un rappel pour lire les conditions professionnelles de chaque plateforme dont vous dépendez — Meta, Google, LinkedIn, votre prestataire de paiement, votre cloud — à chaque modification. Les clauses qui comptent pour une startup à l'ère de l'IA portent sur le crawl, l'usage du contenu et l'entraînement, et elles figurent de plus en plus dans des conditions acceptées pour diffuser des publicités, pas dans un contrat que vous avez négocié.
Si votre contenu est votre produit — une base de connaissances, un jeu de données, des recherches originales, des articles payants —, l'enjeu est plus grand encore. Notre guide GEO explique comment être cité par les systèmes d'IA ; ceci est l'autre face de la même question : être collecté par eux sans qu'on vous le demande.
Certains fondateurs liront cette histoire de l'autre côté. Si votre produit repose sur le crawl de sites tiers, regardez ce qui s'est passé : une entreprise du poids de Meta a inscrit le consentement au crawl et à l'entraînement dans des conditions que ses clients ne pouvaient pas négocier, et la polémique l'a forcée à les modifier en une journée.
La leçon ne porte pas sur la position juridique de Meta, que les avocats contestent. Elle tient au fait qu'un consentement enfoui dans les conditions d'une plateforme est fragile, publiquement et commercialement. Des données d'entraînement sous licence, ou pour lesquelles les propriétaires ont clairement donné leur accord, sont plus longues à obtenir et bien plus difficiles à vous retirer. Et si un régulateur vous demande, comme la FTC vient de le demander à OpenAI et Anthropic, si vos affirmations correspondent à vos pratiques, « les conditions le permettaient » est une réponse faible.
Que Meta entraîne de l'IA sur votre site. Meta affirme que le crawl ne concerne que la publicité et les produits professionnels, et a qualifié de fausses les informations sur le crawl de sites d'information. Les conditions fixent ce que Meta peut faire, pas ce qu'il fait.
Que les conditions révisées autorisent l'entraînement de l'IA. Certains juristes estiment que la formulation reste assez large ; Meta n'est pas d'accord. Aucun tribunal ne s'est prononcé.
Que je connais la formulation définitive. Le texte révisé est décrit ici d'après les articles publiés ; vérifiez les conditions que Meta publiera avant le 30 octobre.
Que robots.txt vous protège. Il exprime une préférence. Comme l'a souligné Sobel, il ne crée pas de droit opposable.
À partir du 30 octobre, toute entreprise utilisant les produits de Meta autorise Meta à envoyer des scrapers et des crawlers, et à créer des identifiants de test, sur les sites associés à ses produits. Meta se réservait au départ le droit d'utiliser ce contenu pour entraîner ses produits ; après les articles de Nieman Lab, il a retiré « train » et limité l'usage à la publicité et aux produits professionnels. Le crawl, les identifiants de test, la portée large et l'absence de possibilité de refus demeurent, et des juristes estiment que la formulation révisée reste large.
Pour les startups, la conclusion pratique est simple. L'exposition de votre site dépend désormais en partie de conditions que vous avez acceptées pour avoir une page Facebook.
Avant le 30 octobre, listez tous les domaines liés à vos comptes Meta, placez tout ce qui est sensible derrière sa propre authentification, définissez vos préférences robots.txt pour les crawlers de Meta et des autres acteurs de l'IA, et commencez à surveiller vos journaux et vos inscriptions pour repérer les visiteurs automatisés.
Sources : PPC Land — le texte intégral du paragraphe sur le crawl tel que publié initialement pour le 30 octobre 2026, les entreprises concernées et le refus de Meta d'expliquer les identifiants de test. Nieman Lab, 15 octobre 2026 — la lecture des trois juristes. Nieman Lab — la révision et l'avis des experts selon lequel elle reste large. MediaNama — la suppression de « train », la restriction à la publicité et aux produits professionnels, la déclaration du porte-parole de Meta sur robots.txt, les commentaires de James Grimmelmann et de Benjamin Sobel, l'absence de possibilité de refus et les appels des associations d'éditeurs. La date de révision du 16 octobre, le commentaire d'Andy Stone sur des informations « fausses » et l'usage quasi universel des comptes professionnels Meta par les médias proviennent de la couverture des articles de Nieman Lab. L'analyse des sections 3 à 6 est la mienne et ne constitue pas un conseil juridique.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.