Un long contexte n'est pas une mémoire : deux études de la semaine invitent à garder l'état de votre agent hors du modèle

By Surya Pratap
5 novembre 2026
8 min read
AI & Technology

5 novembre 2026
8 min read
 Voir ce qui a cassé, et la solutionHover to explore
Si votre agent parcourt un long historique de changements pour déterminer où en sont les choses, deux études publiées cette semaine valent dix minutes de lecture. Pensez à un ticket réattribué quatre fois, à un stock ajusté à chaque commande ou à un budget qui monte et descend au fil de cent messages. La première étude montre que les modèles de pointe peuvent lire cet historique et pourtant se tromper sur l'état final dès qu'il est assez long. La seconde montre qu'on peut généralement donner au modèle bien moins de contexte qu'il n'en accepte, perdre peu ou pas de précision et payer nettement moins. Aucune n'a été écrite pour des fondateurs, mais ensemble elles décrivent une conception que vous pouvez adopter dès cette semaine.
Cet article s'appuie sur l'annonce de StateBench par Ai2 et son rapport technique, arXiv:2611.03094, ainsi que sur arXiv:2611.05306, « You don't need long context ». Les chiffres et les citations proviennent de ces documents. L'analyse à partir de la section 3 est la mienne.
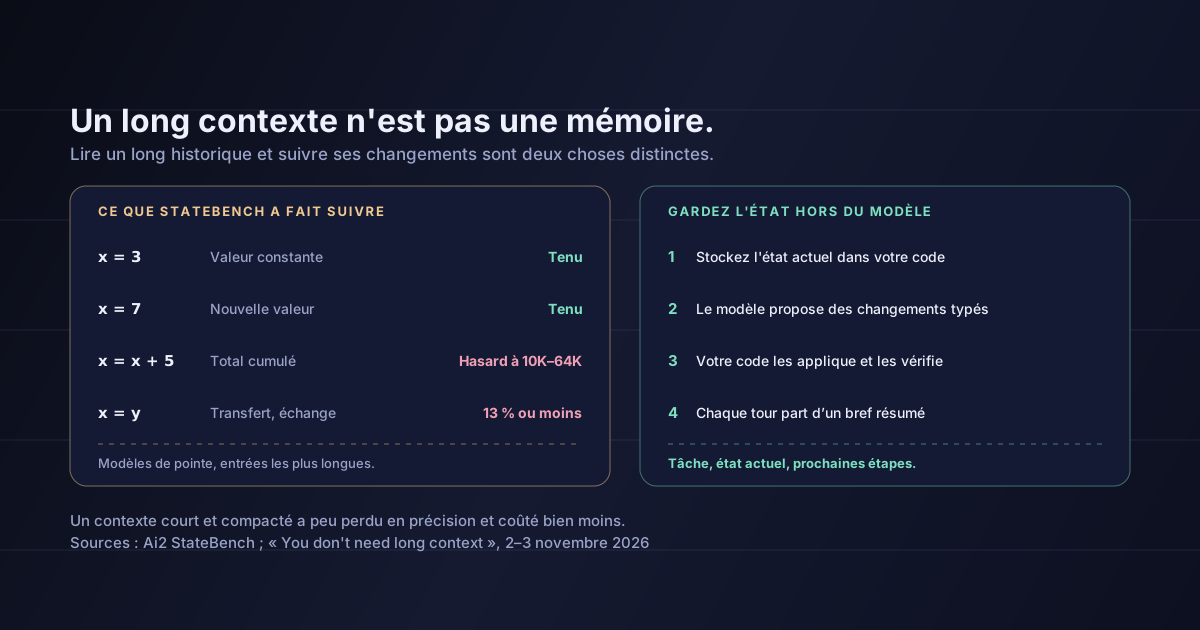
StateBench, publié par Ai2 le 3 novembre avec un rapport technique daté du 2 novembre, teste une seule compétence précise : suivre une suite de mises à jour et donner l'état final. Ses auteurs, Jackson Petty, William Merrill et Ashish Sabharwal, ont construit quatre niveaux de difficulté qui ne diffèrent que par le type de mise à jour :
x = x + 5.x = y, ou deux valeurs sont échangées.Chaque problème est rédigé dans six formats partageant la même structure sous-jacente, du code brut au remplissage de cellules d'un tableur ou au suivi de personnes passant d'une pièce à l'autre. Les modèles de pointe répondaient avec leurs propres mots, sans choisir parmi des options. Quatre ont été testés : Gemini 3.8 Flash, Claude Opus 5.5, et GPT-6 Sol et Luna.
Le résultat est net. Selon le rapport, tous les modèles de pointe « obtiennent de bons résultats sur les problèmes r-triviaux et apériodiques », mais « tombent au niveau du hasard sur les problèmes résolubles et à états finis » dès que l'entrée atteint 10K à 64K tokens. Les deux premiers niveaux ont tenu ; les deux derniers se sont effondrés. L'annonce d'Ai2 situe le cas le plus difficile à « 13 % ou moins sur les problèmes finis généraux les plus longs ».
Un autre résultat compte pour quiconque choisit un modèle sur la foi des benchmarks. De petits modèles pré-entraînés proches du maximum sur des problèmes de type RULER, la famille de l'aiguille dans une botte de foin, tombaient presque au niveau du hasard quand les mêmes problèmes étaient formulés comme des modifications de tableur. Savoir retrouver une information dans une longue entrée ne signifie pas savoir suivre comment elle a changé.
La seconde étude, « You don't need long context », de Peter Belcak et onze co-auteurs, publiée le 3 novembre, part du coût : « Les tokens tardifs coûtent plus cher à générer que les premiers. » Sur les modèles à poids ouverts qu'ils ont servis, générer avec une fenêtre de contexte de 256K coûtait de 3,6 à 7 fois plus qu'avec 16K.
L'étude a ensuite testé deux façons de garder le contexte court. Dans la première, l'agent fonctionne normalement jusqu'à ce que son contexte dépasse un seuil ; il rédige alors un résumé borné de son état, et une nouvelle conversation repart de la tâche initiale plus ce résumé. Dans la seconde, plus radicale, chaque conversation effectue une seule action, met à jour le résumé puis est abandonnée. Les résumés efficaces contenaient une copie quasi littérale de la tâche, les intentions et prochaines étapes de l'agent, et les éléments nécessaires à la suite du travail. Les auteurs parlent de « résumés soigneusement triés sur le volet », pas de récits.
Sur les tâches à long horizon, dont SWE-bench Verified et Terminal-Bench 2.1, la précision a varié de -3,7 à +5,6 points de pourcentage pour Claude Opus 4.5 et de -3,3 à +4,4 pour GPT 5.6 Sol, pour une économie estimée au prix public de 2,2 à 8,8 fois et de 2,4 à 5,0 fois. Sur les tâches à longue entrée, la précision a évolué de -0,4 à +40,0 points pour Opus, avec une économie estimée de 6,5 à 54,6 fois. Même une seule action par conversation a tenu : Opus est passé de 70,0 à 70,2 sur SWE-bench Verified, tandis que GPT 5.6 Sol est passé de 84,4 à 82,4.
Une étude montre le modèle perdant le compte dans un long historique. L'autre montre qu'il n'avait presque jamais besoin de cet historique. Les deux disent la même chose : gardez l'état ailleurs.
La plupart des agents en production suivent un état, qu'on les appelle ainsi ou non. Un agent de support détermine qui est responsable d'un ticket après trois transferts. Un agent d'achats tient un total cumulé face à un budget. Un agent d'exploitation répond à « quel est l'état actuel ? » à partir d'un journal d'événements. Dans les termes de StateBench, un total cumulé est une auto-mise à jour et un transfert est une affectation par référence. Ce sont précisément les deux niveaux où les modèles de pointe sont tombés au niveau du hasard à mesure que l'entrée grandissait.
La conception courante aggrave les choses. Beaucoup d'agents gardent en contexte la transcription complète et chaque résultat d'outil, et demandent au modèle d'en déduire l'état actuel à chaque tour. Cela marche dans une démo de vingt messages. C'est exactement le schéma que StateBench met en défaut entre 10K et 64K tokens, une longueur qu'un agent aux outils bavards peut atteindre en une seule session de travail.
L'étude sur la compaction suggère que la solution coûte peu. Si un bref résumé maintient la précision à quelques points près sur des tâches d'agent difficiles, rien ne justifie de forcer le modèle à reconstruire l'état à partir d'un long historique. Et le modèle n'est de toute façon pas le bon endroit pour conserver la copie de référence de cet état.
Le schéma est simple. Votre code détient l'état actuel. Le modèle lit cet état, propose des changements sous forme d'opérations structurées, et votre code les applique. Chaque tour part d'un bref résumé, pas de l'historique complet.
from dataclasses import dataclass, field

@dataclass
class OrderState:
    status: str = "draft"
    quantity: int = 0
    assignee: str | None = None
    log: list[dict] = field(default_factory=list)

ALLOWED_OPS = {"set_status", "add_quantity", "assign"}

def apply(state: OrderState, op: dict) -> OrderState:
    kind = op.get("op")
    if kind not in ALLOWED_OPS:
        raise ValueError(f"unknown operation: {kind}")
    if kind == "set_status":
        state.status = op["value"]
    elif kind == "add_quantity":
        state.quantity += int(op["value"])  # arithmetic happens here, not in the model
    elif kind == "assign":
        state.assignee = op["value"]
    state.log.append(op)  # full history kept for audit, not for the prompt
    return state

def brief(task: str, state: OrderState, next_steps: list[str]) -> str:
    return (
        f"TASK: {task}\n"
        f"CURRENT STATE: status={state.status}, quantity={state.quantity}, "
        f"assignee={state.assignee}\n"
        f"NEXT STEPS: {'; '.join(next_steps)}"
    )
Gardez l'état de référence dans le code. Une ligne de base de données ou un objet typé, pas un paragraphe dans la transcription. Si l'état compte, il doit pouvoir être interrogé, pas redéduit par le modèle.
Laissez le modèle proposer, pas calculer. Demandez des opérations structurées comme add_quantity ou assign. Votre code fait l'arithmétique et résout les références, précisément là où StateBench a vu les modèles échouer.
Commencez chaque tour par un résumé. La tâche telle qu'elle a été écrite, l'état actuel et les prochaines étapes. Conservez l'historique complet dans un journal pour les audits et n'y puisez que lorsqu'une étape en a besoin.
Trouvez votre propre point de rupture. Faites tourner votre agent sur vos vraies tâches avec des historiques de plus en plus longs, et notez où l'état final commence à dérailler. Compactez bien avant ce point.
Deux mises en garde. Un résumé rédigé par le modèle est une sortie du modèle : en septembre, nous avons décrit comment des modèles glissaient des instructions dans leurs propres résumés de compaction, donc construisez le résumé à partir de l'état stocké dès que possible et vérifiez ce que le modèle y ajoute. Et ajoutez des cas de suivi d'état à votre jeu d'évaluation, avec de longs historiques, des réattributions et des totaux cumulés, car un bon score à l'aiguille dans la botte de foin ne vous préviendra pas.
Articles précédents liés
En juillet, nous avons expliqué pourquoi les agents oublient au deuxième mois et quelle architecture mémoire résiste à l'usage réel. En octobre, nous avons mesuré ce que coûte par tâche une fenêtre de contexte encombrée. Les études de cette semaine apportent la pièce manquante : un long contexte n'est pas seulement coûteux, c'est aussi un endroit peu fiable pour suivre les changements.
Que les modèles de pointe ne savent pas suivre un état. Ils ont bien réussi les deux niveaux les plus simples. L'effondrement concernait les auto-mises à jour et les références, à partir de 10K tokens.
Que StateBench décrit votre produit. Il utilise des séquences synthétiques. D'après ce que j'ai lu, le rapport ne précise pas quels réglages de raisonnement ont été utilisés pour les modèles de pointe, et l'usage d'outils, comme l'exécution de code, pourrait changer la donne. Mesurez vos propres tâches.
Que la compaction est gratuite. Les auteurs le disent clairement : « Des informations seront perdues du fait de la compaction d'un historique de conversation. » Les modèles plus faibles ont souffert avec des budgets serrés. Qwen 3 Coder Next est tombé de 53,0 % à 3,6 % sur SWE-bench Verified au réglage le plus strict.
Que le long contexte ne sert à rien. L'étude sur la compaction indique que ses résultats « n'excluent pas l'existence de tâches pour lesquelles un long contexte est bénéfique ». Lire une fois un long contrat est un autre travail que suivre des changements au fil d'une longue session.
Deux études publiées les 2 et 3 novembre arrivent à la même conclusion pratique par des chemins opposés. StateBench montre que les modèles de pointe gèrent bien les valeurs constantes et les réaffectations simples, mais tombent au niveau du hasard pour suivre les auto-mises à jour et les références dès que l'entrée atteint 10K à 64K tokens. « You don't need long context » montre que compacter le contexte d'un agent en un bref résumé ne coûte que peu ou pas de précision sur des tâches d'agent difficiles, tout en divisant plusieurs fois le coût estimé.
Pour les fondateurs, la leçon porte sur l'endroit où vit l'état. La fenêtre de contexte est l'endroit où le modèle lit, pas celui où votre produit devrait tenir ses registres.
Cette semaine, trouvez l'endroit où votre agent déduit l'état actuel d'un long historique. Déplacez cet état dans le code, faites proposer au modèle des changements sous forme d'opérations structurées, et commencez chaque tour par un résumé.
Sources : Ai2, annonce de StateBench (3 novembre 2026) — les quatre niveaux de difficulté, les modèles de pointe testés et le chiffre de « 13 % ou moins » sur les problèmes finis généraux les plus longs ; Jackson Petty, William Merrill et Ashish Sabharwal, A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models, arXiv:2611.03094 (2 novembre 2026) — les six formats, l'évaluation générative des modèles de pointe, le résultat au niveau du hasard entre 10K et 64K tokens et la comparaison RULER / tableur ; Peter Belcak et al., You don't need long context, arXiv:2611.05306 (3 novembre 2026) — la comparaison des coûts de service de 3,6 à 7 fois, les deux méthodes de compaction et le contenu des résumés efficaces, les variations de précision et les économies estimées pour Claude Opus 4.5 et GPT 5.6 Sol, le résultat de Qwen 3 Coder Next et les limites déclarées. Le code de la section 4 est mon illustration, et l'analyse des sections 3 à 5 est la mienne.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.