
Le mur du deuxième mois : pourquoi votre agent IA oublie, et l'architecture de mémoire qui règle le problème (2026)

By Surya Pratap
27 juillet 2026
10 min read
AI & Technology

27 juillet 2026
10 min read
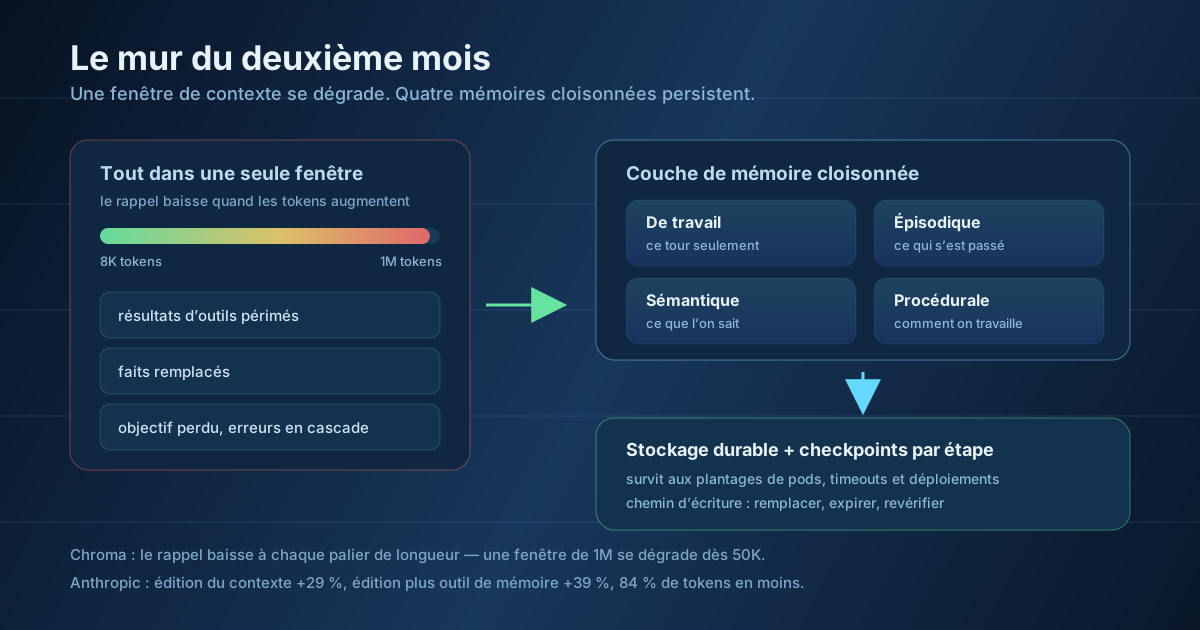
Une plainte très précise circule en ce moment dans les recoins de Reddit où l'on construit des agents (r/AI_Agents, r/Automation, r/n8n), et elle arrive toujours selon le même calendrier. La démo a marché. Le pilote a marché. Puis, vers la sixième ou la huitième semaine, avec un usage réel et des sessions de longueur réelle, l'agent a commencé à se tromper subtilement. Il a reposé une question à laquelle on avait déjà répondu. Il a agi sur une information client qui avait changé deux semaines plus tôt. Il a perdu le fil d'une longue tâche et a terminé avec assurance la mauvaise. Les créateurs ont commencé à appeler cela le mur du deuxième mois, et le plus frustrant, c'est que rien n'a cassé. Aucune erreur, aucune exception, aucun déploiement raté. L'agent s'est simplement dégradé en silence.
Le réflexe est d'accuser le modèle et de passer à une version supérieure. Cela ne règle presque jamais le problème, car il ne s'agit pas d'une défaillance du modèle : c'est une défaillance de l'architecture de mémoire. La plupart des pannes d'agents en production sont des pannes de contexte, et la forme du problème est devenue assez claire en 2026 pour avoir un nom, un ensemble de mesures derrière elle et une série de correctifs ennuyeux au meilleur sens du terme. Voici un guide pour fondateurs sur ce qui déraille vraiment, pourquoi des fenêtres de contexte plus grandes n'ont sauvé personne et à quoi doit ressembler la couche de mémoire avant que votre agent n'aborde son deuxième mois.
La preuve la plus claire vient de la recherche Context Rot de Chroma, qui a évalué 18 modèles de pointe, dont GPT-4.1, Claude 4, Gemini 2.5 et Qwen3, sur huit longueurs d'entrée et des tâches volontairement simples comme la récupération et la réplication de texte. Le résultat est dérangeant : les modèles ne traitent pas le contexte de manière uniforme. Le rappel se dégrade à chaque palier de longueur, pas seulement près de la limite. Un modèle doté d'une fenêtre de contexte d'un million de tokens montre déjà une dégradation mesurable à cinquante mille tokens.
Deux détails comptent plus que le titre. D'abord, la dégradation s'accélère à mesure que baisse la similarité sémantique entre l'information enfouie et la question : plus la récupération est difficile, plus la dégradation est rapide. Ensuite, les distracteurs et la structure de la botte de foin modifient la courbe indépendamment de la longueur brute. Ensemble, ces deux points mènent à la même conclusion : le rapport signal-bruit compte davantage que la capacité. Remplir une fenêtre plus grande n'est pas une stratégie ; c'est précisément ce qui provoque le problème.
Pourquoi le mur apparaît justement au deuxième mois
Les démos sont courtes. Les pilotes sont courts. C'est dans l'usage réel que les sessions s'allongent, que l'historique s'accumule et que les faits appris la première semaine deviennent obsolètes. Le contexte propre au lancement est, au deuxième mois, un gros tas de résultats d'outils à moitié pertinents et de vérités remplacées, et c'est exactement le régime dans lequel le rappel s'effondre.
Le changement de perspective le plus utile consiste à comprendre que la « mémoire » n'est pas une seule chose. Les systèmes d'agents en production en distinguent au moins quatre types, et la plupart des premiers MVP les écrasent tous dans une seule transcription de conversation qui ne cesse de grandir. La mémoire de travail est ce dont l'agent a besoin pour l'étape en cours, et elle doit être jetable sans état d'âme. La mémoire épisodique est ce qui s'est passé : l'historique des sessions et des résultats précédents. La mémoire sémantique est ce que l'on sait : des faits durables sur un utilisateur, un compte, un domaine. La mémoire procédurale est la façon dont le travail se fait : les workflows et les schémas appris qui doivent survivre à chaque session.
Leurs durées de vie sont complètement différentes, et c'est tout l'enjeu. La mémoire de travail doit être vidée en permanence ; la mémoire sémantique doit persister des mois tout en restant corrigeable ; la mémoire procédurale doit être versionnée comme du code. Quand les quatre vivent dans une seule fenêtre de contexte, vous obtenez la pire politique pour chacune : rien n'est jamais vidé, rien n'est jamais correctement mis à jour, et chaque fait se dispute l'attention avec chaque résultat d'outil périmé. Dégradation du contexte, dérive de la mémoire, objectifs perdus et erreurs en cascade : voilà ce que produit ce design à fenêtre unique sous charge.
À côté des types, le périmètre compte. Les systèmes de mémoire matures indexent la récupération sur l'identité : utilisateur, agent, session ou exécution, et organisation. Un fait appris sur un utilisateur ne doit pas fuiter dans la session d'un autre ; un workflow appris à l'échelle de l'organisation doit être disponible partout. Si votre agent n'a pas de modèle de périmètre, soit il oublie trop, soit il se souvient de choses qu'il n'a aucune raison de retenir, et le second échec est un incident de confidentialité en puissance.
La bonne nouvelle de 2026, c'est que les correctifs sont mesurables, et qu'ils relèvent de l'architecture plutôt que du modèle. Les résultats publiés par Anthropic sur ses propres évaluations de recherche agentique en sont l'exemple le plus net : l'édition du contexte, qui retire automatiquement de la fenêtre les appels et résultats d'outils périmés, a apporté une amélioration de 29 % sur des tâches complexes en plusieurs étapes. L'ajout d'un outil de mémoire, avec lequel le modèle lit et écrit des fichiers dans un répertoire de mémoire situé hors de la fenêtre de contexte, a porté le gain combiné à 39 %. Dans une évaluation de recherche web sur cent tours, l'édition du contexte a permis aux agents de terminer des workflows qui mouraient auparavant par épuisement du contexte, tout en réduisant la consommation de tokens de 84 %.
Lisez attentivement ce duo, car c'est la leçon de conception. L'édition seule aide parce qu'elle améliore le rapport signal-bruit. L'édition associée à une mémoire externe aide davantage parce que l'agent n'a plus à choisir entre oublier quelque chose et s'y noyer. La réduction de 84 % des tokens est la partie que les fondateurs devraient relire deux fois : c'est l'un des rares cas où le correctif de fiabilité et le correctif de coût sont le même changement.
Les couches de mémoire dédiées annoncent des gains similaires sur les benchmarks de référence : des scores entre le bas et le milieu des quatre-vingt-dix sur LoCoMo et LongMemEval avec environ sept mille tokens par requête, et des bonds à deux chiffres en raisonnement temporel et multi-sauts par rapport aux approches précédentes. Mais le chiffre honnête est celui de l'évaluation à grande échelle : sur BEAM, la performance passe d'environ 64 avec un million de tokens d'historique à environ 49 avec dix millions. Même les bons systèmes de mémoire se dégradent quand l'historique grandit. La qualité de la récupération est une vraie contrainte, pas un problème résolu, et toute feuille de route qui suppose qu'« il suffit d'ajouter de la mémoire » saute la moitié difficile.
Le premier geste le moins cher
Avant d'évaluer le moindre fournisseur de mémoire, ajoutez l'édition du contexte : faites expirer les résultats d'outils dès qu'ils ont été exploités, et supprimez les traces de raisonnement qui n'éclairent plus l'étape suivante. C'est quelques jours de travail, cela ne demande aucune nouvelle infrastructure, et c'est le changement au meilleur rendement mesuré par heure investie.
Presque toutes les discussions sur la mémoire se concentrent sur la récupération : embeddings, rerankers, recherche hybride. Mais les échecs que décrivent les créateurs sur Reddit sont massivement des échecs du chemin d'écriture. L'agent s'est souvenu correctement de quelque chose, puis le monde a changé. Le client est passé à une autre formule. La politique a été mise à jour. Le contact qui validait les décisions est parti. La mémoire ne se trompe pas sur le passé ; elle se trompe sur le présent, et le système n'a aucun mécanisme pour s'en apercevoir.
Un commentateur de ces fils l'a mieux formulé que la plupart des documentations de fournisseurs : la fiabilité à long horizon exige un moyen d'oublier, remplacer et revérifier les faits. Ce sont trois opérations distinctes. Oublier, c'est une durée de vie pour des souvenirs qui n'étaient que circonstanciels. Remplacer, c'est écrire un nouveau fait qui retire explicitement l'ancien au lieu de cohabiter avec lui, car deux souvenirs contradictoires dans un index de récupération, c'est un pile ou face, pas une base de connaissances. Revérifier, c'est contrôler à nouveau les faits à fort enjeu auprès du système source avant d'agir, plutôt que de se fier à une note vieille de six semaines.
L'obsolescence de la mémoire est ouvertement reconnue comme un problème non résolu, même par les équipes qui construisent l'infrastructure de mémoire, au même titre que l'abstraction temporelle et la résolution d'identité. N'attendez donc pas qu'une bibliothèque s'en charge. Décidez, par catégorie de fait, combien de temps il reste vrai et ce qui se passe quand il ne l'est plus, et inscrivez cette politique dans le système plutôt que dans un document de conception.
L'autre moitié du mur du deuxième mois n'a rien de cognitif : elle est infrastructurelle. Les agents qui tournent pendant des heures ou des jours rencontreront des timeouts chez le fournisseur, des plantages de pods, des déploiements planifiés et des coupures réseau. Ce ne sont pas des cas limites ; sur un horizon assez long, ils sont garantis. Si l'état de la session vit dans la mémoire du processus ou sur le disque éphémère d'un pod, chacun de ces événements détruit en silence tout ce que l'agent savait, et l'agent relance le workflow depuis le début, en brûlant des tokens et parfois en répétant des effets de bord qu'il ne devrait jamais répéter.
Le schéma qui fonctionne est terne et bien connu : l'état dans un stockage durable, des checkpoints écrits avant l'exécution de chaque étape, et une reprise au point exact de l'échec plutôt qu'au début. Le constat de ces mêmes communautés de créateurs est sans détour : les agents qui rapportent de l'argent ont des chemins de reprise durables, et ceux qui échouent en production n'en ont pas. C'est aussi pourquoi la critique récurrente du débat de cet été sur X entre graphes et boucles pour l'orchestration a autant porté : comme l'a souligné le créateur de XState, le secteur ne cesse de redécouvrir sous de nouveaux noms des schémas de génie logiciel vieux de plusieurs décennies. Les machines à états durables en font partie. Votre agent a besoin des mêmes garanties de reprise que n'importe quel traitement de longue durée depuis trente ans.
Si vous livrez un MVP IA le trimestre prochain, vous n'avez pas besoin d'un système de mémoire digne d'un labo de recherche. Vous avez besoin de ne pas heurter le mur. C'est un travail bien plus modeste, qui consiste surtout à prendre quatre décisions explicitement plutôt que par accident.
Ce dernier point est celui que la plupart des équipes sautent. Si le mur du deuxième mois surprend autant, c'est parce que personne n'a testé le deuxième mois : le jeu d'évaluation a été construit à partir de tâches propres, courtes, de première session, si bien qu'il continuait de passer pendant que la fiabilité réelle glissait. Si vous ne retenez qu'une chose, que ce soit celle-ci : mettez dans votre suite de tests une session volontairement longue et volontairement périmée, avec un fait qui a changé en cours de route, et voyez si votre agent s'en rend compte.
Le changement de fond mérite d'être nommé. En 2026, les acheteurs ne sont plus impressionnés par les démos d'agents, parce que tout le monde en a une. Ce qu'ils achètent vraiment, c'est l'accomplissement de tâches qui tient à la centième exécution, et cela se joue presque entièrement dans une architecture que la démo ne met jamais à l'épreuve. C'est sur la mémoire que cette bataille se gagne : pas avec le modèle que vous choisissez, mais avec ce que vous décidez de garder, ce que vous décidez de jeter et ce que vous vous assurez de voir survivre à un déploiement.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.