
Deux harnesses d'agents sortis en 48 heures — et ils font des paris opposés (2026)

By Surya Pratap
7 août 2026
11 min read
AI & Technology

7 août 2026
11 min read
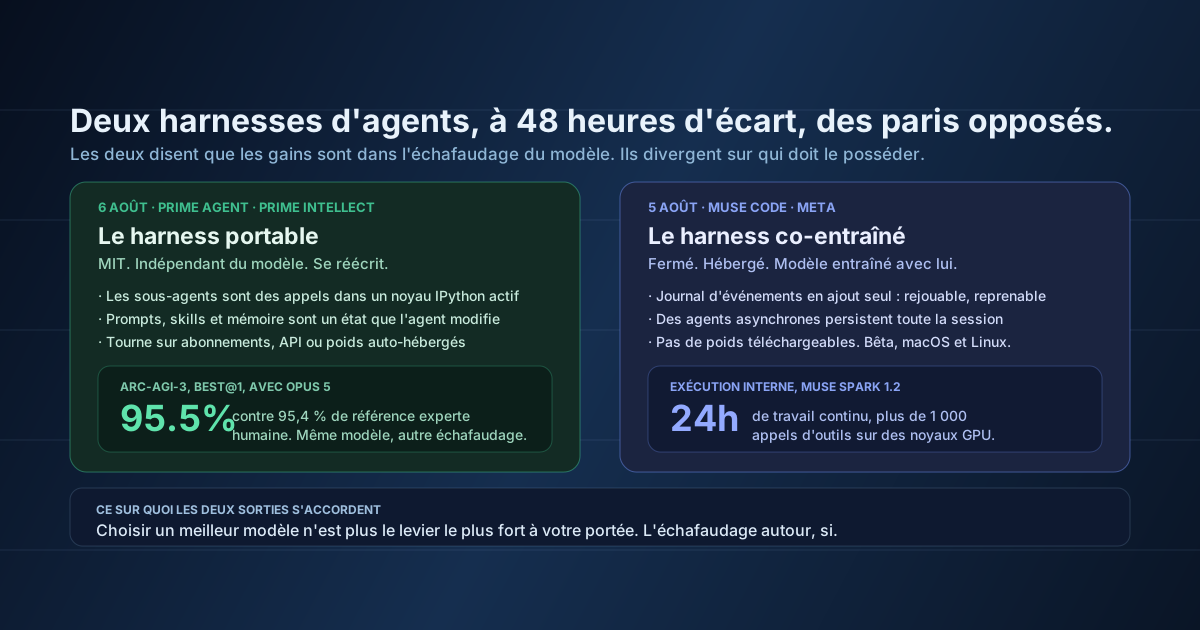
Le 5 août, Meta a lancé Muse Code, un agent de code en terminal qui tourne sur Muse Spark 1.2, un modèle entraîné en même temps que l'agent lui-même. Le 6 août, Prime Intellect a ouvert le code de Prime Agent sous licence MIT, un harness conçu pour exécuter n'importe quel modèle qu'on lui fournit, qui a obtenu 95,5 % sur ARC-AGI-3 avec Opus 5 derrière.
Aucune de ces deux sorties ne porte fondamentalement sur un modèle. Toutes deux portent sur l'échafaudage qui l'entoure : comment le contexte est géré, comment les sous-agents sont lancés, ce qui survit à un plantage, ce que l'agent a le droit de modifier en lui-même en cours de tâche. C'est un changement qui mérite d'être nommé. Pendant deux ans, les sorties intéressantes étaient des checkpoints, et la question du fondateur était de savoir vers quel modèle router. Ces deux-là disent que ce n'est plus dans le modèle que se trouvent les gains restants.
Ce qui rend la paire vraiment utile, c'est qu'elles s'accordent sur la prémisse et divergent complètement sur la conclusion. L'une dit que le harness est portable et doit vous appartenir. L'autre dit que le harness ne fonctionne que si le modèle a été entraîné dedans, et qu'il doit donc appartenir au laboratoire. Vous allez devoir choisir votre camp ; autant comprendre l'argument.
Prime Agent repose sur deux idées, toutes deux assez inhabituelles pour mériter d'être exposées clairement.
La première est le Recursive Language Model. Au lieu que le contexte soit une fenêtre qui se remplit puis se tronque, le contexte est une variable dans un noyau IPython persistant. Le modèle écrit du code qui opère sur son propre historique — le cherche, le découpe, en résume des parties — au lieu de recevoir un prompt préassemblé. La délégation à un sous-agent n'est pas une couche d'orchestration spéciale ; c'est un appel de fonction dans ce même REPL. Si vous avez déjà écrit un nœud superviseur dans LangGraph, c'est le même problème résolu un niveau plus bas : l'agent programme sa propre délégation au lieu que vous la câbliez.
La seconde est le Continual Harness. Les prompts, les skills, la mémoire et les définitions de sous-agents sont traités comme un état que l'agent peut créer, lire, mettre à jour et supprimer depuis sa propre exécution. La commande /refine analyse la trajectoire jusque-là et propose des modifications ciblées de cet état — planifiées en arrière-plan pour ne pas bloquer, appliquées entre deux tours, appuyées sur des preuves et réversibles grâce à un historique de rollback. L'agent, dans un sens limité et audité, réécrit son propre échafaudage pendant qu'il travaille.
Le chiffre phare : 95,5 % de RHAE Best@1 sur ARC-AGI-3 avec Opus 5, contre une référence d'expert humain de 95,4 % selon ARC. Les exécutions ont donné 95,0, 95,2 et 95,5, donc le résultat est stable et non un échantillon chanceux. Best@3 atteint 99,97 %, avec les 183 niveaux sur 183 terminés. Prime Intellect fait aussi état d'une meilleure efficacité en tokens que les harnesses natifs des modèles, ce qui compte davantage que le score.
Ce n'est pourtant pas le chiffre d'ARC qui devrait retenir votre attention. C'est la comparaison qui se trouve dessous : Prime Agent exécutant GLM-5.2 s'est montré compétitif, voire meilleur, face à Claude Code avec Opus 5 et à Codex avec GPT-5.6 Sol sur une série de benchmarks à long contexte — OOLONG, OOLONG-Pairs, OBLIQ-Bench, LongBenchPro et ManyIH. Si cela se confirme de manière indépendante, cela signifie qu'un modèle ouvert de milieu de gamme dans un meilleur harness peut égaler un modèle de pointe dans le harness construit par son propre laboratoire. C'est une affirmation bien plus large qu'un record sur un benchmark.
Les démos, pour calibrer
Prime Agent a produit des émulateurs Rust fonctionnels de la SEGA Genesis et de la Game Boy Color sans code de référence, et a atteint un score de production de plus de 100 000 dans Factorio en quelques heures. Lisez-les comme vous devriez lire toute démo de lancement : comme la preuve que le système peut soutenir un travail cohérent très long, pas comme une preuve sur votre base de code. Les émulateurs et les jeux d'usine ont quelque chose que votre produit n'a pas : un signal rapide, sans ambiguïté et automatique indiquant si le dernier changement était correct.
La sortie de Meta est moins nouvelle sur le plan conceptuel et nettement plus sérieuse sur le plan opérationnel. Muse Code est un agent en terminal, en bêta pour macOS et Linux, installé en une seule commande, qui exécute Muse Spark 1.2 via Muse Code ou la Meta Model API. Il n'y a pas de poids téléchargeables.
Trois choix de conception méritent d'être repris, que vous l'utilisiez un jour ou non.
Le journal d'événements en ajout seul. Chaque appel au modèle, exécution d'outil, validation et modification est ajouté à un journal local, ce qui rend le runtime rejouable à l'identique et sûr au redémarrage. Quand l'agent plante au bout de quarante minutes de tâche, il reprend là où il s'était arrêté au lieu de tout recommencer. C'est la propriété la plus sous-estimée de cette sortie. Quiconque a fait tourner de longues sessions d'agents en production sait que l'échec qui fait mal n'est pas une mauvaise réponse — c'est perdre trente minutes d'état accumulé sur un timeout, sans aucun moyen de reconstituer ce que l'agent croyait au moment où il s'est trompé.
Des agents persistants en arrière-plan. Au lieu de lancer un nouveau sous-agent par tâche, Muse Code maintient en vie un ensemble d'agents asynchrones en arrière-plan pendant toute la session. La raison avancée est d'éviter de collecter des informations en double : le deuxième sous-agent ne relit pas le dépôt que le premier vient de lire. Si votre orchestration lance un agent vierge à chaque étape, vous payez cette taxe de redécouverte à chaque étape, et elle s'accumule.
La planification soumise à validation comme skill par défaut. Muse Code est livré avec /plan pour transformer une tâche en plan que vous validez avant exécution, /grill pour éprouver ce plan jusqu'à ce qu'il tienne, et /goal pour mener la tâche à son terme. Faire une passe adversariale sur le plan avant d'écrire la moindre ligne de code est une intervention peu coûteuse que la plupart des équipes sautent.
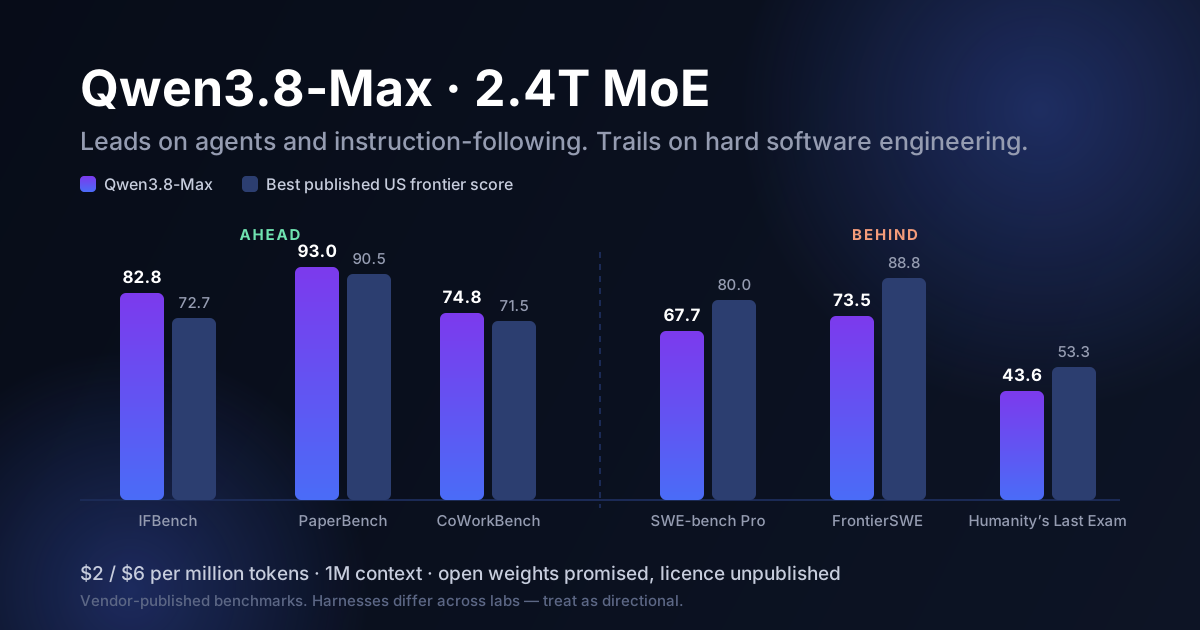
Meta a évalué sur Terminal-Bench 2.1 (89 tâches, pass@1 sur cinq tentatives), DeepSWE v1.1 (113 tâches sur 91 dépôts et cinq langages) et un benchmark interne de 440 tâches tirées de vraies pull requests, en comparaison avec Grok 4.5, Claude Opus 5, GPT-5.6 Terra, Gemini 3.6 Flash et Kimi K3. Je n'ai pas pu vérifier les chiffres publiés de Muse Spark 1.2 auprès d'une source primaire — ils figurent dans des images de graphiques du billet de Meta —, donc je ne les citerai pas. Pour l'échelle : Muse Spark 1.1 obtenait 80,0 sur Terminal-Bench 2.1, et Qwen3.8-Max a annoncé 86,6 sur le même benchmark la semaine dernière. L'affirmation la plus facile à évaluer est l'exécution interne au cours de laquelle le modèle a optimisé des noyaux GPU sur plus de 1 000 appels d'outils et jusqu'à 24 heures de travail continu. Une durée de cet ordre est une propriété du harness, pas du modèle.
Voici ce qui rend cette paire intéressante plutôt que simplement chargée.
Prime Intellect est d'une franchise inhabituelle sur sa propre limite. Son billet signale des frictions lorsqu'on fait tourner Prime Agent avec différents modèles, et affirme clairement qu'aucun modèle n'a été entraîné autour de Prime Agent ni de ses fonctionnalités principales. Les 95,5 % viennent d'un modèle de pointe qui fait quelque chose pour lequel il n'a jamais été spécifiquement entraîné, dans un harness qu'il n'a jamais vu. L'entreprise traite la friction restante comme l'écart entre là où elle en est et là où l'approche pourrait aller.
Meta a comblé exactement cet écart, dans l'autre sens. Muse Spark 1.2 a été entraîné en même temps que l'outil. Le modèle et le harness ont été développés comme un seul artefact, ce qui explique que Meta puisse promettre des sessions de 24 heures et une reprise rejouable à l'identique — le modèle a été façonné pour bien se comporter dans ce runtime précis.
Les deux parties s'accordent donc sur le point technique de fond : le modèle et le harness sont couplés, et c'est dans ce couplage que se trouve la performance. Elles divergent sur qui doit posséder le couplage. Le pari de Prime Intellect est qu'un harness ouvert, portable et automodifiable accumule les améliorations plus vite qu'aucun laboratoire isolé, et que les modèles finiront par être entraînés pour des harnesses comme le sien. Le pari de Meta est que le co-entraînement est une douve, et que le meilleur agent sera toujours celui dont le modèle a grandi à l'intérieur.
Pourquoi cela vous concerne directement
Si le pari portable l'emporte, l'échafaudage de vos agents est un actif durable et changer de modèle reste bon marché — c'est dans votre harness qu'il faut investir. Si le pari co-entraîné l'emporte, votre échafaudage est un pont temporaire vers le laboratoire qui mène à un instant donné, et c'est dans la capacité à migrer qu'il faut investir. Ces deux options mènent à des décisions d'ingénierie différentes dès ce trimestre ; c'est pourquoi il vaut mieux avoir un avis que d'attendre la réponse.
Quatre réserves, car le chiffre va être beaucoup cité cette semaine sans elles.
La plupart des équipes qui lisent ceci ne devraient pas changer de harness cette semaine. Mais presque toutes devraient emprunter aux deux.
/grill — générer un plan, puis l'attaquer avant de l'exécuter — détecte la classe d'échecs où l'agent fait quarante étapes correctes vers un mauvais objectif. Relire le diff à la fin ne peut pas la détecter.La semaine dernière, j'écrivais que les lacunes de Qwen3.8-Max dans les benchmarks ne relevaient pas de l'intelligence brute — 92,6 sur GPQA Diamond, c'est le niveau des modèles de pointe —, mais du travail agentique au long cours, où un modèle doit tenir un plan sur quarante étapes et se remettre de ses propres erreurs. Cette semaine, deux laboratoires ont livré des produits qui s'attaquent précisément à cette lacune, et aucun ne l'a fait en rendant le modèle plus intelligent.
C'est la tendance à retenir. La distance qui reste entre une démo impressionnante et un système qui tient face à une vraie charge de travail se comble par l'ingénierie : état durable, reprise possible, gestion du contexte, délégation qui ne perd pas ce qu'elle a appris, un plan que quelqu'un a contesté avant l'exécution. Rien de tout cela n'arrive dans un checkpoint. Tout cela est réalisable par une équipe compétente, ce qui signifie que c'est à votre portée, et que l'avantage n'expire pas à la sortie du prochain modèle.
L'implication dérangeante, c'est que si votre agent est en dessous des attentes, le modèle n'est probablement pas votre problème. Changer de checkpoint est l'expérience la plus facile, et donc celle que la plupart des équipes tentent en premier. C'est rarement celle qui fait bouger le chiffre. Construisez le journal, corrigez la délégation, contestez le plan — puis allez faire vos courses de modèles.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.