
Qwen3.8-Max : Alibaba ouvre un modèle de 2,4T et le facture comme un modèle fermé (2026)

By Surya Pratap
6 août 2026
12 min read
AI & Technology

6 août 2026
12 min read
Le 3 août, Alibaba a publié Qwen3.8-Max : 2,4 billions de paramètres au total, 95 milliards actifs par token, une fenêtre de contexte d'un million de tokens, et du texte, de l'image et de la vidéo en entrée. C'est le plus grand modèle jamais livré par l'équipe Qwen, et c'est le premier Qwen de classe Max dont Alibaba a annoncé l'ouverture des poids.
Deux détails sont plus intéressants que le nombre de paramètres. Le premier, c'est le prix : 2 dollars par million de tokens en entrée, 6 dollars par million en sortie. Ce n'est pas une remise. C'est à peu près ce que facturent les laboratoires fermés américains, de la part d'une entreprise dont tout l'argument concurrentiel depuis deux ans consistait à casser leurs prix. Le second, c'est qu'à l'heure où j'écris, les poids ne sont pas sur Hugging Face et aucun texte de licence n'a été publié — l'annonce disait « la semaine prochaine ».
Ces deux éléments en disent plus sur la suite à donner que le tableau des benchmarks. Voici la lecture honnête.
Qwen3.8-Max est un modèle creux à mélange d'experts : 2,4T au total, environ 95 milliards activés par token, ce qui explique qu'il puisse être servi à un prix sans rapport avec sa taille. La fenêtre de contexte est de 1M de tokens — 991 000 en entrée au maximum, ramenés à 983 000 avec le raisonnement activé, 131 000 en sortie au maximum, et un budget de raisonnement qui peut aller jusqu'à 262 000 tokens. Les entrées sont du texte, de l'image et de la vidéo ; la sortie est uniquement textuelle.
L'API est disponible immédiatement via Alibaba Cloud Model Studio et QwenCloud, dans les formats compatibles OpenAI et DashScope, ainsi qu'avec le protocole d'Anthropic. Les limites de débit publiées sont généreuses : 2M de tokens par minute, 15 000 requêtes par minute. L'appel de fonctions, les sorties structurées, le traitement par lots, la complétion de préfixe et le fine-tuning sont tous pris en charge, ainsi que cinq outils intégrés — interpréteur de code, recherche web, extracteur web, et recherche d'image à image et de texte à image.
C'est sur le cache que la tarification devient intéressante. Les lectures de cache implicite coûtent 0,25 dollar par million de tokens, un huitième du prix hors cache. La création de cache explicite coûte 2,50 dollars, avec des lectures à 0,17. Pour un agent qui rejoue un gros préfixe stable à chaque tour, c'est la ligne de facture qui décide si un workflow est abordable.
Un second checkpoint, Qwen3.8-27B, a été annoncé en même temps et doit lui aussi sortir avec des poids ouverts. Il n'a encore ni fiche technique, ni tableau de benchmarks, ni prix. Gardez cela en tête : pour la plupart des lecteurs, c'est le 27B qui compte, et c'est celui dont on sait le moins.
Alibaba a publié une large série de comparaisons. Lisez-la comme deux histoires différentes, parce que c'est ce qu'elle est.
| Benchmark | Qwen3.8-Max | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
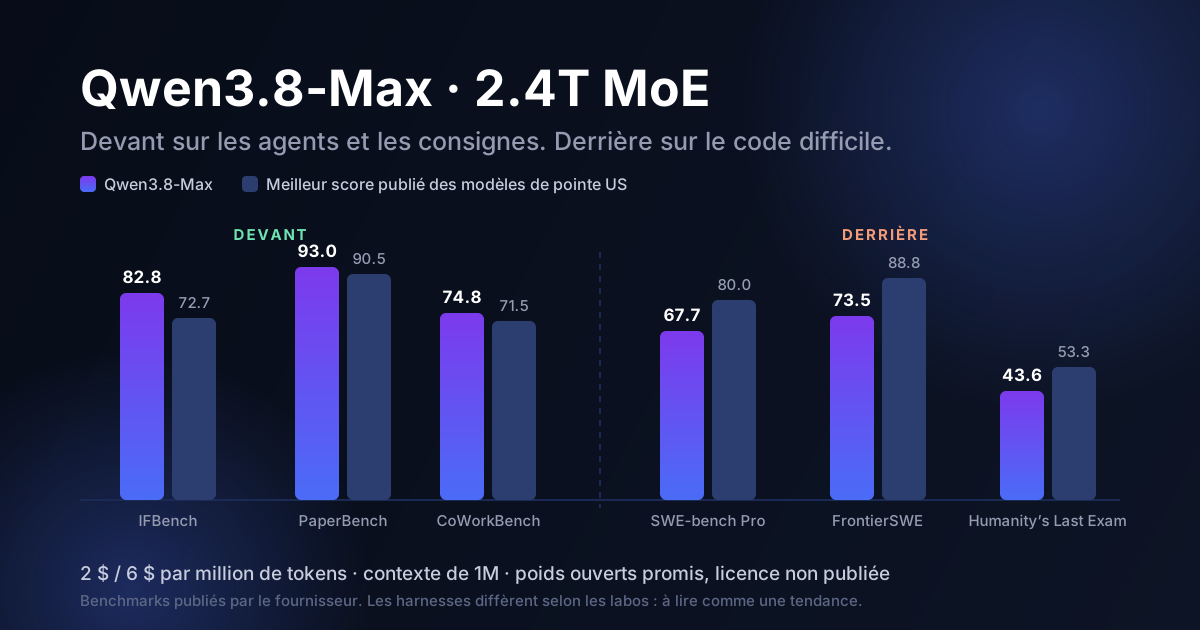
| IFBench (suivi d'instructions) | 82,8 | 72,7 | 63,5 |
| PaperBench | 93,0 | 90,5 | — |
| CoWorkBench | 74,8 | 71,5 | — |
| WorkSpaceBench | 67,7 | 65,6 | — |
| GPQA Diamond | 92,6 | — | — |
| OmniDocBench 1.5 | 92,1 | — | — |
| Terminal-Bench 2.1 | 86,6 | 88,8 | — |
| SWE-bench Pro | 67,7 | — | 80,0 |
| DeepSWE 1.1 | 56,6 | — | 70,0 |
| FrontierSWE | 73,5 | — | 88,8 |
| Humanity's Last Exam | 43,6 | 47,2 | 53,3 |
| MRCR v2 (long contexte) | 92,9 | 93,8 | — |
Le schéma est assez net pour router dessus. Qwen3.8-Max mène sur le suivi d'instructions, la compréhension de documents, le rappel en long contexte et le travail agentique de bureau bien délimité. Il est en retrait, de deux chiffres, sur le génie logiciel difficile et le raisonnement ouvert — 12 points de moins sur SWE-bench Pro, 15 sur FrontierSWE, 13 sur DeepSWE, 10 sur Humanity's Last Exam.
IFBench mérite un second regard, car c'est le chiffre le plus sous-estimé du tableau et celui qui touche le plus directement la fiabilité en production. 82,8 contre 72,7 et 63,5, ce n'est pas une avance marginale. Le suivi d'instructions décide si votre schéma JSON revient valide, si le modèle s'arrête quand on le lui demande, si l'appel d'outil a la forme qu'attend votre harness. Dix points d'avance sur ce terrain se voient dans votre taux d'erreur avant de se voir dans n'importe quelle démo de capacités.
Les résultats spectaculaires sont spectaculaires. Dans un benchmark de commerce en ligne simulé sur 365 jours, le modèle a terminé avec 416 252 ¥, environ 38 % de plus que GLM 5.2 et plus du double de Qwen3.7-Max. Dans une tâche de conception de puce, il a réduit un accélérateur cryptographique de 8 298 portes logiques à 678, soit 81 % de surface de silicium en moins. Prenez-les comme des démonstrations de capacités, pas comme des preuves sur votre charge de travail.
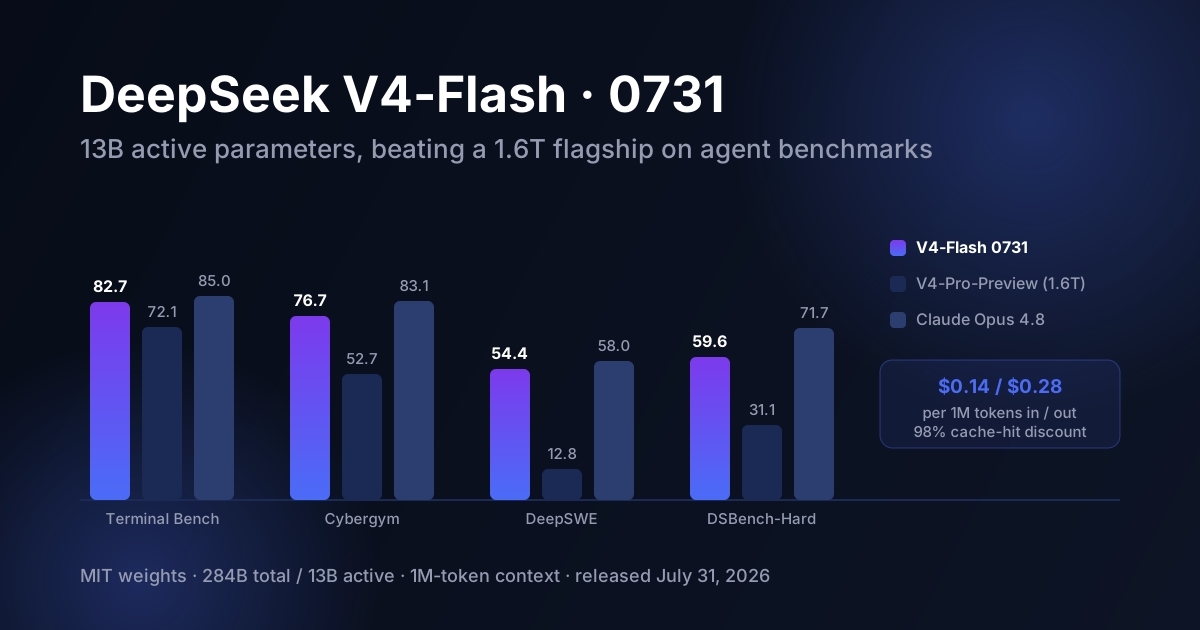
Mettez Qwen3.8-Max à côté de ce qui est sorti de Chine trois jours plus tôt. V4-Flash de DeepSeek coûte 0,14 dollar en entrée et 0,28 en sortie. Qwen3.8-Max coûte 2 et 6 dollars — quatorze et vingt et une fois plus cher, venant du même écosystème au sens large, la même semaine.
C'est un positionnement délibéré, et il marque un tournant. Pendant deux ans, les laboratoires chinois ont rivalisé en étant nettement moins chers que les modèles de pointe. Alibaba vient d'y renoncer. Elle a aligné son prix sur celui des modèles fermés américains et laissé le tableau des benchmarks plaider sa cause. Le pari : les entreprises qui choisissent une plateforme d'agents se soucient davantage de savoir si le modèle accomplit la tâche que de savoir s'il coûte cinq fois moins.
Ce que cela signifie pour votre modèle de coûts
Si vous partiez du principe que « l'option chinoise à poids ouverts est toujours le niveau bon marché », ce postulat n'est plus fiable. Il existe désormais des modèles à poids ouverts aux deux extrémités de la courbe des prix, et l'étiquette ne vous dit rien de la facture. Chiffrez ce modèle précis face à votre trafic précis. La seule donnée indépendante qui vaille d'être citée ici : le Vals Index a mesuré Qwen3.8-Max à égalité avec Claude Opus 4.7, 66,1 contre 66,1 — pour un coût par test environ 2,3 fois inférieur. C'est un vrai avantage d'efficacité face aux modèles fermés de pointe, et en même temps très loin de l'économie de DeepSeek.
C'est la partie que la plupart des articles survolent. Trois choses sont vraies en même temps, et il vous faut les trois.
Un : les poids ne sont pas sortis. Alibaba les a promis pour « la semaine prochaine » sur Hugging Face et ModelScope. Au 6 août, rien n'a été publié pour aucun des deux checkpoints, et aucune date n'a été donnée. Une sortie promise est un élément de feuille de route, pas un actif sur lequel vous pouvez planifier. Les précédents vont dans les deux sens — Qwen3.6-35B-A3B et Qwen 4 Coder sont sortis sous Apache 2.0 dès le premier jour, mais Qwen3.6-Plus, Qwen3.7-Max et Qwen3.7-Plus sont tous restés fermés et uniquement accessibles par API. Cette sortie inverse ce second schéma, et les inversions méritent d'être confirmées avant de bâtir dessus.
Deux : aucun texte de licence n'a été publié. Des praticiens qui ont examiné l'annonce ont relevé d'apparentes interdictions géographiques couvrant les États-Unis, l'UE, le Royaume-Uni et la Corée, et Alibaba n'a rien clarifié. Tant que le fichier de licence n'existe pas, vous ne savez pas si vous obtenez de l'Apache 2.0, une licence communautaire restrictive, ou quelque chose avec des clauses territoriales qui le rendent inutilisable pour vos clients. Un modèle de 2,4T sous licence communautaire restrictive reste techniquement à « poids ouverts », tout en changeant complètement ce que vous avez le droit de livrer.
Trois : à 2,4 billions de paramètres, « vous pouvez le télécharger » ne veut presque rien dire pour une startup. Servir ce modèle demande au minimum huit GPU de classe H100 ou B200. Ce n'est ni un portable, ni une station de travail, ni une instance cloud que l'on lance pour essayer. Pour l'écrasante majorité des équipes, les poids ouverts ne changent rien sur le plan opérationnel : vous utiliserez l'API, exactement comme avec un modèle fermé. Ce que les poids achètent vraiment, c'est de l'optionalité pour les grandes entreprises soumises à des exigences de résidence des données, et une base pour le travail de distillation et de fine-tuning qui produira les modèles que vous finirez par exécuter.
C'est pourquoi le checkpoint intéressant est le 27B. C'est celui qui tourne sur du matériel qu'une startup possède, celui qu'on peut fine-tuner sur sa base de code, celui qui pourrait compter pour vos marges. Et il n'a pour l'instant aucune spécification publiée. Si Qwen3.8 finit par compter pour votre activité, ce sera probablement à travers ce modèle — guettez donc la fiche du 27B, pas le gros titre du Max.
reasoning_effort — sans avertissement et sans effet. Si votre harness envoie des requêtes au format OpenAI, vous ne configurez peut-être rien tout en croyant avoir configuré quelque chose. Vérifiez que le comportement change quand vous changez le paramètre ; ne vous fiez pas à l'absence d'erreur.Compte tenu de la forme des éléments disponibles, voici ce que je ferais vraiment.
La tentation, avec une sortie aussi importante, est de la lire comme une mise à jour du tableau des scores. Elle est plus utile comme indication de l'endroit où s'est déplacée la concurrence.
Pendant deux ans, les laboratoires chinois ont rivalisé sur les prix, et la question stratégique pour les fondateurs était de savoir jusqu'où le plancher descendrait. Alibaba vient de refuser ce jeu avec son modèle phare. Elle l'a aligné sur les prix des modèles fermés, a ouvert les poids d'un modèle que presque personne ne peut héberger soi-même, et a orienté toute la sortie vers les charges d'agents en entreprise — tâches de bureau, traitement documentaire, travail en long contexte, respect des consignes. DeepSeek continue de faire baisser le plancher ; Alibaba se bat pour le plafond. Ce sont deux guerres différentes, et elles se mènent désormais en même temps.
Concrètement, cela signifie que la couche des modèles continue de gagner en capacités à chaque niveau de prix, et de moins en moins à se différencier. Qwen3.8-Max sera dépassé d'ici un trimestre, probablement par un membre de la même famille. La décision de routage que vous prendrez cette semaine sera fausse d'ici deux. Ce n'est pas une raison d'ignorer les sorties — c'est une raison de construire de sorte qu'y répondre coûte peu : une gateway plutôt qu'un SDK câblé en dur, un jeu d'évaluation plutôt qu'une impression, des prompts organisés pour réutiliser le cache plutôt qu'assemblés au fil de l'eau.
Et il vaut la peine de remarquer ce que le verdict partagé des benchmarks dit à ce sujet. Les lacunes ne sont pas dans l'intelligence brute — 92,6 sur GPQA Diamond, c'est le niveau des modèles de pointe. Elles sont dans le travail logiciel agentique au long cours, les tâches où le modèle doit tenir un plan sur quarante étapes et se remettre de ses propres erreurs. C'est la même lacune que les fondateurs rencontrent un niveau plus haut dans le stack, quand la démo fonctionne et que la production ne fonctionne pas. Quel que soit le modèle vers lequel vous routez, c'est toujours le travail qui vous revient.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.