DeepSeek V4-Flash sort de preview et bat son propre modèle phare : le guide du fondateur (2026)

By Surya Pratap
4 août 2026
13 min read
AI & Technology

4 août 2026
13 min read
Le 31 juillet, DeepSeek a fait sortir V4-Flash de preview. Sur le papier, c'est le type de sortie le moins intéressant : pas de nouvelle architecture, pas de nouveau nombre de paramètres, pas de nouvelle fenêtre de contexte. Le modèle est sorti avec exactement le même corps de mélange d'experts 284B/13B qu'en avril. Ce qui a changé, c'est le post-entraînement.
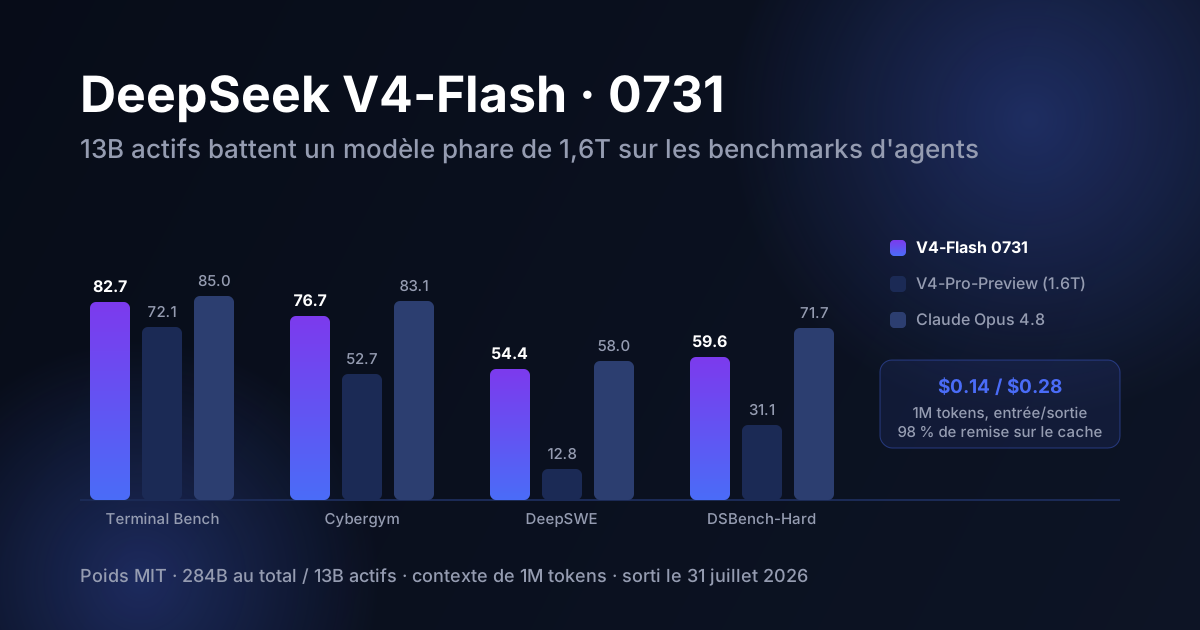
Et ce petit modèle, post-entraîné à nouveau, dépasse désormais le propre modèle phare de DeepSeek, le V4-Pro-Preview à 1 600 milliards de paramètres, sur les neuf benchmarks d'agents publiés — avec des écarts de 8,7 à 41,6 points. Il coûte 0,14 dollar par million de tokens en entrée et 0,28 par million en sortie. Il est sous licence MIT. Vous pouvez télécharger les poids.
Il y a là une vraie leçon pour quiconque construit un produit d'IA, et ce n'est pas « passez à DeepSeek ». Elle porte sur l'origine réelle des capacités en 2026, et sur ce que cela fait à l'hypothèse — encore intégrée aux modèles de coûts de la plupart des fondateurs — selon laquelle un meilleur comportement d'agent exige un modèle plus gros et plus cher.
L'entrée du journal des modifications est courte et mérite d'être lue au pied de la lettre. L'endpoint deepseek-v4-flash sert désormais la version 0731. L'architecture et la taille sont inchangées par rapport à la preview ; le modèle a été post-entraîné à nouveau, avec un module de décodage spéculatif DSpark ajouté pour le débit. Il a gagné la prise en charge native du format de la Responses API d'OpenAI et une adaptation à Codex dès le premier jour. Le contrôle du raisonnement est passé à trois niveaux explicites — low, high, max —, ce qui correspond à la forme qu'attendent les harnesses d'agents de reasoning_effort.
Les caractéristiques sous-jacentes : 284B paramètres au total dont 13B activés, une fenêtre de contexte de 1M de tokens avec jusqu'à 384 000 tokens en sortie, une pile d'attention hybride combinant attention creuse compressée et attention fortement compressée, des experts en FP4 et du FP8 ailleurs, et environ 167 Go de poids sur disque sous licence MIT. Les anciens identifiants deepseek-chat et deepseek-reasoner ont été retirés le 24 juillet, si bien que seuls les deux endpoints V4 fonctionnent désormais.
Le contexte commercial compte aussi. DeepSeek a levé 7,4 milliards de dollars pour une valorisation d'environ 350 milliards de yuans, avec la participation de Tencent et NetEase, et a indiqué que l'argent servirait à doubler à peu près ses effectifs, en se concentrant sur les agents. La version preview de Flash avait déjà passé sept semaines consécutives comme modèle le plus utilisé sur OpenRouter. Ce n'est pas un laboratoire qui sort une curiosité.
Voici les chiffres d'agents publiés, avec la version preview incluse pour que vous voyiez quelle part du gain vient du post-entraînement plutôt que du marketing.
| Benchmark | Flash 0731 | Flash Preview | V4-Pro-Preview | Opus 4.8 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 | 85,0 |
| Cybergym | 76,7 | 38,7 | 52,7 | 83,1 |
| DeepSWE | 54,4 | 7,3 | 12,8 | 58,0 |
| NL2Repo | 54,2 | 39,4 | 38,5 | 69,7 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 | 76,2 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 | 71,6 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 | 71,7 |
| Agents' Last Exam | 25,2 | 15,8 | 16,5 | 25,7 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 | 27,2 |
Deux choses sautent aux yeux. La première, c'est DeepSWE : de 7,3 à 54,4 avec des poids identiques. Un saut aussi grand signifie généralement que le modèle preview savait faire la tâche mais qu'on ne lui avait jamais appris le harness — il échouait sur le format, la discipline des appels d'outils et le fait de savoir quand s'arrêter, pas sur le raisonnement. Le post-entraînement a réparé l'interface, et la capacité qui était déjà là est apparue.
La seconde, c'est la colonne Opus 4.8. Flash 0731 est proche sur Terminal Bench (82,7 contre 85,0), Agents' Last Exam (25,2 contre 25,7) et DeepSWE (54,4 contre 58,0) — et nettement derrière sur les deux plus difficiles : NL2Repo (54,2 contre 69,7) et DSBench-Hard (59,6 contre 71,7). Ce schéma est cohérent, et c'est lui qui devrait guider votre routage. L'écart se referme sur les tâches d'agent bien délimitées et bien spécifiées. Il reste ouvert sur le travail long, ambigu, à l'échelle du dépôt entier, où une mauvaise décision à l'étape 40 vous coûte l'exécution.
Les mesures indépendantes vont à peu près dans le même sens. Artificial Analysis place V4-Flash 0731 à 50 sur son Intelligence Index — troisième parmi les modèles à poids ouverts, pour une médiane de 25, au niveau de Gemini 3.6 Flash et derrière Claude Opus 5, à environ 59. La vitesse de sortie est de 113,5 tokens par seconde, contre une médiane de 61,4 chez ses pairs, avec un délai jusqu'au premier token de 1,31 seconde.
Les benchmarks font les gros titres ; la ligne de prix est ce qui change ce que vous pouvez construire. Artificial Analysis a mesuré le coût d'exécution de toute la batterie de son Intelligence Index sur chaque modèle :
C'est un écart d'environ cent fois pour un écart de capacités de neuf points sur un indice de cent. L'économie du cache est encore plus agressive : une lecture en cache coûte 0,003 dollar par million de tokens, une remise de 98 %, la plus forte du secteur. Si votre agent rejoue à chaque tour un gros prompt système stable et un corpus fixe — ce que font la plupart des agents en production —, cette remise n'est pas une erreur d'arrondi : c'est la différence entre un workflow que vous pouvez proposer dans une offre à 29 dollars et un workflow que vous ne pouvez pas proposer du tout.
DeepSeek a aussi réduit le coût de son API jusqu'à 50 % avec cette sortie, et le schéma est désormais assez connu pour qu'Axios le présente comme une course vers zéro, en observant que les baisses de prix incessantes des laboratoires chinois mettent sous pression les futures IPO d'OpenAI et d'Anthropic. Que cette thèse se vérifie ou non, la conséquence opérationnelle pour vous est immédiate : le prix plancher d'un travail agentique compétent a encore baissé, et tout modèle tarifaire construit sur l'hypothèse que l'inférence coûte cher a une durée de vie plus courte que prévu.
La taxe de la verbosité
Artificial Analysis signale V4-Flash comme « très verbeux » — il a consommé 210M de tokens de sortie sur son évaluation, contre une médiane de 100M chez ses pairs. Les tokens de sortie sont la moitié chère de la facture. Un modèle dont le prix de sortie est dix fois plus bas mais qui émet deux fois plus de tokens fait économiser cinq fois, pas dix, et votre ratio réel dépend de vos prompts. Mesurez le coût par tâche accomplie sur vos propres traces, pas le coût par million de tokens lu sur une page de tarifs.
Deuxième réserve : la tarification aux heures de pointe. DeepSeek a annoncé un multiplicateur de 2× entre 09h00 et 12h00 et entre 14h00 et 18h00, heure de Pékin. Il n'était pas encore en vigueur à la sortie, mais si votre trafic se concentre sur les matinées européennes ou américaines, modélisez le tarif multiplié plutôt que le tarif affiché avant d'engager une marge auprès d'un client.
Troisième réserve, la moins commentée : ce sont des benchmarks d'agents, et les benchmarks d'agents récompensent précisément ce qui vient d'être post-entraîné. Un saut de 41 points sur DeepSWE dû au seul nouveau post-entraînement devrait vous rendre un peu plus méfiant envers le benchmark, et pas seulement plus impressionné par le modèle. Il vous dit que le score est très sensible à l'adéquation avec le harness. Votre harness n'est pas le leur. Faites tourner votre propre jeu d'évaluation — le petit, construit à partir de vraies tâches d'utilisateurs — avant de router du trafic de production vers quoi que ce soit de nouveau.
La comparaison n'est pas tout à fait équitable, et comprendre pourquoi est la partie utile. Flash 0731 est un produit fini, réglé pour les agents. V4-Pro-Preview est une preview — une démonstration de capacités de base qui n'a pas reçu le même traitement. DeepSeek affirme que la sortie officielle de V4-Pro est imminente, avec la prise en charge de la Responses API et de Codex début août, et quand elle arrivera, l'ordre s'inversera presque certainement de nouveau.
Mais « la comparaison n'est pas équitable », c'est le constat. Ce qui a séparé les deux modèles sur neuf benchmarks, ce n'est pas mille cinq cents milliards de paramètres de capacité brute en plus. C'est le fait que quelqu'un ait appris ou non au modèle à se comporter dans une boucle d'agent : quand appeler un outil, comment formater l'appel, quand arrêter de raisonner pour agir, comment se remettre d'une étape ratée. L'échelle a acheté la capacité sous-jacente. Le post-entraînement l'a convertie en tâches accomplies.
Cela correspond presque exactement à ce que les fondateurs ne cessent de découvrir un niveau plus haut dans le stack. La démo fonctionne parce que le modèle est capable. La production échoue parce que rien autour du modèle ne sait faire tourner une boucle de façon fiable — la même raison pour laquelle l'ingénierie du contexte, les jeux d'évaluation et les systèmes de permissions finissent toujours par compter davantage que le modèle de pointe que vous avez choisi. DeepSeek vient de démontrer le même principe à l'intérieur même des poids.
V4-Pro est le grand frère de 1,6T, publié en preview à poids ouverts sous licence MIT le 24 avril et facturé 0,435 $/0,87 $ par million de tokens. Il obtient environ 80,6 sur SWE-bench Verified en mode de raisonnement maximal — compétitif, pas en tête. Sur le plan de l'efficacité, l'architecture est réellement impressionnante : avec un contexte de 1M de tokens, V4-Pro n'aurait besoin que d'environ 27 % des FLOPs d'inférence par token et de 10 % du cache KV qu'exigeait V3.2, ce qui rend un contexte d'un million de tokens économiquement plausible et pas seulement affiché.
Une comparaison de coûts tirée d'une analyse de praticien mérite d'être retenue : l'implémentation d'une fonctionnalité représentative de taille moyenne coûte environ 0,12 $ avec V4-Pro, contre environ 10,00 $ sur un niveau premium de pointe. Même en tenant compte de la réserve sur la verbosité et du taux d'échec que vous observez, c'est une autre catégorie d'économie unitaire — et c'est la raison pour laquelle « utiliser le meilleur modèle pour tout » a cessé d'être un choix par défaut défendable il y a environ un an.
La tentation, avec une sortie comme celle-ci, est d'y voir un signal d'achat pour un fournisseur. Ce n'en est pas un. DeepSeek est derrière le Kimi K3 de Moonshot et ses 2 800 milliards de paramètres, Kimi sera dépassé en prix par quelque chose en octobre, et le modèle compétent le moins cher d'un mois donné est une cible mouvante sur laquelle vous ne devriez jamais bâtir l'identité d'un produit.
Ce qui dure, c'est la direction. Les capacités à prix donné baissent vite, le niveau des poids ouverts est désormais assez proche des modèles de pointe sur le travail agentique délimité pour que le choix soit une décision de routage plutôt qu'une décision de qualité, et le coût marginal de la couche des modèles tend vers le plancher. Si l'avantage de votre produit, c'est d'avoir accès à un bon modèle, cet avantage est en train de se dévaloriser en public, sortie après sortie.
L'avantage qui survit est précisément celui dont DeepSeek vient de prouver l'importance : le travail consistant à rendre fiable un système capable dans une boucle précise, sur un domaine précis, pour un utilisateur précis. C'était l'écart entre 7,3 et 54,4 avec les mêmes poids. C'est aussi, à peu de chose près, l'écart entre une démo d'IA et une entreprise d'IA.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.