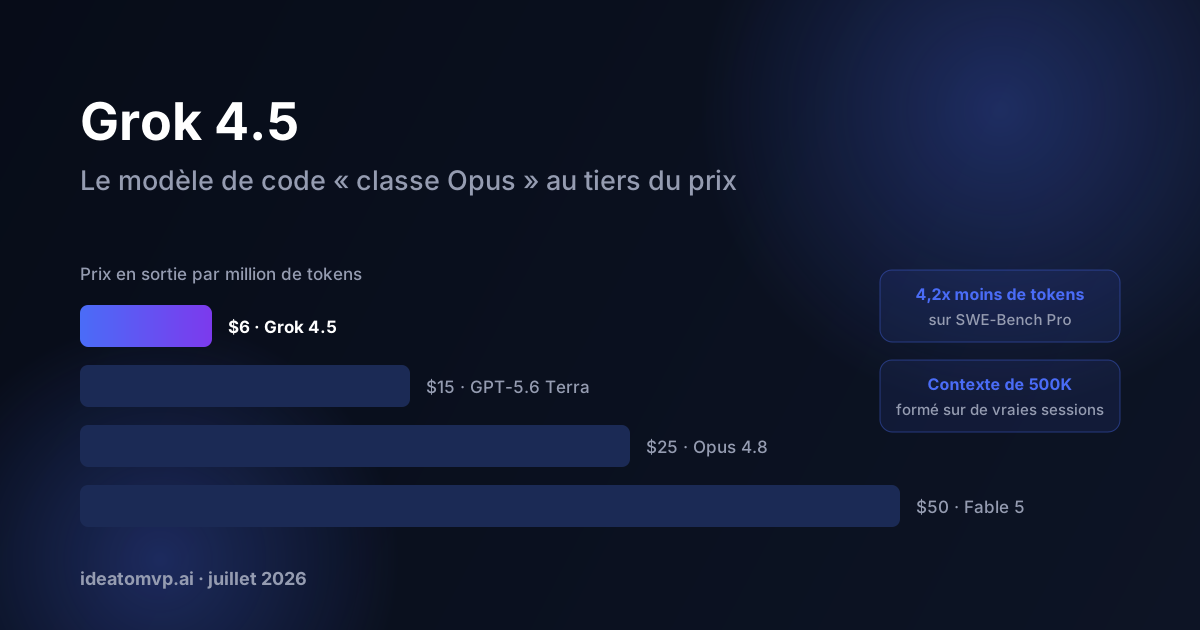
Juillet 2026 restera comme le mois où la guerre des modèles est devenue une guerre des prix. La veille de la sortie de GPT-5.6 par OpenAI, xAI a publié Grok 4.5, son premier modèle entraîné spécifiquement pour le code et les agents autonomes, à $2 par million de tokens en entrée et $6 par million en sortie. Le positionnement d'Elon Musk était, comme à son habitude, sans détour : « C'est un modèle de classe Opus, mais plus rapide, plus sobre en tokens et moins cher. » Pas le modèle le plus intelligent du monde : le plus économique parmi ceux qui sont assez bons pour un vrai travail d'ingénierie.
Ce positionnement, « moins cher et suffisant » assumé comme stratégie et non comme excuse, est inédit pour un laboratoire de pointe, et les réactions sur X et LinkedIn pendant la semaine du lancement se sont partagées exactement selon cette ligne. Voici ce qu'est réellement le modèle, ce qu'en disent les premiers utilisateurs, et comment un fondateur devrait l'aborder.
Ce qu'est vraiment Grok 4.5
- Un modèle conçu d'abord pour le code et les agents. xAI l'a entraîné sur des données de vraies sessions de développeurs issues de son partenariat avec Cursor : des sessions complètes dans de vraies bases de code, pas seulement des corpus de code statiques. L'objectif de conception est un agent qui tient une longue session sans dérailler.
- $2 / $6 par million de tokens, 500K de contexte. C'est plus de 60 % moins cher qu'Opus 4.8 et GPT-5.5 au prix catalogue, avec l'entrée en cache à $0.50.
- Extrêmement sobre en tokens. Sur SWE-Bench Pro, xAI indique que Grok 4.5 résout les tâches avec en moyenne ~16K tokens de sortie, contre ~67K pour Opus 4.8 en mode max : un écart de 4,2 fois. Comme ce sont les tokens de sortie qui coûtent le plus, cette sobriété démultiplie la remise affichée : Artificial Analysis l'a mesuré à $0.49 par tâche accomplie, près de 90 % moins cher que les modèles placés au-dessus de lui dans son classement.
Les benchmarks, lus honnêtement
Le tableau honnête est contrasté, et d'autant plus intéressant. Sur l'Intelligence Index d'Artificial Analysis, Grok 4.5 obtient 54, quatrième au classement général, derrière Fable 5 (60), Opus 4.8 (56) et GPT-5.5 (55). Sur les quatre benchmarks que xAI a choisi de publier, il bat Opus 4.8 sur deux (DeepSWE 1.0 et Terminal-Bench 2.1) et perd sur deux (DeepSWE 1.1 de 6 points, SWE-Bench Pro de 4.5).
Autrement dit : ce n'est pas le meilleur modèle. C'est un modèle légitimement proche de la frontière pour une fraction du coût par tâche, et xAI ne prétend pas le contraire. Musk lui-même a présenté l'objectif comme « boucler la boucle de l'utilité réelle, pas des benchmarks », en citant les ingénieurs les plus exigeants de Tesla et de SpaceX qui le trouvent réellement utile.
Ce que disent X et LinkedIn
- Les premiers utilisateurs de Cursor sont impressionnés. La critique la plus partagée, celle du développeur Danny Limanseta, l'a décrit comme « Opus 4.8 deux fois plus rapide et bien moins cher », après une session complète de brainstorming, de planification et d'implémentation d'une fonctionnalité de jeu complexe, sans aucune correction manuelle entre les étapes.
- La lecture sur LinkedIn porte sur le modèle économique. Le commentaire qui a le plus circulé ne parlait pas du tout de capacités : il soulignait qu'un laboratoire de pointe rivalise désormais avant tout sur le prix par tâche accomplie, une métrique que les analystes présentaient comme capable d'ébranler la structure de marge d'Anthropic comme d'OpenAI.
- Les sceptiques pointent le choix des benchmarks. Publier les deux benchmarks que l'on gagne à côté des deux que l'on perd apporte un peu de crédibilité, mais des critiques sur X ont relevé que « classe Opus » se compare au niveau précédent d'Anthropic, pas à Fable 5. Musk lui-même parlait de « à peu près Opus 4.7 ».
Le chiffre qui compte : le coût par tâche accomplie
Le prix par token est l'étiquette ; le coût par tâche accomplie est la facture. Un modèle 20 % moins capable, qui utilise 4 fois moins de tokens et coûte 60 % moins cher par token, l'emporte économiquement sur chaque tâche qu'il parvient réellement à terminer. La bonne question n'est jamais « est-il plus intelligent ? », mais « quelle part de ma charge de travail peut-il accomplir, et à quel coût par tâche accomplie ? ».
La place de Grok 4.5 dans la pile d'une startup
- Le poste d'exécutant vient de gagner un sérieux prétendant. Dans la pile planifier → exécuter → relire présentée la semaine dernière, Grok 4.5 se place pile au niveau de l'exécution, avec plus de capacités que les exécutants bon marché habituels. Pour les boucles de développement agentique où la consommation de tokens fait mal, son profil de sobriété est exactement ce que réclamaient ceux qui dépensent $200 par jour.
- Les longues sessions sont son terrain. Entraîné sur de vraies sessions complètes, avec 500K de contexte, il est fait pour le schéma « continue à travailler dans cette base de code pendant une heure », pas pour des extraits ponctuels. Évaluez-le d'abord sur vos workflows d'agents les plus longs.
- Gardez pour l'instant la planification et la relecture ailleurs. La quatrième place en intelligence générale est excellente pour ce prix, mais les décisions d'architecture et la relecture finale reviennent toujours au meilleur raisonneur que vous pouvez vous offrir, et la relecture par une autre famille de modèles compte davantage, pas moins, à mesure que chaque laboratoire optimise plus fort pour les benchmarks agentiques.
- Profitez de la guerre des prix à trois. Grok 4.5 le 8 juillet, GPT-5.6 le 9 juillet, Anthropic qui réinitialise ses quotas dans l'heure : trois laboratoires de pointe se disputent votre charge de travail la même semaine. Si vous avez figé vos tarifs avec votre fournisseur d'IA il y a plus d'un trimestre, vous payez trop cher.
En résumé
Grok 4.5 est le signal le plus clair à ce jour que la frontière se scinde en deux courses : l'une pour l'intelligence maximale, l'autre pour le coût minimal par tâche accomplie. Les fondateurs n'ont pas à choisir leur camp : une pile bien routée profite des deux. Placez Grok 4.5 à votre niveau d'exécution, faites-le tourner une semaine sur vos vraies charges de travail, et laissez les chiffres, pas les tweets de lancement, décider de la part de travail qu'il mérite.
Besoin d'aide pour comparer les nouveaux modèles sur les charges de travail réelles de votre produit ? Réservez un appel de découverte gratuit : chaque mois, nous construisons et ajustons des piles de routage de modèles pour des fondateurs.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.