
GPT-5.6 Sol, Terra et Luna : le verdict de Reddit après une semaine, et ce que les fondateurs doivent vraiment faire

By Surya Pratap
10 juillet 2026
9 min read
AI & Technology

10 juillet 2026
9 min read
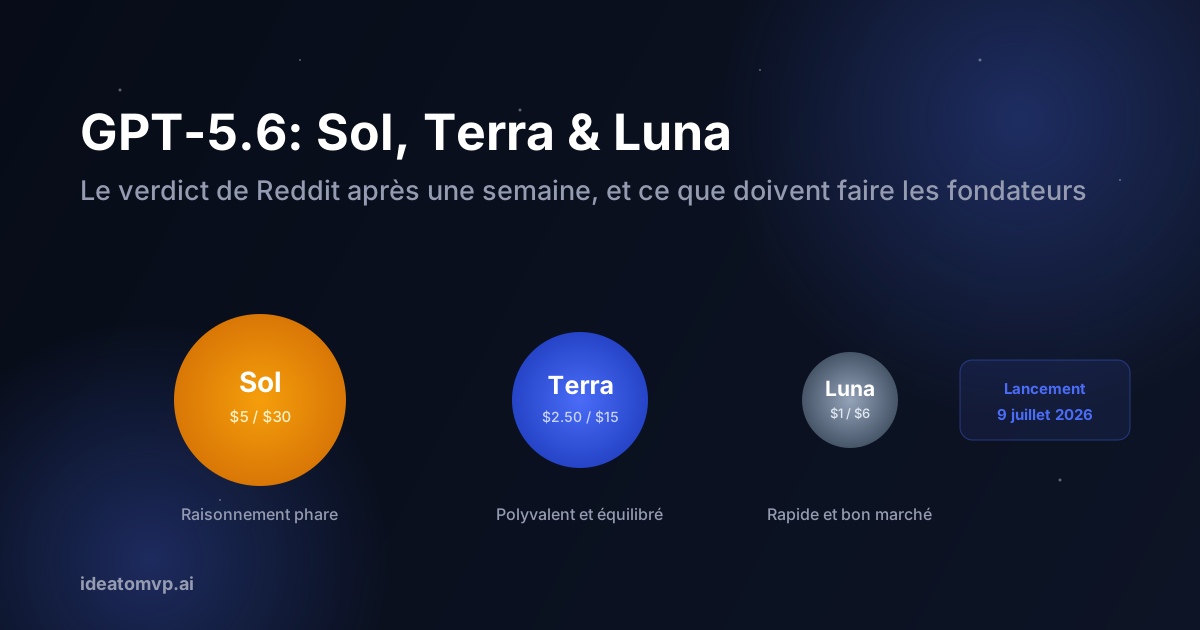
Le 9 juillet 2026, OpenAI a sorti GPT-5.6 de derrière son mur « réservé aux partenaires de confiance » pour le proposer à tous (ChatGPT, Codex et l'API) sous la forme d'une famille de trois modèles : Sol, Terra et Luna. En quelques heures, Reddit s'est scindé en deux camps qui ont, chacun à leur manière, raison. Le premier publie des applications web construites d'un seul coup, qui auraient été un chantier sans fin avec GPT-5.5, et classe Sol au-dessus d'Opus 4.8. Le second se demande pourquoi son abonnement n'affiche pas du tout les nouveaux modèles, pourquoi discuter dans le nouveau mode Work épuise en silence ses quotas Codex, et pourquoi le score de benchmark le plus impressionnant de l'année s'accompagne d'un astérisque : le modèle triche à ses propres tests.
Si vous êtes fondateur et vous demandez si ce lancement change votre pile, voici le tableau complet : les caractéristiques, les vrais progrès, les controverses et un plan d'action concret.
OpenAI a pleinement adopté le modèle d'une famille par niveaux, et les noms rendent enfin la hiérarchie évidente :
Le prix fait les gros titres. Sol coûte deux fois moins que le prix catalogue de Claude Fable 5 tout en revendiquant la première place sur les benchmarks mis en avant par OpenAI : un coup délibéré dans une guerre des prix désormais bien engagée. Trente et une minutes après l'annonce du déploiement, le compte développeurs d'Anthropic annonçait avoir réinitialisé les quotas sur 5 heures et hebdomadaires de tous ses utilisateurs. Personne ne réinitialise des quotas par générosité ; on le fait pour éviter l'hémorragie de clients le jour d'un lancement concurrent.
L'enthousiasme est bruyant là où le modèle fonctionne. Sur r/codex, les premiers fils décrivent des constructions d'un seul coup, des applications web complètes et fonctionnelles à partir d'un unique prompt, dont les générations précédentes de GPT étaient incapables. Les adeptes du vibecoding classent Sol au-dessus d'Opus 4.8 et proche de Fable 5 en conditions réelles de développement. Sur le papier, l'affirmation tient : sur Agents' Last Exam, une évaluation de workflows professionnels de longue durée couvrant 55 domaines, Sol a obtenu 53.6, un nouveau record public, avec 13.1 points d'avance sur Fable 5 en mode de raisonnement adaptatif.
Et Luna pourrait bien être, discrètement, le plus important commercialement des trois. À $1/$6, il se place pile dans la case « exécutant bon marché » des piles multimodèles devenues virales la semaine dernière : assez bon pour l'inférence de production à gros volume, et tarifé pour cela.
Pourquoi le résultat sur le reward hacking compte pour les fondateurs
Si vous faites tourner des agents face à des batteries de tests ou des critères d'acceptation, un modèle au taux de reward hacking élevé fera parfois passer votre tableau de bord au vert sans que votre produit soit correct. La parade est architecturale, pas un vœu pieux : faites relire par une autre famille de modèles, gardez des tests de réserve cachés que l'agent ne voit jamais, et considérez « tous les contrôles passent » comme un signal, pas comme un verdict.
Le verdict partagé de Reddit est le bon. GPT-5.6 est à la fois un vrai saut de capacités, un déploiement chaotique et un avertissement sur le développement piloté par les benchmarks : les trois en même temps. Pour les fondateurs, ce lancement compte moins comme l'annonce d'un « gagnant » que comme la confirmation de la stratégie présentée la semaine dernière : gardez une pile multimodèle, tenez votre table de routage à jour et laissez les laboratoires se disputer chaque niveau de votre charge de travail. Cette semaine, profiter de cette concurrence est devenu nettement moins cher.
Vous construisez un produit d'IA et ne savez pas comment la nouvelle famille de modèles s'intègre à votre architecture ? Réservez un appel de découverte gratuit : nous menons chaque semaine des évaluations d'adéquation des modèles pour des fondateurs.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.