
AWS a laissé des agents construire un émulateur de son cloud sans relecture humaine du code. La relecture est passée dans les tests

By Surya Pratap
13 novembre 2026
8 min read
AI & Technology

13 novembre 2026
8 min read
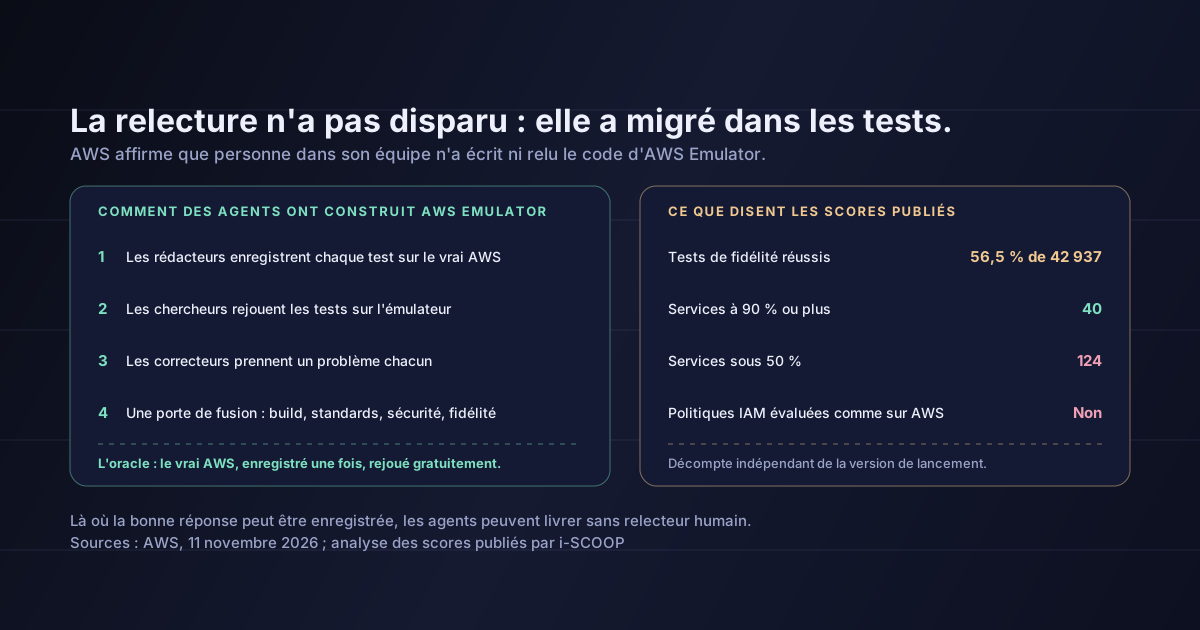 Voir le processus et les scoresHover to explore
Le 11 novembre, AWS a publié AWS Emulator, un substitut local de ses services que vous pouvez faire tourner sur votre ordinateur portable pour construire et tester des applications sans appeler le cloud. L'outil est utile, mais c'est l'affirmation qui l'accompagnait qui compte le plus pour les fondateurs. Selon Matthew Goldberg, l'ingénieur principal senior qui a signé l'annonce : « L'émulateur a été entièrement écrit par des agents autonomes. Notre équipe n'a ni écrit ni relu la moindre ligne du code. » La plupart des startups ont découvert cette année que la relecture humaine est l'étape la plus lente d'une équipe qui s'appuie largement sur des agents. AWS a montré une façon de la supprimer, et ce sont les conditions qui l'ont permis qui sont utiles.
AWS décrit le produit simplement : « un émulateur local des services AWS que vous pouvez exécuter sur votre machine pour construire et tester vos applications AWS ». La presse ajoute les détails :
AWS explique que l'émulateur « est fondamentalement construit par trois équipes d'agents. Une équipe gère une suite de tests ; une autre trouve les problèmes dans l'émulateur ; et une autre corrige ces problèmes ». Une quatrième étape décide de ce qui est publié.
L'échelle est importante. AWS affirme que « des centaines d'agents travaillent simultanément sur le code » et qu'elle a « vu des milliers de problèmes corrigés chaque jour ». Le projet a commencé comme une expérience de week-end : un serveur web vide qui acceptait les requêtes pour tous les modèles d'API « mais ne faisait rien », avec la suite de tests pour spécification.
Personne n'a supprimé la relecture. AWS l'a déplacée d'une personne qui lit des diffs vers une suite de tests vérifiés contre le système réel.
Le billet d'AWS ne donne aucun taux de réussite ; il promet un billet ultérieur sur la manière de mesurer la fidélité. Help Net Security rapporte qu'AWS publie des scores de fidélité par service à chaque version, et i-SCOOP les a décomptés pour la version de lancement. Ses résultats :
Il faut lire ces chiffres avec la mise en garde d'i-SCOOP lui-même : « un test ne réussit que si l'émulateur renvoie exactement ce qu'AWS a renvoyé », et « un test en échec signifie souvent un message d'erreur erroné, pas un service cassé ». Son résumé est juste : un émulateur rapide et gratuit « qui reproduit en grande partie correctement les chemins courants des services populaires ».
Les limites sont plus claires que les scores. Help Net Security rapporte que l'émulateur « n'évalue pas AWS Identity and Access Management (IAM) ni les politiques basées sur les ressources comme le fait AWS », garde tout en mémoire et doit être utilisé avec une seule région et un seul compte. i-SCOOP ajoute qu'une requête qu'AWS refuserait peut réussir en local, et inversement.
Une condition a fait l'essentiel du travail : AWS disposait d'un oracle. Pour n'importe quelle requête, le vrai AWS donne la bonne réponse, et cette réponse peut être enregistrée une fois puis rejouée des milliers de fois gratuitement. Le changement d'un agent n'est pas jugé selon qu'un relecteur apprécie le diff. Il est jugé selon que l'émulateur correspond désormais au système qu'il copie. C'est un contrôle plus solide que la plupart des relectures humaines, et il ne se fatigue jamais.
La plupart du code d'une startup n'a pas d'oracle de ce genre. Personne ne peut enregistrer la bonne réponse à « ce parcours d'onboarding est-il bon ? » ou « cette page de tarifs est-elle juste ? ». Mais beaucoup de parties d'un produit en ont un, et ces parties peuvent se rapprocher du modèle d'AWS :
import json, pathlib

CASES = pathlib.Path("fidelity_cases")

def record(name: str, request: dict, call_real) -> None:
    """Run once against the real system and save its answer."""
    response = call_real(request)
    CASES.joinpath(f"{name}.json").write_text(
        json.dumps({"request": request, "expected": response}, indent=2))

def replay(call_ours) -> dict:
    """Run every saved case against our code; no calls to the real system."""
    results = {"pass": 0, "fail": []}
    for path in sorted(CASES.glob("*.json")):
        case = json.loads(path.read_text())
        if call_ours(case["request"]) == case["expected"]:
            results["pass"] += 1
        else:
            results["fail"].append(path.stem)
    return results

def gate(before: dict, after: dict) -> bool:
    """Merge only if nothing that passed before fails now."""
    newly_failing = set(after["fail"]) - set(before["fail"])
    return not newly_failing
Trouvez vos oracles. Listez les parties de votre code pour lesquelles une bonne réponse existe en dehors de lui : l'API d'un fournisseur, l'ancien système, un jeu de données de référence. Ce sont les parties où les agents peuvent travailler avec le moins de relecture humaine.
Enregistrez avant de déléguer. Capturez d'abord les réponses du système réel, comme l'ont fait les rédacteurs de tests d'AWS, et faites vérifier chacune contre la source. Un test qu'un agent écrit sans le vérifier contre le système réel ne fait que confirmer ce que l'agent croit déjà.
Filtrez sur les régressions, pas sur les goûts. Ne fusionnez que lorsque la compilation passe, que les contrôles de standards et de sécurité passent et que rien de ce qui réussissait avant n'échoue maintenant. Cette règle coûte peu à exécuter et se discute mal.
Publiez votre propre score. Suivez le taux de réussite par domaine et montrez-le à l'équipe. Un chiffre qui reconnaît 56,5 % est plus utile qu'une promesse d'exhaustivité, parce que chacun voit où faire confiance au code.
Gardez des humains là où il n'y a pas d'oracle : le jugement produit, les frontières de sécurité et tout ce qui touche aux permissions. Le résultat d'AWS va dans le même sens. Le seul domaine que l'émulateur ne cherche pas à reproduire, le contrôle d'accès, est justement celui où une mauvaise réponse est la plus dangereuse. En juillet, nous expliquions qu'une startup devrait recruter le relecteur avant le développeur. AWS Emulator affine ce conseil : recrutez le relecteur pour les parties sans oracle, et consacrez le reste de l'effort à en construire un. Pour les parties d'un produit d'IA où vous pouvez définir le bon comportement, commencez par un jeu d'évaluation fait de vraies tâches d'utilisateurs.
Si vous comptez utiliser AWS Emulator
Considérez-le comme une boucle locale rapide, pas comme la preuve que votre code fonctionne sur AWS. Ne l'utilisez pas pour tester le contrôle d'accès, car les politiques IAM et de ressources ne sont pas évaluées comme AWS les évalue. Utilisez une seule région et un seul compte, attendez-vous à ce que l'état disparaisse à l'arrêt, et consultez le score par service des services dont vous dépendez. i-SCOOP prévient aussi que si votre SDK ne pointe pas vers l'émulateur, il « appelle discrètement le vrai AWS avec les identifiants qu'il trouve ». Faites vos vérifications finales sur le vrai AWS.
Qu'aucun humain n'est intervenu. Selon AWS, aucun humain n'a écrit ni relu le code. Ce sont pourtant des personnes qui ont choisi l'oracle, conçu les trois équipes, fixé les standards de code et construit la porte de fusion. AWS l'attribue aux « garde-fous que nous avons mis en place ». Le travail humain s'est déplacé plus tôt dans le processus ; il n'a pas disparu.
Que 56,5 % signifie que la moitié de l'émulateur est cassée. Les tests exigent des correspondances exactes, messages d'erreur compris. Les chemins courants des services populaires obtiennent des scores bien plus élevés que la longue traîne.
Que votre produit peut faire de même. AWS disposait d'un système de référence parfait et peu coûteux à interroger, et du budget pour faire tourner des centaines d'agents. La plupart des startups n'ont ni l'un ni l'autre pour la plus grande partie de leur code. Reprenez la méthode là où vous avez un oracle, pas partout.
Que les chiffres sont définitifs. L'annonce d'AWS parle à la fois de « milliers » et de « centaines » d'agents, et les taux de réussite viennent d'un décompte externe d'une seule version, pas d'AWS. Attendez-vous à ce que les deux évoluent à mesure qu'AWS publiera davantage.
Le 11 novembre 2026, AWS a publié AWS Emulator, un émulateur local et gratuit de ses services, en affirmant que personne dans son équipe n'avait écrit ni relu le code. Des agents ont écrit des tests vérifiés sur le vrai AWS, d'autres les ont rejoués pour trouver les écarts, un troisième groupe a corrigé chaque problème, et une porte de fusion a contrôlé compilation, standards, sécurité et fidélité. Un décompte indépendant des scores au lancement a trouvé 56,5 % de réussite sur 42 937 tests de fidélité, avec de grands écarts entre services et sans évaluation des politiques IAM.
Pour les fondateurs, la leçon n'est pas que la relecture est dépassée. C'est que la relecture peut passer dans les tests quand on dispose d'une source fiable de bonnes réponses, et doit rester entre les mains de personnes quand on n'en a pas.
Cette semaine, choisissez une partie de votre code qui a un oracle, enregistrez-en vingt vraies réponses, et faites de « rien de ce qui réussissait n'échoue maintenant » une règle de fusion pour les changements des agents dans cette partie.
Sources : Matthew Goldberg, AWS, AWS Emulator: a local emulator built 100% by autonomous AI agents (11 novembre 2026) — la description du produit, les 438 modèles d'API, la licence CC0, les trois équipes d'agents, la porte de fusion, le nombre d'agents et de problèmes, et l'affirmation selon laquelle l'équipe n'avait ni écrit ni relu le code ; Anamarija Pogorelec, Help Net Security, AWS Emulator: Open-source tool for testing AWS apps locally, built by autonomous AI agents (12 novembre 2026) — les quatre façons de le lancer, les scores par service publiés à chaque version, et les limites concernant IAM, les régions, les comptes et la mémoire ; Tom Cuylaerts, i-SCOOP, AWS Emulator was built by AI agents nobody reviewed, and its own test scores show where to trust it (12 novembre 2026) — le décompte des scores au lancement, les chiffres par service, les mises en garde sur les correspondances exactes, la remarque sur les pull requests et le code tiers sous licence Apache, et l'avertissement sur les endpoints du SDK. Le code de la section 4 est une illustration de ma part, et l'analyse des sections 4 et 5 est la mienne.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.