Un tutor de IA igualó a tutores humanos expertos por 1/918 del coste. Era el modelo más barato de los probados

By Surya Pratap
2 de octubre de 2026
9 min read
AI & Technology

2 de octubre de 2026
9 min read
 Precio por punto, no por tokenHover to explore
La mayoría de las comparaciones entre modelos de IA tratan de lo que los modelos pueden hacer. Esta trata de lo que aprendieron las personas que los usaron, medido antes y después, frente a un grupo de control y frente a profesores humanos expertos. Su resultado más útil para los fundadores no tiene nada que ver con la educación.
Todo lo que sigue procede de «StudentBench: AI and human tutoring yield equivalent GRE learning gains», de Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner y Jonas Mueller, de Handshake AI Research, un preprint publicado el 23 de septiembre de 2026 y revisado el 30 de septiembre. Los datos anonimizados son de acceso abierto. Handshake también gestiona la plataforma de tutoría StudentBench que usó el estudio. La lectura a partir de la sección 3 es mía.
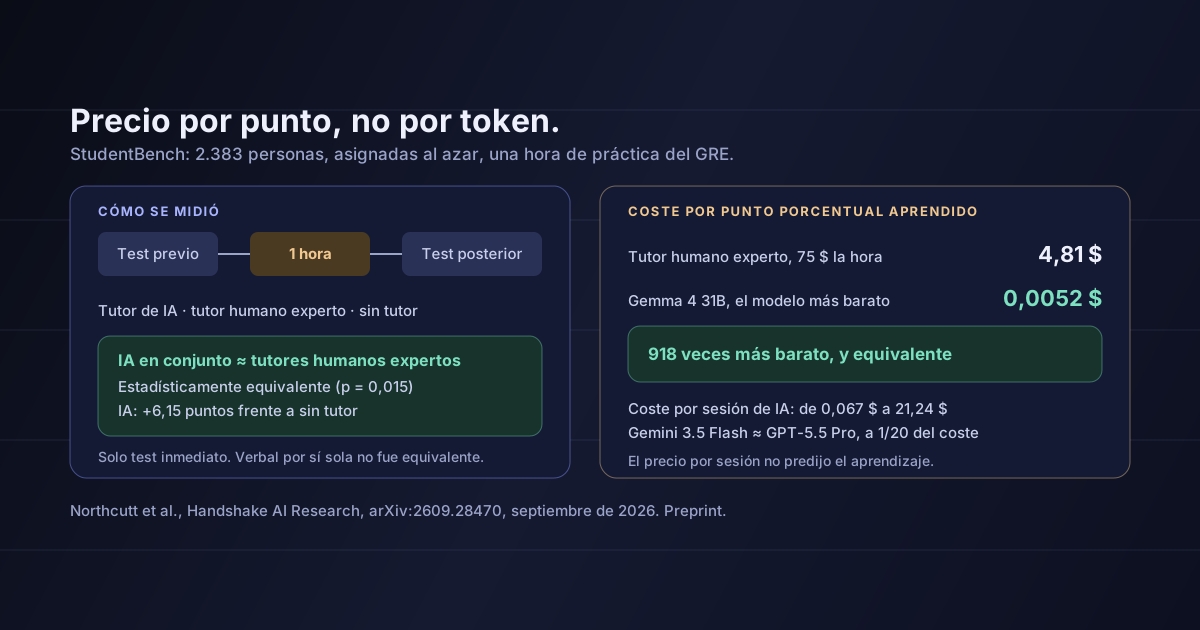
El estudio reclutó a 2.383 adultos, la mayoría de entre 18 y 24 años, para preparar el GRE, un examen de admisión a posgrados. Cada sesión tenía la misma estructura:
La mejora de aprendizaje era la puntuación del test posterior menos la del previo, en puntos porcentuales. Los tutores humanos eran antiguos redactores de preguntas del GRE o tutores con al menos cinco años de experiencia, y no podían ver las preguntas del test posterior.
La tutoría con IA, en conjunto, fue estadísticamente equivalente a la tutoría con expertos humanos en las mejoras en el GRE (p = 0,015, dentro de un margen de un cuarto de desviación típica). La diferencia media entre IA y humanos fue de −0,58 puntos porcentuales. Ambas mejoraron respecto a no tener tutor: la tutoría con IA añadió 6,15 puntos sobre el grupo de control.
Seis de los tutores de IA superaron individualmente la prueba de equivalencia frente a los tutores humanos. En cinco de las siete áreas temáticas del GRE, el mejor tutor de IA superó de media a los tutores humanos.
Después, el coste.
El precio de un modelo no decía casi nada de cuánto aprendería un estudiante con él. Solo medir el aprendizaje lo decía.
Esta es la lección que va más allá de las tutorías. Los autores no compararon los modelos en un benchmark ni por precio por token. Los compararon por coste por unidad del resultado que el producto existe para producir: aquí, dólares por punto porcentual de aprendizaje.
Visto así, el orden de los modelos cambia. Un modelo que cuesta 300 veces más por sesión solo compensa si produce 300 veces más de lo que vendes, y en este estudio el extremo caro no lo hizo.
La mayoría de los productos de IA se fijan y construyen al revés. El equipo elige un modelo capaz y caro porque da sensación de seguridad, mide el coste por llamada y nunca mide lo que cada llamada consigue para el usuario. Sin el resultado, no hay forma de saber si un modelo veinte veces más barato haría el trabajo igual de bien.
Hay un resultado secundario que es fácil pasar por alto. En las sesiones de la parte cuantitativa, las respuestas más rápidas de la IA se asociaron con más mensajes de los estudiantes; más mensajes, con más problemas de práctica resueltos correctamente; y más práctica correcta, con mayores mejoras de aprendizaje (todo con p < 0,002).
Es una correlación, no un experimento controlado, y los autores lo presentan así. Pero apunta a algo que los fundadores suelen subestimar: en un producto interactivo, la latencia no es un detalle técnico. Si un modelo más lento y más listo implica menos turnos de práctica, el usuario puede acabar aprendiendo —u obteniendo— menos, no más.
Lo más valioso de StudentBench para un fundador es cómo midió, y casi todo el diseño es barato de reproducir.
Mide antes y después. Define el resultado que cambia tu producto y mídelo al principio y al final de una sesión. Las puntuaciones de satisfacción y el tiempo en la aplicación no son resultados.
Mantén un grupo de control sin IA. Sin él, no puedes saber qué parte de la mejora se debe a tu producto y cuál habría ocurrido igualmente. Aquí, no tener tutor también produjo algo de mejora.
Compara modelos con los mismos usuarios. Asigna al azar a los usuarios a dos o tres modelos y compara resultados, no solo costes. Un modelo más barato que resulta equivalente es una decisión de margen bruto esperando a que alguien la tome.
Divide el coste por el resultado. Informa del coste por unidad de resultado —por incidencia resuelta, por respuesta correcta, por punto aprendido— y toma las decisiones de modelo con esa cifra.
Para los equipos que compran o imparten formación en IA, el resultado es alentador en un sentido acotado. Para la práctica tipo ejercicio con respuestas claramente correctas, un tutor de IA puede igualar a un experto humano en una sesión, por una fracción mínima del coste. Eso hace sensato usar tutores de IA para practicar entre sesiones en directo.
No demuestra que la IA sustituya a un profesor humano. El estudio midió una hora y un test inmediato. Si las mejoras perduran, y si la tutoría con IA funciona igual de bien para habilidades abiertas, son preguntas que no se planteó.
Es un preprint de la empresa que gestiona la plataforma. Handshake AI Research hizo el estudio en el propio servicio StudentBench de Handshake. Los datos se han publicado en abierto, lo que ayuda, pero no ha pasado revisión por pares.
El grupo con tutores humanos era pequeño. Unas 140 sesiones con tutor humano frente a más de 2.100 con IA. La equivalencia se estableció para la IA en conjunto; las comparaciones individuales tienen menos respaldo.
La parte verbal no estableció equivalencia por sí sola. El resultado conjunto combina las secciones cuantitativa y verbal. En la verbal por separado no se demostró equivalencia, y los tutores humanos obtuvieron la mayor mejora media en las tres áreas verbales.
Las mejoras son inmediatas. No se hizo ningún test diferido. Un aprendizaje que se ve una hora después puede no verse un mes después, en ninguno de los dos grupos.
El coste humano es una tarifa de referencia. La cifra de 4,81 dólares usa una tarifa publicada de 75 dólares la hora procedente de una fuente de 2018. Los precios reales de las tutorías varían mucho, lo que cambia el múltiplo, pero no la dirección.
No he verificado el resultado individual de cada modelo. El artículo da algunas cifras solo en gráficos. He usado únicamente los resultados que figuran en el texto.
StudentBench es una de las comparaciones más cuidadosas hasta ahora entre la enseñanza con IA y la humana: aleatorizada, controlada, con tutores humanos expertos y datos abiertos. En una hora de práctica para el GRE, la tutoría con IA fue tan eficaz como un experto humano, y el modelo más barato de los probados estuvo entre los que los igualaron.
Para los fundadores, la lección más duradera está en el método. Los autores eligieron los modelos por coste por unidad del resultado que les importaba, y midieron ese resultado frente a un control. Eso situó un modelo de 0,067 dólares a la altura de expertos humanos, y mostró que la opción más cara no era la que había que elegir.
Antes de elegir un modelo por precio o reputación, mide lo que cada uno produce de verdad para tus usuarios y divide el coste por eso.
Fuente: Curtis Northcutt, Inaara Hasmani, Kevin Feng, Trevor Khangi, Andreas Plesner y Jonas Mueller, «StudentBench: AI and human tutoring yield equivalent GRE learning gains», arXiv:2609.28470, v1 del 23 de septiembre de 2026 y v2 del 30 de septiembre de 2026: los 2.383 participantes, el diseño de test previo, una hora de condición y test posterior paralelo, las 13 configuraciones de tutor de IA por sección y los tutores humanos expertos, el resultado de equivalencia conjunto (p = 0,015), la diferencia de −0,58 puntos, la mejora de 6,15 puntos sobre el control, las seis equivalencias individuales, el resultado de cinco de siete áreas, los costes por sesión de 0,067 y 21,24 dólares, la equivalencia de Gemma 4 31B (p = 0,044) y sus 0,0052 dólares frente a 4,81 por punto porcentual a 75 dólares la hora, la comparación entre Gemini 3.5 Flash y GPT-5.5 Pro, las correlaciones de latencia y participación, el tamaño de los grupos, el resultado solo verbal y las limitaciones declaradas, todo tal como se publica ahí. Datos anonimizados y código: StudentBench en GitHub. La lectura de las secciones 3 a 6 es mía. Sobre por qué los modelos pequeños suelen ganar en tareas acotadas, ver la mayor parte de lo que tu agente le pide a un LLM es un sí o un no. Sobre el problema del tiempo en la formación corporativa en IA, ver la formación en IA se ha más que duplicado; el 56% no tiene tiempo para hacerla.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.