
Casi todo lo que tu agente le pide a un LLM es un sí o un no

By Surya Pratap
21 de septiembre de 2026
11 min read
AI & Technology

21 de septiembre de 2026
11 min read
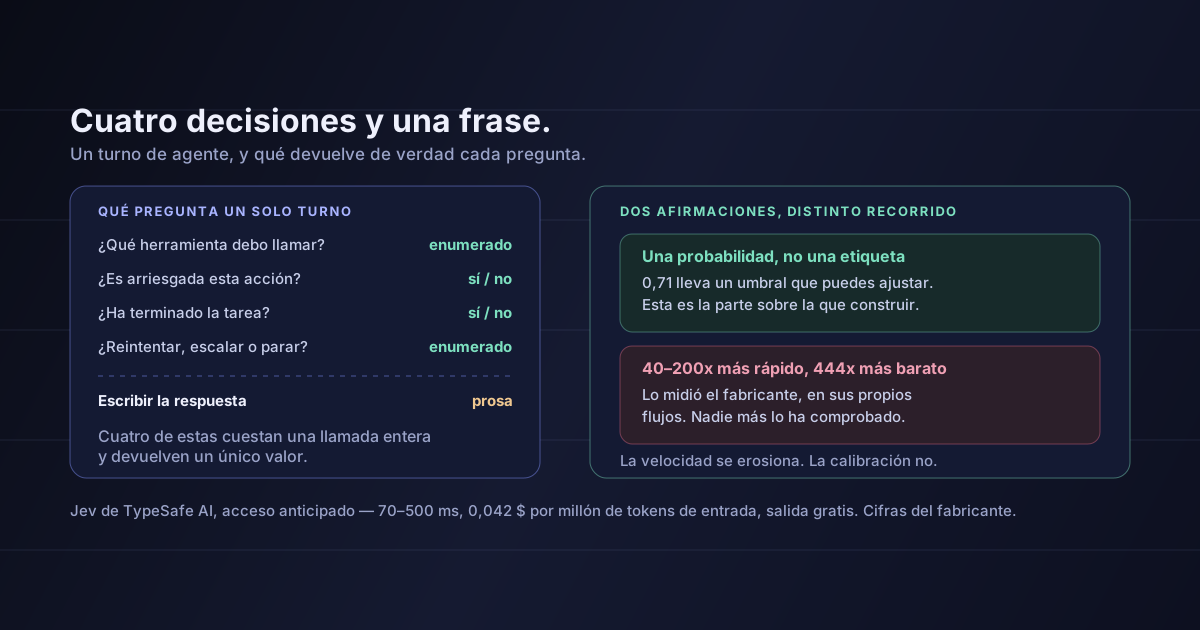 Cuatro decisiones y una fraseHover to explore
De vez en cuando merece la pena leer un lanzamiento por su premisa y no por sus números. Este tiene una premisa que me parece acertada y unos números que nadie fuera de la empresa ha comprobado, una combinación poco habitual que conviene separar con cuidado.
Este artículo parte de «Building a harness with Jev» de LangChain, de Sydney Runkle y Hunter Lovell, publicado el 17 de septiembre de 2026; del anuncio de la propia TypeSafe AI; de una guía práctica de la API; y de la lectura escéptica de MindStudio. Todas las cifras de rendimiento que siguen son de TypeSafe. El apartado 7 explica qué significa eso. El argumento del apartado 2 en adelante es mío.
TypeSafe AI publicó Jev, al que llama un modelo System One: una clase que define como modelos hechos para tomar decisiones rápidas y estructuradas que el software consume directamente, en lugar de para generar texto. LangChain publicó un harness construido sobre él la misma semana.
La forma del asunto: le entregas un estado y un conjunto de preguntas tipadas, y responde a todas de una pasada con probabilidades adjuntas. Tres tipos de pregunta:
Choice — elige una de hasta 255 opciones, con una probabilidad por opciónScore — sitúa la entrada en una escala ordenada de 2 a 10 nivelesNoul — un sí o un no, devuelto como un único número entre 0 y 1from typesafe_sdk import Choice, Noul, TypeSafeClient
client = TypeSafeClient()
response = client.system_one(
state={"ticket": "I was charged twice"},
questions={
"department": Choice(
instructions="Which team handles this",
criteria={"billing": "Payment issues", "technical": "Bugs"},
),
"urgent": Noul(instructions="Message conveys urgency"),
},
)
Dos diferencias de arquitectura hacen el trabajo. El modelo muestrea todas las salidas en una sola consulta y en paralelo en lugar de autorregresivamente, de donde sale la afirmación sobre latencia. Y se entrena con lo que TypeSafe llama RLCD, aprendizaje por refuerzo para decisiones calibradas, que no optimiza para una respuesta que apruebe un evaluador humano, sino para una respuesta acompañada de una probabilidad que refleje con qué frecuencia esa respuesta es correcta.
Las cifras publicadas: 70–500 ms de extremo a extremo, 0,042 dólares por millón de tokens de entrada con la salida gratis y, en las evaluaciones de flujo de la propia empresa, 193,6× más rápido y 444,6× más barato que los modelos de frontera con los que se comparó. El contexto está limitado a 64k tokens en total, 32k para el estado.
Quita el fabricante y mira en qué consiste de verdad un turno de agente.
¿Qué herramienta debo llamar? Un enumerado. Una de once opciones.
¿Es esta acción lo bastante arriesgada como para parar? Un sí o un no.
¿Ha terminado la tarea? Un sí o un no, preguntado en cada vuelta del bucle.
¿Reintentar, escalar o rendirse? Otro enumerado.
Y después, una vez, al final: escribe la respuesta. Eso sí necesita un modelo de lenguaje, y nada de esto lo sustituye.
La parte cara de un turno de agente rara vez es la escritura. Son las cuarenta pequeñas decisiones que cuestan cada una una llamada completa al modelo.
Cada una de esas decisiones pasa hoy por un modelo hecho para producir frases, tarificado por token, generando de forma autorregresiva, y luego se reduce de nuevo a una sola palabra al parsearla. Estás pagando precio y latencia de generación por un trabajo cuya salida entera cabe en un byte.
Esa afirmación no cuesta nada evaluarla y no depende de que ninguno de los números de TypeSafe sea correcto. Es el mismo movimiento que separar OLTP de analítica, o una caché de una base de datos: dos patrones de acceso vistiendo un solo componente porque nadie había reparado aún en que eran dos cosas.
Las ventajas de velocidad y coste se erosionan compitiendo. En dos trimestres habrá cuatro de estos y el precio será el del segundo más barato. La calibración es la parte contra la que yo sí construiría.
La diferencia en la práctica es esta. A un LLM al que preguntas «¿esto es urgente?» te devuelve urgente. Un clasificador calibrado te devuelve 0,71.
Una etiqueta te da una rama. Una probabilidad te da un umbral, y un umbral es un dial:
Bloquear por encima de 0,9, marcar para revisión a partir de 0,6, registrar por debajo. Una pregunta, tres comportamientos, sin llamadas extra al modelo. Con una etiqueta seca tienes un comportamiento y ninguna forma de intercambiar precisión por cobertura.
Este es el control que defendí en el artículo sobre las cifras de supervisión de Anthropic: decide cuántos elementos revisará una persona cada semana y mueve el umbral hasta que sea eso lo que llega. Esa aritmética no se puede hacer con etiquetas.
La confianza baja es justamente el caso que debería escalar a un modelo más lento y más capaz. Casi todo el enrutado de hoy adivina la complejidad a partir de la entrada; una puntuación calibrada mide la incertidumbre sobre la salida, que es lo que en realidad querías saber.
La palabra importante es calibrada. Cualquier modelo emite un número si se lo pides, y la probabilidad softmax de un token no es una afirmación sobre la corrección. Si la calibración de Jev se sostiene es exactamente el tipo de cosa que necesita medición de terceros, y no ha tenido ninguna.
TypeSafe afirma que Jev tiene una tasa garantizada del 0% de errores de salida estructurada, planteada como una propiedad matemática de la arquitectura y no como un resultado de benchmark. Tomado literalmente, y no tengo motivos para dudarlo, eso significa que el modelo no puede devolver algo fuera del esquema que declaraste.
La forma no es la corrección
Una garantía sobre el tipo es una garantía de que la respuesta está bien formada, no de que sea correcta. Si preguntas cuál de once herramientas llamar, siempre obtendrás una de las once — y puede ser la equivocada de las once, todas las veces, sin ningún error de parseo que te avise. Merece la pena tenerlo claro, porque «nunca alucina» ya circula como descripción de este modelo y significa algo mucho más estrecho de lo que suena: nunca alucina una forma. Nada en la arquitectura impide una clasificación equivocada con toda la confianza del mundo.
Dicho eso, eliminar la salida malformada es una ganancia operativa real, y quien haya lanzado un agente sabe por qué: la vía de reintento por fallo de parseo es donde vive una cantidad sorprendente de latencia, de coste y de comportamiento extraño. Eliminar una clase entera de fallo vale algo aunque no sea la clase que más te preocupa.
Antes de evaluar ningún producto de estos, averigua si la premisa describe tu sistema. Es una hora de trabajo y la respuesta es duradera sea cual sea el fabricante que acabes usando.
Instrumenta cada llamada al modelo que hace tu agente y clasifícala:
| Categoría | Prueba | Qué te dice |
|---|---|---|
| Decisión | La salida se reduce a un enumerado, un booleano o un número | Candidata a clasificador |
| Extracción | La salida es un esquema fijo y pequeño sacado de una entrada mayor | Candidata, si el esquema es estable |
| Generación | La salida es prosa que leerá una persona u otro sistema | Se queda en un modelo de lenguaje |
| Razonamiento | La salida es un plan de varios pasos cuyos pasos intermedios importan | Se queda, y probablemente en tu mejor modelo |
Después calcula dos números: la proporción de llamadas en las dos primeras categorías y la proporción de gasto. En casi todos los stacks de agentes que he visto, el primer número es alto y el segundo es menor pero ni de lejos proporcionado: las decisiones suelen ser prompts cortos, así que son baratas por separado y lo bastante numerosas como para pesar en agregado, y dominan la latencia porque están en el camino crítico de cada vuelta.
El umbral que yo usaría:
Si decisiones y extracción no llegan a un tercio de tus llamadas, esto es una optimización y deberías ignorarla hasta arreglar otra cosa. Si pasan de dos tercios — que es el caso habitual en cualquier cosa con bucle de herramientas — entonces tu arquitectura ya contiene dos cargas de trabajo y estás a una decisión de proveedor de poder separarlas.
Jev está en acceso anticipado, así que la pregunta práctica es qué puedes hacer ahora. Tres opciones, en orden creciente de esfuerzo.
Agrupa las preguntas que ya haces. La ganancia más barata de todas no tiene nada que ver con modelos nuevos. Si tu bucle hace cuatro llamadas separadas para decidir cuatro cosas sobre el mismo estado, pregunta las cuatro en una sola llamada con un esquema estructurado. Pagas el estado una vez en lugar de cuatro.
Pasa ya las decisiones fáciles a un modelo pequeño. «¿Ha terminado la tarea?» no necesita tu mejor modelo. Un modelo pequeño con decodificación restringida resuelve la mayoría de las preguntas de puerta, y puedes medir la tasa de desacuerdo contra tu modelo actual antes de cambiar nada.
Construye el umbral antes de tener la probabilidad. Escribe la puerta de dos niveles — bloquear por encima, revisar en medio, registrar por debajo — aunque el nivel intermedio quede simulado. Cuando llegue una puntuación calibrada, estarás enchufando un número en lugar de rediseñar un flujo de control.
Mantén el conjunto de evaluación independiente del modelo. Si algún día quieres mover una decisión a un clasificador, lo que convierte eso en dos horas en vez de dos semanas es tener un conjunto etiquetado con las entradas de esa decisión y sus respuestas correctas. Casi todos los equipos lo tienen para su tarea de extremo a extremo y para nada de las decisiones individuales que hay dentro.
Esa última es el requisito real. No puedes mover con seguridad una decisión a un modelo más barato sin una forma de saber si ha empeorado, y construir ese conjunto es trabajo que te debes a ti mismo entre en escena o no un modelo System One.
Todas las cifras de rendimiento son autodeclaradas. Ninguna parte independiente ha medido Jev. El modelo está detrás de una lista de espera, las evaluaciones no son sobre benchmarks públicos y los números de comparación vienen de la empresa que vende el producto. Eso no los hace falsos; los hace no verificados, y deberían llevar exactamente el descuento que aplicarías a las cifras propias de cualquier fabricante.
TypeSafe publica sus propios límites metodológicos, y son reales. Las evaluaciones de flujo las construyó su equipo de capacidades de modelo, lo que la empresa reconoce que podría sesgarlas. La línea base de comparación es la media de dos modelos de frontera. Las demostraciones usaron consultas simplificadas con claves legibles por humanos. Mérito por publicar todo eso; no deja de importar.
«193,6× más rápido, 444,6× más barato» es un techo, no una expectativa. TypeSafe lo dice: espera que estén en el extremo alto de las ganancias reales. Citar la cifra de titular como lo que vas a obtener sería malinterpretar la salvedad de la propia empresa.
No lo he usado. Todo lo anterior está leído de material publicado. Recomiendo la pregunta arquitectónica, no el producto.
Las afirmaciones sobre calibración son las que más querría ver comprobadas. Es la parte con verdadero valor de ingeniería y la más difícil de verificar desde fuera, y una curva de calibración que se sostiene en los flujos del fabricante puede no sostenerse en los tuyos. Si haces un piloto, mide la calibración sobre tus propios datos antes de enchufar un umbral a algo que importe.
El lanzamiento se discutirá por sus números, y esa discusión todavía no la puede zanjar nadie de fuera de la empresa.
La parte que no depende de los números es la descomposición. Un bucle de agente es sobre todo un motor de decisiones con un redactor atornillado al final, y el sector lleva dos años sirviendo las dos mitades desde el mismo componente porque ese componente era el único disponible. Alguien iba a darse cuenta. Que ahora haya un fabricante, un método de entrenamiento y una integración de LangChain colgando de esa observación es menos interesante que la observación.
Instrumenta tu agente y averigua qué fracción de sus llamadas al modelo devuelve algo que reduces de inmediato a un único valor. Si ese número es dos tercios, ya tienes dos cargas de trabajo — y siempre ibas a tener que separarlas, venda quien venda la segunda.
Fuentes: LangChain, «Building a harness with Jev», de Sydney Runkle y Hunter Lovell, 17 de septiembre de 2026 — el planteamiento del harness, los tipos de pregunta y los casos de enrutado y barrera de seguridad. TypeSafe AI, «Introducing System One Models & Jev» — la definición de System One, el muestreador paralelo, RLCD, el rango de latencia de 70–500 ms, los 0,042 dólares por millón de tokens de entrada con salida gratis, las cifras de flujo de 193,6× y 444,6×, la afirmación de cero errores de tipo y las salvedades metodológicas citadas en el apartado 7, todas ellas de TypeSafe. Una guía práctica de Jev — la superficie del SDK, el techo de 255 opciones en Choice y los límites de contexto de 64k totales y 32k de estado. MindStudio, «RLCD vs RLHF» — la ausencia de verificación independiente. El argumento de la descomposición, la defensa de la calibración frente a la velocidad, la distinción entre forma y corrección y todas las recomendaciones son míos. Para la mecánica de costes sobre la que se apoya todo esto, véase cada archivo que lee tu agente se queda en la factura, y para el argumento del umbral véase las cifras de supervisión de agentes de Anthropic.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.