Las condiciones de Meta para empresas dejan entrar a sus rastreadores en tu web desde el 30 de octubre. Quitó «train», no el rastreo

By Surya Pratap
19 de octubre de 2026
8 min read
Startup Strategy

19 de octubre de 2026
8 min read
 Sale una palabra, el rastreador se quedaHover to explore
La mayoría de los fundadores han aceptado las condiciones de Meta para empresas sin leerlas. Necesitabas una página de Facebook, un perfil de empresa en Instagram o una cuenta publicitaria, y las condiciones venían con ello. Merece la pena leer la versión que entra en vigor el 30 de octubre, porque uno de sus párrafos trata de tu web, no de tus cuentas de Meta.
Este artículo se basa en el texto del párrafo sobre rastreo citado por PPC Land, en la información de Nieman Lab (primer artículo, seguimiento) y en la cobertura de MediaNama. No he visto el texto revisado completo; la descripción del cambio procede de esa información. La lectura a partir de la sección 3 es mía y no constituye asesoramiento jurídico.
Las Condiciones Comerciales de Meta se aplican a las empresas que usan sus productos con fines comerciales: páginas de Facebook, cuentas de empresa de Instagram, Meta Business Suite, publicidad. La versión prevista para el 30 de octubre contenía este párrafo, que reproducimos en su redacción original en inglés:
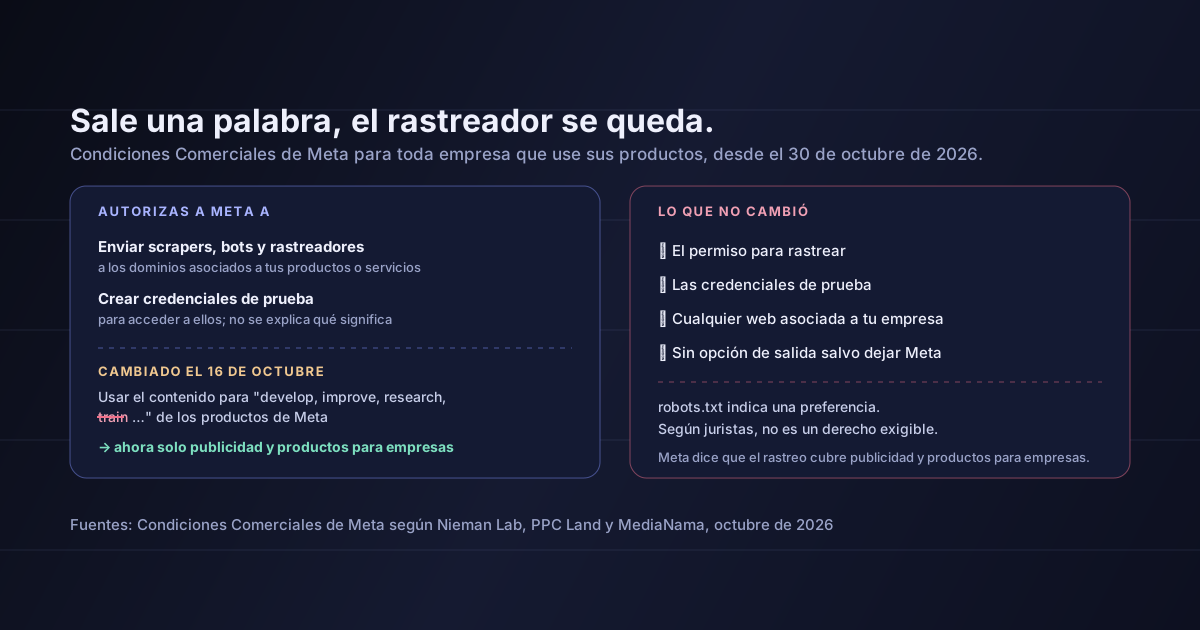
"You authorise us (or any entity acting on our behalf) to use automated software (such as web scrapers, bots, robots, spiders, crawlers and user agents) and create test credentials to access, index, cache, analyse, collect, retrieve or crawl the domains, web pages or URLs (and any content available through them) that are associated with your products or services, or that are made available through your or users' use of Meta Company Products and services, and to periodically pull updates from such domains, web pages or URLs. Meta may use any content from such domains, web pages or URLs to provide, develop, improve, research, train and maintain the integrity of, the Meta Company Products, services and features provided under these Commercial Terms and any other applicable supplemental terms."
En el texto, los user agents son agentes de software que visitan una web de forma automática.
Tres partes importan:
El 15 de octubre, Nieman Lab publicó la opinión de tres juristas según la cual el párrafo, tal como estaba redactado, podía servir para defender que Meta puede rastrear webs de noticias y usar el contenido para entrenar su IA. Casi todos los medios de comunicación tienen una cuenta de empresa en Meta. El portavoz de Meta Andy Stone calificó de «falsas» las informaciones según las cuales las condiciones permitirían rastrear webs de noticias.
El 16 de octubre, Meta revisó las condiciones. Según la información publicada:
Un portavoz de Meta dijo: «Os hemos escuchado y queremos aclararlo: las condiciones de rastreo que hemos unificado solo se aplicaban a nuestros productos de publicidad y para empresas», y añadió que «los propietarios de contenido pueden usar robots.txt para indicar sus preferencias».
La revisión cambió lo que Meta dice que hará con el contenido. Según la información publicada, no cambió el permiso para recogerlo:
Los juristas no se quedaron tranquilos. James Grimmelmann, de Cornell, dijo a Nieman Lab que el texto revisado seguía siendo lo bastante amplio como para cubrir el entrenamiento de IA. Benjamin Sobel, de la Universidad de Wisconsin, señaló que robots.txt expresa una preferencia pero no crea un derecho exigible a impedir el rastreo. Asociaciones de editores de Europa, Reino Unido y EE. UU. han pedido la intervención de los reguladores.
Meta quitó la palabra que describía lo que puede hacer con tu contenido. Mantuvo el párrafo que le permite recogerlo.
No es solo un problema de los medios. Si tienes una página de Facebook, una cuenta de empresa de Instagram o anuncios en Meta, eres parte de estas condiciones, y tu web está «asociada a tus productos o servicios».
Haz un mapa de lo que es accesible. Enumera los dominios vinculados a tus cuentas y anuncios de Meta: web de marketing, documentación, blog, centro de ayuda, app. Decide cuáles te parece bien que un tercero rastree, almacene en caché y analice bajo unas condiciones que no negociaste.
Separa el marketing del producto. Mantén tu producto en su propio subdominio y tras su propia autenticación. Una cuenta de prueba creada por el rastreador de otro no debería poder ver datos de clientes, precios que negocias en privado ni nada detrás de un inicio de sesión que no enseñarías a un desconocido.
Indica tu preferencia de todos modos. Robots.txt no es exigible, pero es la señal a la que remite la propia Meta. Configura reglas para los rastreadores publicados por Meta, y para los rastreadores de IA en general, en los dominios que importan. Después revisa los registros del servidor para ver qué llega de verdad.
Vigila los registros desconocidos. «Credenciales de prueba» significa cuentas. Busca altas e inicios de sesión que no se comportan como clientes, y decide de antemano qué harás si resultan ser automatizados.
Lee las condiciones que aceptaste sin leer
Ponte un recordatorio para leer las condiciones para empresas de cada plataforma de la que dependes —Meta, Google, LinkedIn, tu proveedor de pagos, tu nube— cada vez que cambien. Las cláusulas que importan a una startup en la era de la IA tratan del rastreo, el uso del contenido y el entrenamiento, y cada vez están más en condiciones que aceptaste para poner anuncios, no en un contrato que negociaste.
Si tu contenido es tu producto —una base de conocimiento, un conjunto de datos, investigación propia, artículos de pago—, esto importa más. Nuestro manual de GEO trata de aparecer citado por los sistemas de IA; esta es la otra cara de la misma pregunta: que te recojan sin pedírtelo.
Algunos fundadores leen esta historia desde el otro lado. Si tu producto depende de rastrear webs ajenas, fíjate en lo que ha pasado: una empresa con el peso de Meta incluyó el consentimiento para rastrear y entrenar en unas condiciones que sus clientes no podían negociar, y las críticas la obligaron a cambiarlas en un día.
La lección no es la posición jurídica de Meta, que los abogados discuten. Es que el consentimiento escondido en las condiciones de una plataforma es frágil, pública y comercialmente. Los datos de entrenamiento con licencia, o aquellos para los que los propietarios han dado su consentimiento claro, cuestan más de conseguir y es mucho más difícil que te los quiten. Y si un regulador pregunta, como la FTC acaba de preguntar a OpenAI y Anthropic, si lo que afirmas coincide con lo que haces, «las condiciones lo permitían» es una respuesta débil.
Que Meta esté entrenando IA con tu web. Meta dice que el rastreo solo se aplica a publicidad y productos para empresas, y calificó de falsas las informaciones sobre el rastreo de webs de noticias. Las condiciones establecen lo que Meta puede hacer, no lo que hace.
Que las condiciones revisadas permitan entrenar IA. Algunos juristas creen que el texto sigue siendo lo bastante amplio; Meta no está de acuerdo. Ningún tribunal se ha pronunciado.
Que conozca el texto definitivo. El texto revisado se describe aquí a partir de la información publicada; comprueba las condiciones que publique Meta antes del 30 de octubre.
Que robots.txt te proteja. Indica una preferencia. Como señaló Sobel, no crea un derecho exigible.
Desde el 30 de octubre, toda empresa que usa productos de Meta autoriza a Meta a enviar scrapers y rastreadores, y a crear credenciales de prueba, a las webs asociadas a sus productos. Meta se reservaba al principio el derecho a usar ese contenido para entrenar sus productos; tras la información de Nieman Lab eliminó «train» y limitó el uso a publicidad y productos para empresas. El rastreo, las credenciales de prueba, el amplio alcance y la ausencia de una opción de salida se mantienen, y los juristas dicen que el texto revisado sigue siendo amplio.
Para las startups, la conclusión práctica es sencilla. Lo expuesta que está tu web depende ahora, en parte, de unas condiciones que aceptaste para tener una página de Facebook.
Antes del 30 de octubre, enumera todos los dominios vinculados a tus cuentas de Meta, pon todo lo sensible tras su propia autenticación, configura en robots.txt tus preferencias para los rastreadores de Meta y otros de IA, y empieza a vigilar los registros del servidor y las altas en busca de visitantes automatizados.
Fuentes: PPC Land: el texto completo del párrafo sobre rastreo tal como se publicó originalmente para el 30 de octubre de 2026, a quién vincula y la negativa de Meta a explicar qué son las credenciales de prueba. Nieman Lab, 15 de octubre de 2026: la interpretación de los tres juristas. Nieman Lab: la revisión y la opinión de los expertos de que sigue siendo amplia. MediaNama: la eliminación de «train», la limitación a publicidad y productos para empresas, la declaración del portavoz de Meta sobre robots.txt, los comentarios de James Grimmelmann y Benjamin Sobel, la ausencia de opción de salida y las peticiones de las asociaciones de editores. La fecha de la revisión del 16 de octubre, el comentario de Andy Stone sobre informaciones «falsas» y el uso casi universal de cuentas de empresa de Meta por parte de los medios proceden de la cobertura de los artículos de Nieman Lab. La lectura de las secciones 3 a 6 es mía y no constituye asesoramiento jurídico.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.