
Dos harnesses de agentes en 48 horas, y apuestan en direcciones opuestas (2026)

By Surya Pratap
7 de agosto de 2026
11 min read
AI & Technology

7 de agosto de 2026
11 min read
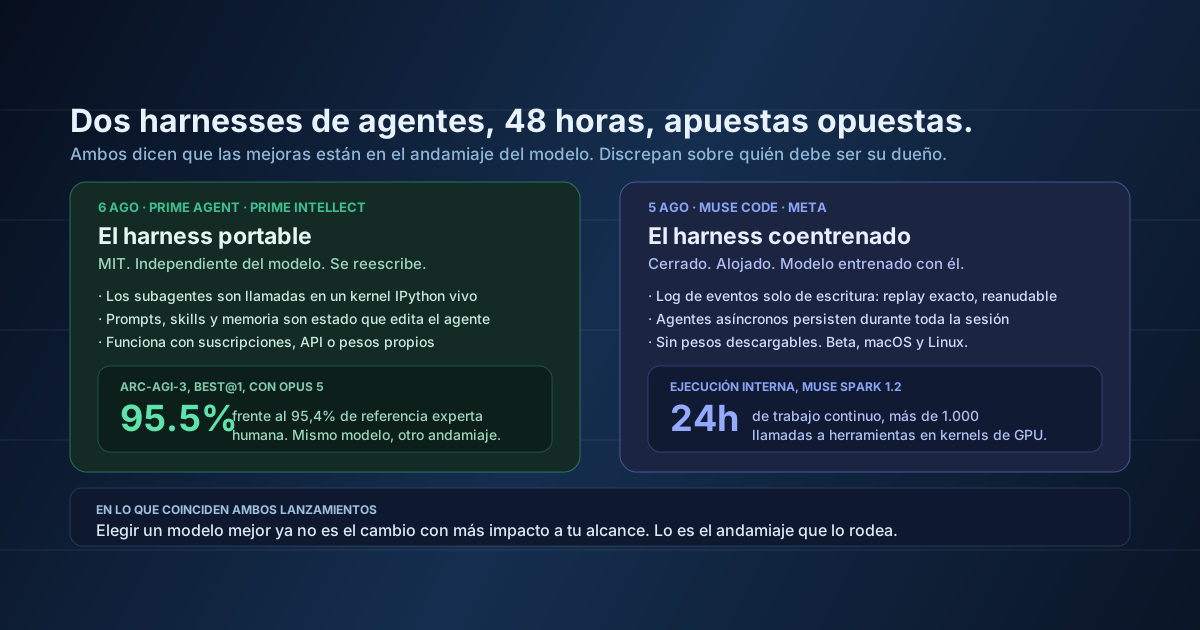
El 5 de agosto, Meta lanzó Muse Code, un agente de programación para terminal que funciona con Muse Spark 1.2, un modelo que entrenó junto al propio agente. El 6 de agosto, Prime Intellect publicó en abierto Prime Agent con licencia MIT, un harness diseñado para ejecutar cualquier modelo al que lo apuntes, que obtuvo un 95,5 % en ARC-AGI-3 con Opus 5 detrás.
Ninguno de los dos lanzamientos trata, en el fondo, de un modelo. Ambos tratan del andamiaje que lo envuelve: cómo se gestiona el contexto, cómo se lanzan los subagentes, qué sobrevive a una caída, qué puede cambiar el agente de sí mismo a mitad de tarea. Es un cambio que merece un nombre. Durante dos años, los lanzamientos interesantes eran checkpoints, y la pregunta del fundador era a qué modelo enrutar. Estos dos dicen que el modelo ya no es donde quedan las mejoras.
Lo que hace verdaderamente útil a la pareja es que coinciden en la premisa y discrepan por completo en la conclusión. Uno dice que el harness es portable y que debe ser tuyo. El otro dice que el harness solo funciona cuando el modelo se ha entrenado dentro de él, así que debe ser del laboratorio. Vas a tener que elegir bando, así que merece la pena entender el argumento.
Prime Agent se basa en dos ideas, y ambas son lo bastante inusuales como para exponerlas con claridad.
La primera es el Recursive Language Model. En lugar de que el contexto sea una ventana que se llena y se trunca, el contexto es una variable dentro de un kernel de IPython persistente. El modelo escribe código que opera sobre su propio historial —buscándolo, troceándolo, resumiendo partes— en lugar de recibir un prompt ya montado. Delegar en un subagente no es una capa especial de orquestación; es una llamada a función en ese mismo REPL. Si alguna vez has escrito un nodo supervisor en LangGraph, es el mismo problema resuelto un nivel más abajo: el agente programa su propia delegación en lugar de que la cablees tú.
La segunda es el Continual Harness. Los prompts, las skills, la memoria y las definiciones de subagentes se tratan como estado que el agente puede crear, leer, actualizar y borrar desde dentro de su propia ejecución. El comando /refine analiza la trayectoria hasta el momento y propone cambios concretos a ese estado: planificados en segundo plano para no bloquear, aplicados entre turnos, respaldados por evidencias y reversibles mediante un historial de rollback. El agente, en un sentido limitado y auditado, reescribe su propio andamiaje mientras trabaja.
La cifra principal: 95,5 % de RHAE Best@1 en ARC-AGI-3 con Opus 5, frente a la referencia de experto humano de ARC, que es del 95,4 %. Las ejecuciones dieron 95,0, 95,2 y 95,5, así que el resultado es estable y no una muestra afortunada. Best@3 llega al 99,97 %, con los 183 niveles de 183 completados. Prime Intellect también afirma una mejor eficiencia de tokens que la de los harnesses nativos de los modelos, lo que importa más que la puntuación.
Sin embargo, la afirmación que debería llamarte la atención no es la cifra de ARC. Es la comparación que hay debajo: Prime Agent ejecutando GLM-5.2 fue competitivo con Claude Code ejecutando Opus 5 y con Codex ejecutando GPT-5.6 Sol, o mejor que ellos, en un conjunto de benchmarks de contexto largo: OOLONG, OOLONG-Pairs, OBLIQ-Bench, LongBenchPro y ManyIH. Si eso se sostiene de forma independiente, significa que un modelo abierto de gama media en un harness mejor puede igualar a un modelo de frontera en el harness que construyó su propio laboratorio. Es una afirmación mucho mayor que un récord en un benchmark.
Las demos, para calibrar
Prime Agent produjo emuladores funcionales en Rust de la SEGA Genesis y la Game Boy Color sin código de referencia, y alcanzó una puntuación de producción de más de 100.000 en Factorio en cuestión de horas. Léelos como deberías leer cualquier demo de lanzamiento: como prueba de que el sistema puede sostener trabajo coherente muy largo, no como prueba sobre tu base de código. Los emuladores y los juegos de fábricas tienen algo que tu producto no tiene: una señal rápida, inequívoca y automática de si el último cambio era correcto.
El lanzamiento de Meta es menos novedoso en lo conceptual y bastante más serio en lo operativo. Muse Code es un agente de terminal en beta para macOS y Linux, que se instala con un solo comando y ejecuta Muse Spark 1.2 a través de Muse Code o de la Meta Model API. No hay pesos descargables.
Tres decisiones de diseño merecen copiarse, lo ejecutes o no.
El log de eventos de solo escritura. Cada llamada al modelo, ejecución de herramienta, aprobación y edición se añade a un log local, lo que hace que el runtime se pueda reproducir con exactitud y reiniciar con seguridad. Cuando el agente se cae a los cuarenta minutos de una tarea, retoma donde lo dejó en lugar de empezar de cero. Es la propiedad más infravalorada del lanzamiento. Cualquiera que haya ejecutado sesiones largas de agentes en producción sabe que el fallo que duele no es una respuesta incorrecta: es perder treinta minutos de estado acumulado por un timeout, sin forma de reconstruir qué creía el agente en el momento en que se equivocó.
Agentes persistentes en segundo plano. En lugar de lanzar un subagente nuevo por tarea, Muse Code mantiene vivo un conjunto de agentes asíncronos en segundo plano durante toda la sesión. La razón declarada es evitar recopilar información de forma redundante: el segundo subagente no vuelve a leer el repositorio que acaba de leer el primero. Si tu orquestación lanza un agente limpio por paso, pagas ese peaje de redescubrimiento en cada paso, y se acumula.
Planificación con aprobación como skill por defecto. Muse Code incluye /plan para convertir una tarea en un plan que apruebas antes de ejecutarlo, /grill para someter ese plan a presión hasta que aguante, y /goal para llevarlo hasta el final. Hacer una pasada adversarial sobre el plan antes de escribir una línea de código es una intervención barata que la mayoría de los equipos se salta.
Meta evaluó en Terminal-Bench 2.1 (89 tareas, pass@1 sobre cinco intentos), DeepSWE v1.1 (113 tareas en 91 repositorios y cinco lenguajes) y un benchmark interno de 440 tareas derivadas de pull requests reales, comparando con Grok 4.5, Claude Opus 5, GPT-5.6 Terra, Gemini 3.6 Flash y Kimi K3. No he podido verificar las cifras publicadas de Muse Spark 1.2 en una fuente primaria —están en imágenes de gráficos del post de Meta—, así que no voy a citarlas. Como referencia: Muse Spark 1.1 obtuvo 80,0 en Terminal-Bench 2.1, y Qwen3.8-Max declaró 86,6 en el mismo benchmark la semana pasada. La afirmación más fácil de evaluar es la ejecución interna en la que el modelo optimizó kernels de GPU a lo largo de más de 1.000 llamadas a herramientas y hasta 24 horas de trabajo continuo. Una duración a esa escala es una propiedad del harness, no del modelo.
Esta es la parte que hace que la pareja sea interesante y no solo ajetreada.
Prime Intellect es inusualmente sincero sobre su propia limitación. Su artículo señala fricciones al ejecutar Prime Agent con distintos modelos, y afirma sin rodeos que ningún modelo se ha entrenado en torno a Prime Agent ni a su conjunto de funciones principal. El 95,5 % sale de un modelo de frontera haciendo algo para lo que nunca se entrenó específicamente, dentro de un harness que nunca había visto. Tratan la fricción restante como la distancia entre donde están y donde podría llegar el enfoque.
Meta cerró exactamente esa distancia, en la dirección contraria. Muse Spark 1.2 se entrenó junto a la herramienta. El modelo y el harness se desarrollaron como un solo artefacto, y por eso Meta puede prometer sesiones de 24 horas y recuperación con replay exacto: el modelo se ha moldeado para comportarse bien dentro de ese runtime concreto.
Así que ambas partes coinciden en el punto técnico de fondo: modelo y harness están acoplados, y el rendimiento está en ese acoplamiento. Discrepan sobre quién se queda con el acoplamiento. La apuesta de Prime Intellect es que un harness abierto, portable y automodificable acumula mejoras más rápido que cualquier laboratorio por separado, y que los modelos acabarán entrenándose para harnesses como el suyo. La apuesta de Meta es que el coentrenamiento es un foso, y que el mejor agente siempre será aquel cuyo modelo se crió dentro de él.
Por qué esto te importa a ti en concreto
Si gana la apuesta portable, el andamiaje de tus agentes es un activo duradero y cambiar de modelo sigue siendo barato: en lo que hay que invertir es en tu harness. Si gana la apuesta coentrenada, tu andamiaje es un puente temporal hacia el laboratorio que vaya por delante en cada momento, y en lo que hay que invertir es en la capacidad de migrar. Llevan a decisiones de ingeniería distintas este trimestre, y por eso merece la pena tener una opinión en lugar de esperar a la respuesta.
Cuatro matices, porque esta semana la cifra se va a citar mucho sin ellos.
La mayoría de los equipos que lean esto no deberían cambiar de harness esta semana. Pero casi todos deberían copiar de ambos.
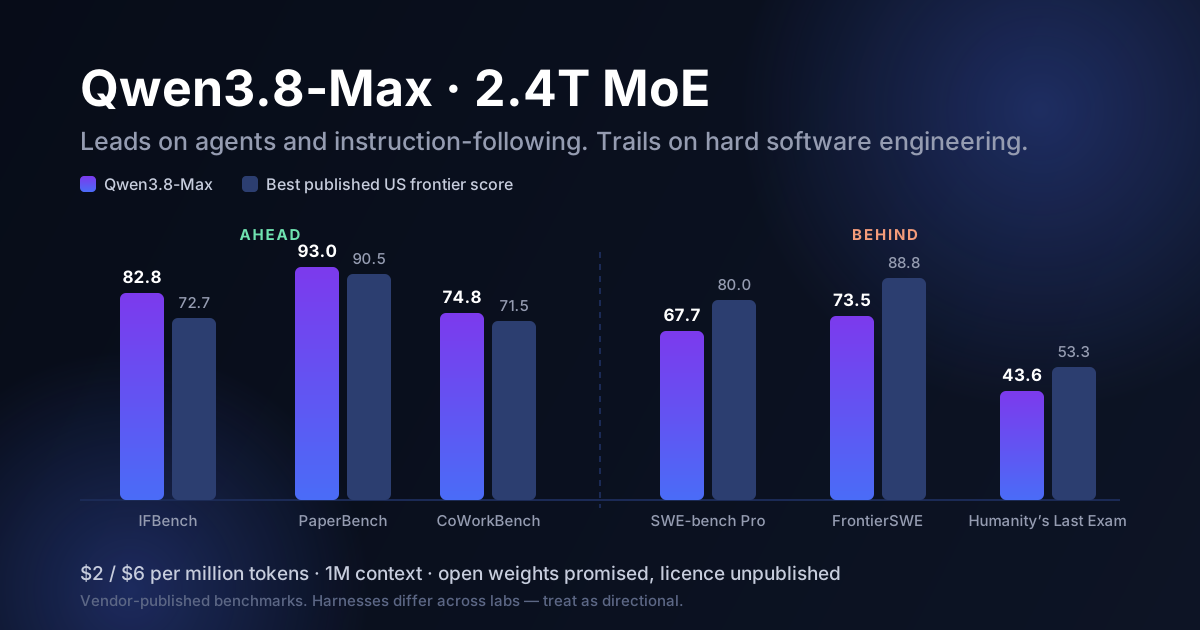
/grill —generar un plan y atacarlo antes de ejecutarlo— detecta el tipo de fallo en el que el agente da cuarenta pasos correctos hacia un objetivo equivocado. Revisar el diff al final no puede detectarlo.La semana pasada escribí que las carencias de Qwen3.8-Max en los benchmarks no estaban en la inteligencia bruta —un 92,6 en GPQA Diamond es nivel de frontera—, sino en el trabajo agéntico de largo horizonte, donde un modelo tiene que sostener un plan a lo largo de cuarenta pasos y recuperarse de sus propios errores. Esta semana, dos laboratorios han lanzado productos que atacan justo esa carencia, y ninguno lo ha hecho haciendo más listo al modelo.
Ese es el patrón que merece la pena retener. La distancia que queda entre una demo impresionante y un sistema que aguanta una carga de trabajo real se está cerrando con ingeniería: estado duradero, capacidad de reanudar, gestión del contexto, delegación que no pierde lo aprendido, un plan con el que alguien discutió antes de ejecutarlo. Nada de eso llega en un checkpoint. Todo es construible por un equipo competente, lo que significa que está a tu alcance, y que la ventaja no caduca cuando sale el siguiente modelo.
La implicación incómoda es que, si tu agente rinde por debajo de lo esperado, probablemente el modelo no es tu problema. Cambiar de checkpoint es el experimento más fácil y, por tanto, el que la mayoría de los equipos prueba primero. Rara vez es el que mueve la cifra. Construye el log, arregla la delegación, discute con el plan, y luego sal a buscar un modelo.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.