
Qwen3.8-Max: Alibaba publica en abierto un modelo de 2,4T y le pone precio de modelo cerrado (2026)

By Surya Pratap
6 de agosto de 2026
12 min read
AI & Technology

6 de agosto de 2026
12 min read
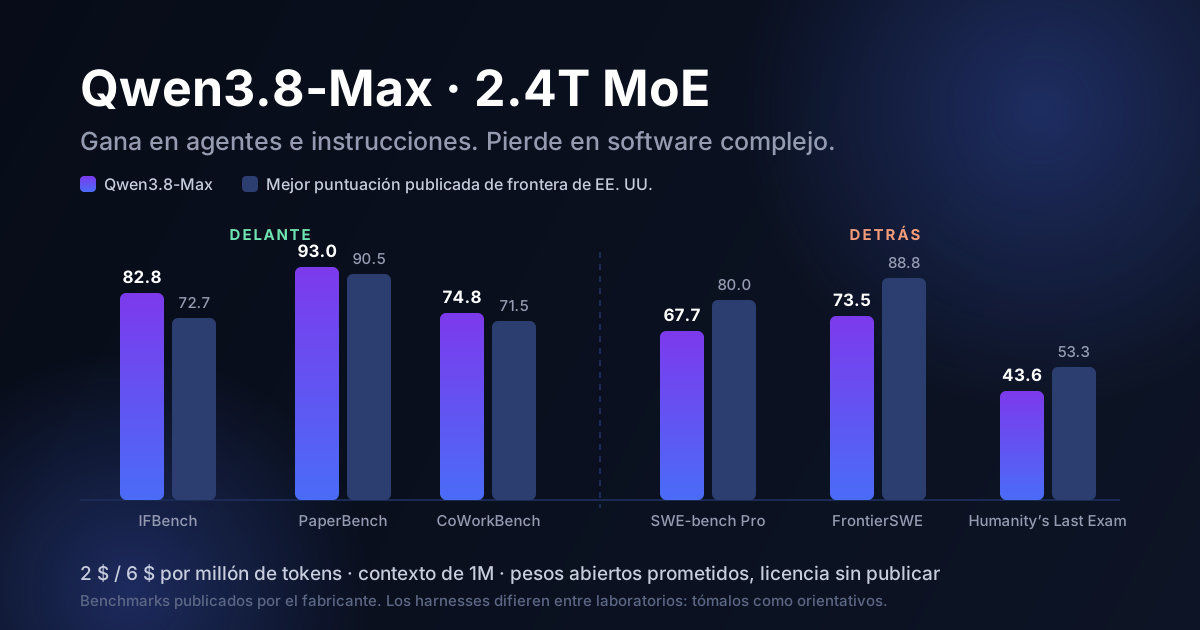
El 3 de agosto, Alibaba lanzó Qwen3.8-Max: 2,4 billones de parámetros en total, 95.000 millones activos por token, una ventana de contexto de un millón de tokens y entrada de texto, imagen y vídeo. Es el mayor modelo que ha publicado el equipo de Qwen, y es el primer Qwen de clase Max que Alibaba ha dicho que publicará en abierto.
Hay dos detalles más interesantes que el número de parámetros. El primero es el precio: 2 dólares por millón de tokens de entrada y 6 dólares por millón de salida. Eso no es un descuento. Es más o menos lo que cobran los laboratorios cerrados de EE. UU., viniendo de una empresa cuyo argumento competitivo durante dos años ha sido rebajarles el precio. El segundo es que, en el momento de escribir esto, los pesos no están en Hugging Face y no se ha publicado ningún texto de licencia: el anuncio decía «la semana que viene».
Ambas cosas te dicen más sobre qué hacer a continuación que la tabla de benchmarks. Esta es la lectura honesta.
Qwen3.8-Max es un modelo disperso de mezcla de expertos: 2,4T en total, unos 95.000 millones activados por token, y por eso se puede servir a un precio que no tiene nada que ver con su tamaño. La ventana de contexto es de 1M de tokens: 991.000 de entrada como máximo, que bajan a 983.000 con el razonamiento activado, 131.000 de salida como máximo, y un presupuesto de razonamiento que puede llegar a 262.000 tokens. Las entradas son texto, imagen y vídeo; la salida es solo texto.
La API está disponible de inmediato a través de Alibaba Cloud Model Studio y QwenCloud, con formatos compatibles con OpenAI y DashScope, y también con el protocolo de Anthropic. Los límites de uso publicados son generosos: 2M de tokens por minuto y 15.000 peticiones por minuto. Admite llamadas a funciones, salidas estructuradas, procesamiento por lotes, completado de prefijos y ajuste fino, además de cinco herramientas integradas: intérprete de código, búsqueda web, extractor web, y búsqueda de imagen a imagen y de texto a imagen.
La caché es donde el precio se pone interesante. Las lecturas de caché implícita cuestan 0,25 dólares por millón de tokens, una octava parte del precio sin caché. La creación de caché explícita cuesta 2,50 dólares, con lecturas a 0,17. Para un agente que repite un prefijo grande y estable en cada turno, esa es la línea de la factura que decide si un flujo de trabajo es asumible.
Junto a él se anunció un segundo checkpoint, Qwen3.8-27B, también previsto con pesos abiertos. Todavía no tiene ficha técnica, ni tabla de benchmarks, ni precio. Guárdate eso: para la mayoría de quienes leen esto, el 27B es el lanzamiento que importa, y es del que menos sabemos.
Alibaba publicó un conjunto de comparaciones amplio. Léelo como dos historias distintas, porque eso es lo que es.
| Benchmark | Qwen3.8-Max | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| IFBench (seguimiento de instrucciones) | 82,8 | 72,7 | 63,5 |
| PaperBench | 93,0 | 90,5 | — |
| CoWorkBench | 74,8 | 71,5 | — |
| WorkSpaceBench | 67,7 | 65,6 | — |
| GPQA Diamond | 92,6 | — | — |
| OmniDocBench 1.5 | 92,1 | — | — |
| Terminal-Bench 2.1 | 86,6 | 88,8 | — |
| SWE-bench Pro | 67,7 | — | 80,0 |
| DeepSWE 1.1 | 56,6 | — | 70,0 |
| FrontierSWE | 73,5 | — | 88,8 |
| Humanity's Last Exam | 43,6 | 47,2 | 53,3 |
| MRCR v2 (contexto largo) | 92,9 | 93,8 | — |
El patrón es lo bastante claro como para enrutar en función de él. Qwen3.8-Max lidera en seguimiento de instrucciones, comprensión de documentos, recuperación en contexto largo y trabajo agéntico de oficina acotado. Va por detrás, por dos cifras, en ingeniería de software difícil y razonamiento abierto: 12 puntos menos en SWE-bench Pro, 15 en FrontierSWE, 13 en DeepSWE y 10 en Humanity's Last Exam.
IFBench merece una segunda mirada, porque es la cifra más infravalorada de la tabla y la que más directamente afecta a la fiabilidad en producción. 82,8 frente a 72,7 y 63,5 no es una ventaja marginal. El seguimiento de instrucciones es lo que decide si tu esquema JSON vuelve válido, si el modelo se detiene cuando se le dice que pare, si la llamada a herramienta tiene la forma que espera tu harness. Diez puntos de ventaja ahí se notan en tu tasa de errores antes que en cualquier demo de capacidades.
Los resultados vistosos son vistosos. En un benchmark de comercio electrónico simulado de 365 días, el modelo terminó con 416.252 ¥, aproximadamente un 38 % por delante de GLM 5.2 y más del doble de lo que consiguió Qwen3.7-Max. En una tarea de diseño de chips, redujo un acelerador criptográfico de 8.298 puertas lógicas a 678, una reducción del 81 % de superficie de silicio. Tómalos como demostraciones de capacidad, no como evidencias sobre tu carga de trabajo.
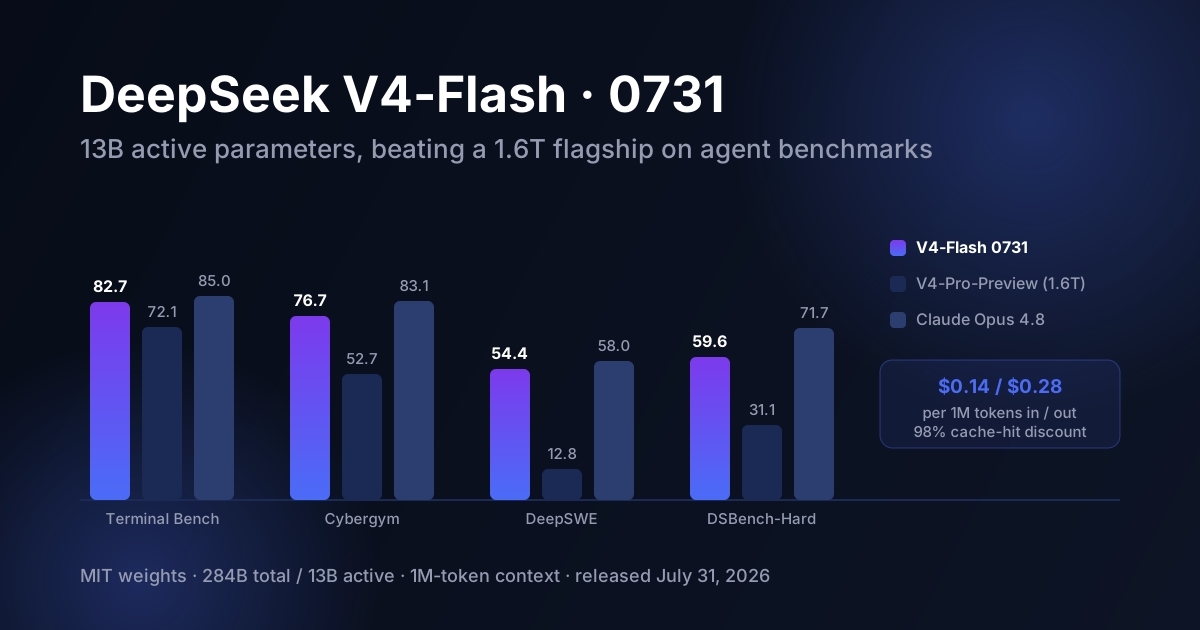
Pon Qwen3.8-Max al lado de lo que salió de China tres días antes. V4-Flash de DeepSeek cuesta 0,14 dólares de entrada y 0,28 de salida. Qwen3.8-Max cuesta 2 y 6 dólares: catorce y veintiuna veces más caro, desde el mismo ecosistema en sentido amplio y en la misma semana.
Es un movimiento de posicionamiento deliberado, y marca un cambio. Durante dos años, los laboratorios chinos compitieron siendo drásticamente más baratos que la frontera. Alibaba acaba de renunciar a eso. Le puso un precio a la par con los modelos cerrados de EE. UU. y dejó que la tabla de benchmarks defendiera el argumento. La apuesta es que a las empresas que eligen una plataforma de agentes les importa más que el modelo complete la tarea que el hecho de que cueste una quinta parte.
Qué significa esto para tu modelo de costes
Si dabas por hecho que «la opción china de pesos abiertos es siempre el nivel barato», esa suposición ha dejado de ser fiable. Ahora hay modelos de pesos abiertos en los dos extremos de la curva de precios, y la etiqueta no te dice nada sobre la factura. Pon precio a ese modelo concreto frente a tu tráfico concreto. El único dato independiente que merece la pena citar aquí: el Vals Index midió que Qwen3.8-Max empata con Claude Opus 4.7, 66,1 frente a 66,1, con un coste por prueba unas 2,3 veces menor. Es una ventaja de eficiencia real frente a la frontera cerrada y, a la vez, está muy lejos de la economía de DeepSeek.
Esta es la parte que la mayoría de la cobertura pasa por alto. Hay tres cosas ciertas a la vez, y necesitas las tres.
Una: los pesos no han salido. Alibaba los prometió para «la semana que viene» en Hugging Face y ModelScope. A 6 de agosto no se ha publicado nada de ninguno de los dos checkpoints, y no se ha dado fecha. Un lanzamiento prometido es un elemento de hoja de ruta, no un activo con el que puedas planificar. Los precedentes apuntan en las dos direcciones: Qwen3.6-35B-A3B y Qwen 4 Coder salieron con Apache 2.0 desde el primer día, pero Qwen3.6-Plus, Qwen3.7-Max y Qwen3.7-Plus se quedaron cerrados y solo por API. Este lanzamiento invierte ese segundo patrón, y conviene confirmar las inversiones antes de construir sobre ellas.
Dos: no se ha publicado ningún texto de licencia. Profesionales que revisaron el anuncio señalaron aparentes prohibiciones geográficas que cubrirían EE. UU., la UE, el Reino Unido y Corea, y Alibaba no lo ha aclarado. Mientras no exista el archivo de licencia, no sabes si recibes Apache 2.0, una licencia comunitaria restrictiva o algo con cláusulas territoriales que lo hagan inutilizable para tus clientes. Un modelo de 2,4T con una licencia comunitaria restrictiva sigue siendo técnicamente de «pesos abiertos», mientras cambia por completo lo que puedes lanzar.
Tres: con 2,4 billones de parámetros, «puedes descargarlo» casi no significa nada para una startup. Servir este modelo exige como mínimo ocho GPU de la clase H100 o B200. Eso no es un portátil, ni una estación de trabajo, ni una instancia de nube que levantas para probar algo. Para la inmensa mayoría de los equipos, los pesos abiertos no cambian nada en lo operativo: usarás la API, exactamente igual que con un modelo cerrado. Lo que los pesos compran de verdad es opcionalidad para grandes empresas con requisitos de residencia de datos, y una base para el trabajo de destilación y ajuste fino que producirá los modelos que acabarás ejecutando.
Por eso el checkpoint interesante es el 27B. Es el que funciona en hardware que una startup puede tener, el que se puede ajustar sobre tu base de código, el que podría importar para tus márgenes. Y ahora mismo no tiene ninguna especificación publicada. Si Qwen3.8 acaba importando para tu negocio, probablemente será a través de ese modelo, así que estate atento a la ficha del 27B, no al titular del Max.
reasoning_effort entre ellos— sin aviso y sin efecto. Si tu harness envía peticiones con forma de OpenAI, puede que no estés configurando nada mientras crees haber configurado algo. Comprueba que el comportamiento cambia al cambiar el parámetro; no te fíes de la ausencia de error.Dada la forma de la evidencia, esto es lo que yo haría de verdad.
La tentación con un lanzamiento tan grande es leerlo como una actualización del marcador. Es más útil como lectura de hacia dónde se ha movido la competencia.
Durante dos años, los laboratorios chinos compitieron en precio, y la pregunta estratégica para los fundadores era hasta dónde caería el suelo. Alibaba acaba de negarse a jugar a eso con su modelo insignia. Le puso un precio a la par, abrió los pesos de un modelo que casi nadie puede alojar por su cuenta, y orientó todo el lanzamiento a cargas de agentes empresariales: tareas de oficina, procesamiento de documentos, trabajo con contexto largo, cumplimiento de instrucciones. DeepSeek sigue empujando el suelo hacia abajo; Alibaba compite por el techo. Son guerras distintas, y ahora se libran a la vez.
En la práctica, eso significa que la capa de modelos sigue ganando capacidad en todos los niveles de precio y sigue diferenciando cada vez menos. Qwen3.8-Max quedará superado en un trimestre, probablemente por algo de esta misma familia. La decisión de enrutamiento que tomes esta semana estará equivocada en dos. No es motivo para ignorar los lanzamientos; es motivo para construir de forma que responder a ellos sea barato: un gateway en lugar de un SDK cableado, un conjunto de evaluación en lugar de una impresión, prompts organizados para reutilizar la caché en lugar de montados sobre la marcha.
Y merece la pena fijarse en lo que dice la división de los benchmarks. Las carencias no están en la inteligencia bruta: un 92,6 en GPQA Diamond es nivel de frontera. Las carencias están en el trabajo agéntico de software de largo horizonte, las tareas en las que el modelo tiene que sostener un plan durante cuarenta pasos y recuperarse de sus propios errores. Es la misma carencia que los fundadores encuentran un nivel más arriba en el stack, cuando la demo funciona y producción no. Enrutes al modelo que enrutes, ese sigue siendo el trabajo que te toca a ti.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.