DeepSeek V4-Flash sale de la vista previa y supera a su propio buque insignia: guía para fundadores (2026)

By Surya Pratap
4 de agosto de 2026
13 min read
AI & Technology

4 de agosto de 2026
13 min read
El 31 de julio, DeepSeek sacó V4-Flash de la vista previa. Sobre el papel es el tipo de lanzamiento menos interesante: ni arquitectura nueva, ni nuevo número de parámetros, ni nueva ventana de contexto. El modelo salió exactamente con el mismo cuerpo de mezcla de expertos de 284B/13B que tenía en abril. Lo que cambió fue el post-entrenamiento.
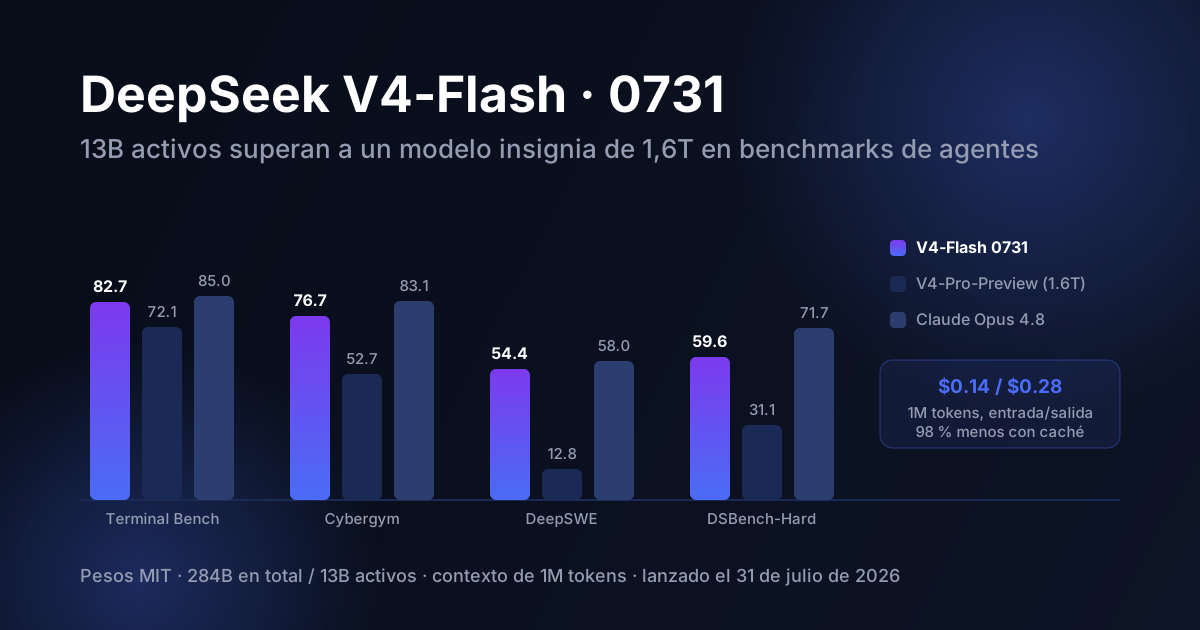
Y ese modelo pequeño, con un post-entrenamiento nuevo, supera ahora al propio buque insignia de DeepSeek, el V4-Pro-Preview de 1,6 billones de parámetros, en los nueve benchmarks de agentes publicados, con márgenes de entre 8,7 y 41,6 puntos. Cuesta 0,14 dólares por millón de tokens de entrada y 0,28 por millón de salida. Tiene licencia MIT. Puedes descargar los pesos.
Hay una lección real aquí para cualquiera que construya un producto de IA, y no es «pásate a DeepSeek». Tiene que ver con de dónde viene realmente la capacidad en 2026, y con lo que eso hace a la suposición —todavía incrustada en el modelo de costes de la mayoría de los fundadores— de que un mejor comportamiento de agente exige un modelo más grande y más caro.
La entrada del registro de cambios es corta y merece leerse al pie de la letra. El endpoint deepseek-v4-flash sirve ahora la versión 0731. La arquitectura y el tamaño no cambian respecto a la vista previa; el modelo se volvió a post-entrenar, con un módulo de decodificación especulativa DSpark añadido para mejorar el rendimiento. Ganó soporte nativo para el formato de la Responses API de OpenAI y una adaptación a Codex desde el primer día. El control del razonamiento pasó a tener tres niveles explícitos —low, high, max—, que es la forma que los harnesses de agentes esperan de reasoning_effort.
Las especificaciones de fondo: 284B parámetros en total con 13B activados, una ventana de contexto de 1M de tokens con hasta 384.000 tokens de salida, una pila de atención híbrida que combina atención dispersa comprimida y atención muy comprimida, expertos en FP4 con FP8 en el resto, y unos 167 GB de pesos en disco con licencia MIT. Los identificadores antiguos deepseek-chat y deepseek-reasoner se retiraron el 24 de julio, así que ahora solo funcionan los dos endpoints de V4.
El contexto comercial también importa. DeepSeek levantó 7.400 millones de dólares con una valoración de unos 350.000 millones de yuanes, con la participación de Tencent y NetEase, y ha dicho que el dinero se destinará a casi duplicar la plantilla, con el foco en los agentes. La versión preliminar de Flash ya había pasado siete semanas seguidas como el modelo más usado en OpenRouter. No es un laboratorio que lance una curiosidad.
Estas son las cifras de agentes publicadas, con la versión preliminar incluida para que veas qué parte de la mejora es post-entrenamiento y no marketing.
| Benchmark | Flash 0731 | Flash Preview | V4-Pro-Preview | Opus 4.8 |
|---|---|---|---|---|
| Terminal Bench 2.1 | 82,7 | 61,8 | 72,1 | 85,0 |
| Cybergym | 76,7 | 38,7 | 52,7 | 83,1 |
| DeepSWE | 54,4 | 7,3 | 12,8 | 58,0 |
| NL2Repo | 54,2 | 39,4 | 38,5 | 69,7 |
| Toolathlon-Verified | 70,3 | 49,7 | 55,9 | 76,2 |
| DSBench-FullStack | 68,7 | 37,0 | 41,8 | 71,6 |
| DSBench-Hard | 59,6 | 25,8 | 31,1 | 71,7 |
| Agents' Last Exam | 25,2 | 15,8 | 16,5 | 25,7 |
| AutomationBench Public | 25,1 | 10,8 | 12,8 | 27,2 |
Dos cosas saltan a la vista. La primera es DeepSWE: de 7,3 a 54,4 con los mismos pesos. Un salto tan grande suele significar que el modelo preliminar podía hacer la tarea pero nunca le habían enseñado el harness: fallaba en el formato, en la disciplina de las llamadas a herramientas y en saber cuándo parar, no en el razonamiento. El post-entrenamiento arregló la interfaz, y la capacidad que ya estaba ahí apareció.
La segunda es la columna de Opus 4.8. Flash 0731 está cerca en Terminal Bench (82,7 frente a 85,0), Agents' Last Exam (25,2 frente a 25,7) y DeepSWE (54,4 frente a 58,0), y claramente por detrás en los dos más difíciles: NL2Repo (54,2 frente a 69,7) y DSBench-Hard (59,6 frente a 71,7). Ese patrón es coherente y es el que debería guiar tu enrutamiento. La distancia se cierra en tareas de agente acotadas y bien especificadas. Sigue abierta en el trabajo largo, ambiguo y de repositorio completo, donde una mala decisión en el paso 40 te cuesta la ejecución.
Las mediciones independientes coinciden a grandes rasgos. Artificial Analysis sitúa V4-Flash 0731 en 50 en su Intelligence Index: tercero entre los modelos de pesos abiertos, frente a una mediana de 25, al nivel de Gemini 3.6 Flash y por detrás de Claude Opus 5, que ronda los 59. La velocidad de salida es de 113,5 tokens por segundo frente a una mediana de 61,4 entre sus pares, con un tiempo hasta el primer token de 1,31 segundos.
Los benchmarks se llevan los titulares; la línea de precio es lo que cambia lo que puedes construir. Artificial Analysis midió el coste de pasar toda su batería del Intelligence Index por cada modelo:
Es una diferencia de aproximadamente cien veces para una brecha de capacidad de nueve puntos en un índice de cien. La economía de la caché es todavía más agresiva: un acierto de caché cuesta 0,003 dólares por millón de tokens, un descuento del 98 % y el mayor del sector. Si tu agente repite en cada turno un prompt de sistema grande y estable y un corpus fijo —que es lo que hacen la mayoría de los agentes en producción—, ese descuento no es un redondeo: es la diferencia entre un flujo de trabajo que puedes ofrecer en un plan de 29 dólares y uno que no puedes ofrecer en absoluto.
DeepSeek también recortó los costes de la API hasta un 50 % con este lanzamiento, y el patrón ya es lo bastante conocido como para que Axios lo presentara como una carrera hacia cero, con la observación de que los descuentos implacables de los laboratorios chinos presionan las futuras salidas a bolsa (IPO) de OpenAI y Anthropic. Se cumpla o no esa tesis, la consecuencia operativa para ti es inmediata: el precio mínimo del trabajo agéntico competente ha vuelto a caer, y cualquier modelo de precios que construyeras suponiendo que la inferencia es cara tiene una vida útil más corta de lo que planeaste.
El impuesto de la verbosidad
Artificial Analysis señala que V4-Flash es «muy verboso»: consumió 210M de tokens de salida en su evaluación, frente a una mediana de 100M entre sus pares. Los tokens de salida son la mitad cara de la factura. Un modelo con una décima parte del precio de salida que emite el doble de tokens supone un ahorro de cinco veces, no de diez, y tu proporción real depende de tus prompts. Mide el coste por tarea completada con tus propias trazas, no el coste por millón de tokens de una página de precios.
Segunda: los precios en hora punta. DeepSeek ha anunciado un multiplicador de 2× entre las 09:00 y las 12:00 y entre las 14:00 y las 18:00, hora de Pekín. No estaba en vigor en el lanzamiento, pero si tu tráfico se concentra en las mañanas de Europa o de EE. UU., modela la tarifa multiplicada y no la de portada antes de comprometer un margen con un cliente.
Tercera, y la menos comentada: son benchmarks de agentes, y los benchmarks de agentes premian justo lo que se acaba de post-entrenar. Un salto de 41 puntos en DeepSWE solo por volver a post-entrenar debería hacerte sospechar un poco más del benchmark, no solo impresionarte más con el modelo. Te dice que la puntuación es muy sensible al encaje con el harness. Tu harness no es el suyo. Pasa tu propio conjunto de evaluación —el pequeño, construido con tareas reales de usuarios— antes de enrutar tráfico de producción a algo nuevo.
La comparación no es del todo justa, y entender por qué es lo útil. Flash 0731 es un producto terminado y ajustado para agentes. V4-Pro-Preview es una vista previa: una demostración de capacidad base que no ha recibido el mismo tratamiento. DeepSeek dice que el lanzamiento oficial de V4-Pro es inminente, con soporte de la Responses API y de Codex a principios de agosto, y cuando llegue, el orden casi seguro se invertirá de nuevo.
Pero «la comparación no es justa» es el hallazgo. Lo que separó a los dos modelos en nueve benchmarks no fueron cinco billones y medio de parámetros de capacidad bruta. Fue si alguien le había enseñado al modelo a comportarse dentro de un bucle de agente: cuándo llamar a una herramienta, cómo dar formato a la llamada, cuándo dejar de razonar y actuar, cómo recuperarse de un paso fallido. La escala compró la capacidad de fondo. El post-entrenamiento fue lo que la convirtió en tareas completadas.
Eso encaja casi exactamente con lo que los fundadores siguen descubriendo un nivel más arriba en el stack. La demo funciona porque el modelo es capaz. La producción falla porque nada alrededor del modelo sabe ejecutar un bucle de forma fiable; la misma razón por la que la ingeniería de contexto, los conjuntos de evaluación y los sistemas de permisos siguen resultando más importantes que el modelo de frontera que elegiste. DeepSeek acaba de demostrar el mismo principio dentro de los propios pesos.
V4-Pro es el hermano de 1,6T, publicado como vista previa de pesos abiertos con licencia MIT el 24 de abril y con un precio de 0,435/0,87 dólares por millón de tokens. Obtiene alrededor de 80,6 en SWE-bench Verified en modo de razonamiento máximo: competitivo, no líder. La historia de la arquitectura es realmente impresionante en eficiencia: con un contexto de 1M de tokens, V4-Pro necesitaría alrededor del 27 % de los FLOPs de inferencia por token y el 10 % de la caché KV que requería V3.2, y eso es lo que hace que un contexto de un millón de tokens sea económicamente viable y no solo un reclamo publicitario.
Hay una comparación de costes de un análisis profesional que merece la pena retener: la implementación de una funcionalidad representativa de tamaño medio cuesta unos 0,12 dólares con V4-Pro frente a unos 10,00 dólares en un nivel premium de frontera. Incluso descontando la advertencia de la verbosidad y la tasa de fallos que observes, es otra categoría de economía unitaria, y es la razón por la que «usa el mejor modelo para todo» dejó de ser un valor por defecto defendible hace aproximadamente un año.
La tentación con un lanzamiento así es tratarlo como una señal de compra de un proveedor. No lo es. DeepSeek va por detrás de Kimi K3 de Moonshot, con 2,8 billones de parámetros; algo en octubre rebajará a Kimi, y el modelo competente más barato de cualquier mes es un blanco móvil sobre el que nunca deberías construir la identidad de un producto.
Lo duradero es la dirección. La capacidad a un precio dado cae deprisa, el nivel de pesos abiertos está ya tan cerca de la frontera en trabajo agéntico acotado que la elección es una decisión de enrutamiento y no de calidad, y el coste marginal de la capa de modelos se dirige al suelo. Si la ventaja de tu producto es tener acceso a un buen modelo, esa ventaja se está devaluando en público, lanzamiento a lanzamiento.
La ventaja que sobrevive es justo la que DeepSeek acaba de demostrar que importa: el trabajo de hacer fiable un sistema capaz dentro de un bucle concreto, en un dominio concreto, para un usuario concreto. Esa fue la distancia entre 7,3 y 54,4 con los mismos pesos. Y es también, más o menos exactamente, la distancia entre una demo de IA y un negocio de IA.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.