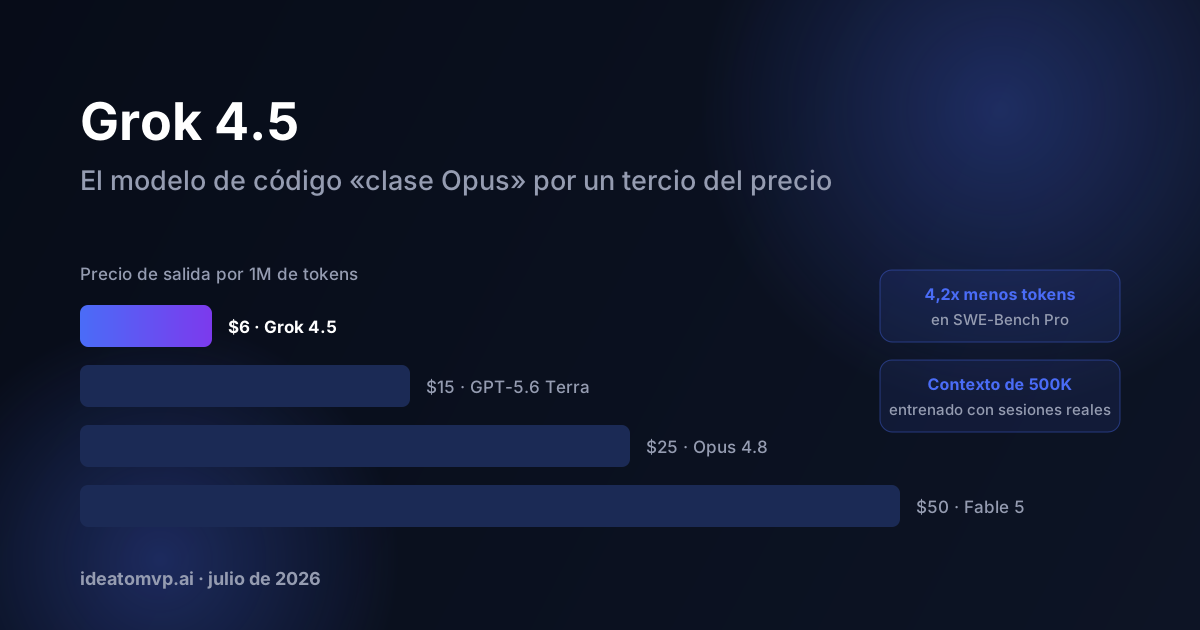
Julio de 2026 se recordará como el mes en que la guerra de los modelos se convirtió en una guerra de precios. Un día antes de que OpenAI lanzara GPT-5.6, xAI publicó Grok 4.5, su primer modelo entrenado específicamente para programar y para agentes autónomos, a $2 por millón de tokens de entrada y $6 por millón de salida. El posicionamiento de Elon Musk fue, como de costumbre, directo: «Es un modelo clase Opus, pero más rápido, más eficiente en tokens y más barato». No el modelo más inteligente del mundo, sino el más económico de los que son lo bastante buenos para trabajo real de ingeniería.
Ese enfoque, «más barato y suficientemente bueno» como estrategia de titular y no como excusa, es nuevo en un laboratorio de frontera, y las reacciones en X y LinkedIn durante la semana del lanzamiento se dividieron justo por esa línea. Esto es lo que el modelo es en realidad, lo que dicen los primeros usuarios y cómo debería pensarlo un fundador.
Qué es Grok 4.5 en realidad
- Un modelo pensado primero para programar y para agentes. xAI lo entrenó con datos de sesiones reales de desarrolladores gracias a su acuerdo con Cursor: sesiones completas dentro de bases de código reales, no solo corpus de código estáticos. El objetivo de diseño es un agente que aguante una sesión larga sin descarrilar.
- $2 / $6 por millón de tokens, 500K de contexto. Es más de un 60% más barato que Opus 4.8 y GPT-5.5 a precio de lista, con la entrada en caché a $0.50.
- Extremadamente eficiente en tokens. En SWE-Bench Pro, xAI afirma que Grok 4.5 resuelve las tareas con una media de ~16K tokens de salida, frente a ~67K de Opus 4.8 en modo máximo: una diferencia de 4,2 veces. Como los tokens de salida son lo que más pagas, la eficiencia multiplica el descuento de la etiqueta: Artificial Analysis lo midió en $0.49 por tarea completada, casi un 90% más barato que los modelos que tiene por encima en su clasificación.
Los benchmarks, leídos con honestidad
La imagen honesta es mixta, y por eso más interesante. En el Intelligence Index de Artificial Analysis, Grok 4.5 obtiene 54, cuarto en la general, por detrás de Fable 5 (60), Opus 4.8 (56) y GPT-5.5 (55). De los cuatro benchmarks que xAI eligió publicar, supera a Opus 4.8 en dos (DeepSWE 1.0 y Terminal-Bench 2.1) y pierde en otros dos (DeepSWE 1.1 por 6 puntos y SWE-Bench Pro por 4.5).
Dicho de otro modo: no es el mejor modelo. Es un modelo que roza legítimamente la frontera por una fracción del coste por tarea, y xAI no finge lo contrario. El propio Musk planteó el objetivo como «cerrar el círculo de la utilidad en el mundo real, no de los benchmarks», y citó que los ingenieros más exigentes de Tesla y SpaceX lo encuentran realmente útil.
Lo que se dice en X y LinkedIn
- Los primeros usuarios de Cursor están impresionados. La reseña temprana más compartida, del desarrollador Danny Limanseta, lo definió como «Opus 4.8 al doble de velocidad y a un precio mucho más bajo», tras una sesión completa de lluvia de ideas, planificación e implementación de una funcionalidad compleja de un videojuego sin necesidad de correcciones manuales entre pasos.
- La lectura en LinkedIn va del modelo de negocio. El comentario que más se difundió no hablaba de capacidad en absoluto: decía que un laboratorio de frontera compite ahora sobre todo en precio por tarea completada, una métrica que los analistas presentaron como capaz de sacudir la estructura de márgenes tanto de Anthropic como de OpenAI.
- Los escépticos señalan la selección de benchmarks. Publicar los dos benchmarks que ganas junto a los dos que pierdes da cierta credibilidad, pero los críticos en X apuntaron que «clase Opus» se compara con el nivel anterior de Anthropic, no con Fable 5. Incluso la comparación del propio Musk fue con «más o menos Opus 4.7».
La cifra que importa: coste por tarea completada
El precio por token es la etiqueta; el coste por tarea completada es la factura. Un modelo un 20% menos capaz, que usa 4 veces menos tokens y cuesta un 60% menos por token, gana en economía en cada tarea que de verdad puede terminar. La pregunta correcta nunca es «¿es más listo?», sino «¿qué parte de mi carga de trabajo puede completar, y a qué coste por tarea completada?».
Dónde encaja Grok 4.5 en el stack de una startup
- El puesto de ejecutor acaba de recibir un aspirante serio. En el stack planificar → ejecutar → revisar que contamos la semana pasada, Grok 4.5 cae de lleno en el nivel de ejecución, con más capacidad que los ejecutores baratos habituales. Para los bucles de programación agéntica en los que el consumo de tokens es el problema, su perfil de eficiencia es justo lo que pedía quien gasta $200 al día.
- Las sesiones largas son su terreno. Entrenado con datos reales de sesiones completas y con 500K de contexto, está hecho para el patrón «sigue trabajando en esta base de código durante una hora», no para fragmentos sueltos. Pruébalo primero en tus flujos de agentes más largos.
- De momento, deja la planificación y la revisión en otro sitio. El cuarto puesto en inteligencia general es excelente para su precio, pero las decisiones de arquitectura y la revisión final siguen correspondiendo al mejor razonador que puedas permitirte, y la revisión entre familias de modelos importa más, no menos, a medida que cada laboratorio optimiza con más fuerza para los benchmarks agénticos.
- Aprovecha la guerra de precios a tres bandas. Grok 4.5 el 8 de julio, GPT-5.6 el 9 de julio y Anthropic restableciendo los límites de uso en menos de una hora: tres laboratorios de frontera pujan por tu carga de trabajo en la misma semana. Si cerraste los precios con tu proveedor de IA hace más de un trimestre, estás pagando de más.
Conclusión
Grok 4.5 es la señal más clara hasta ahora de que la frontera se está dividiendo en dos carreras: una por la máxima inteligencia y otra por el mínimo coste por tarea completada. Los fundadores no tienen que elegir bando: un stack bien enrutado se beneficia de ambas. Coloca Grok 4.5 en tu nivel de ejecución, ponlo a prueba con tus cargas de trabajo reales durante una semana y deja que sean los números, y no los tuits del lanzamiento, los que decidan qué parte de tu carga de trabajo se gana.
¿Quieres ayuda para comparar los nuevos modelos con las cargas de trabajo reales de tu producto? Reserva una llamada de descubrimiento gratuita: cada mes construimos y ajustamos stacks de enrutamiento de modelos para fundadores.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.