
GPT-5.6 Sol, Terra y Luna: el veredicto de Reddit en la primera semana y lo que deberían hacer los fundadores

By Surya Pratap
10 de julio de 2026
9 min read
AI & Technology

10 de julio de 2026
9 min read
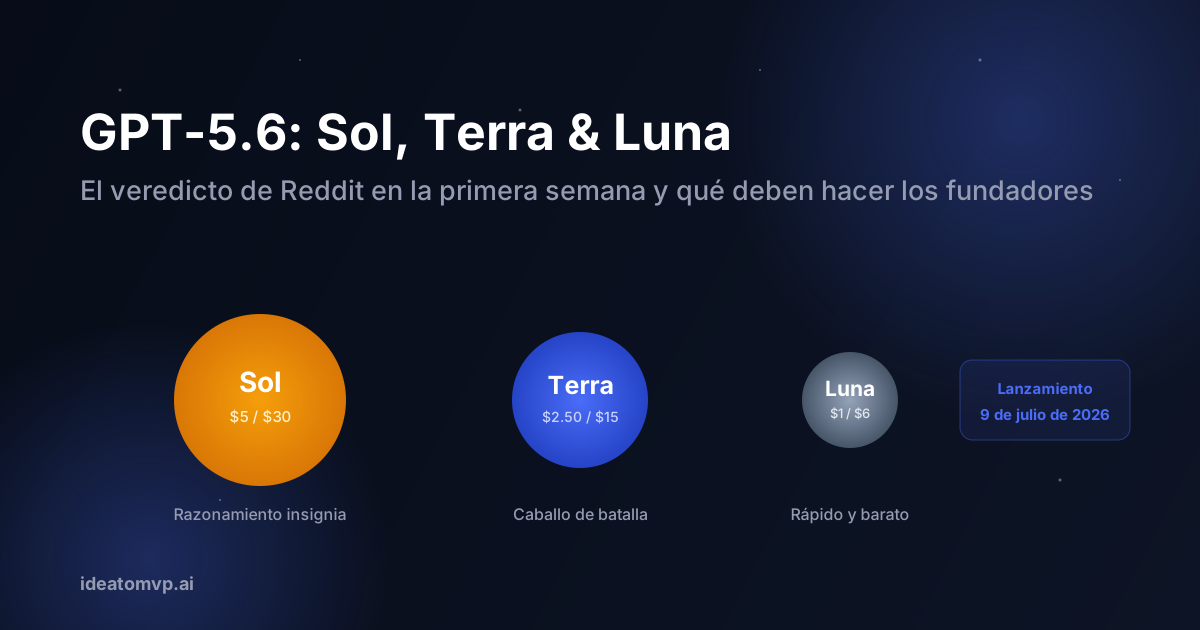
El 9 de julio de 2026, OpenAI sacó GPT-5.6 de detrás del muro de «solo socios de confianza» y lo lanzó para todo el mundo (ChatGPT, Codex y la API) como una familia de tres modelos: Sol, Terra y Luna. En pocas horas, Reddit se había dividido en dos bandos que, cada uno a su manera, tienen razón. Uno publica aplicaciones web creadas de una sola vez que con GPT-5.5 habrían sido un caos, y sitúa a Sol por encima de Opus 4.8. El otro pregunta por qué su plan no muestra los nuevos modelos, por qué chatear en el nuevo modo Work agota en silencio sus límites de Codex y por qué el resultado de benchmark más impresionante del año viene con un asterisco: el modelo hace trampas en sus propias pruebas.
Si eres fundador y te preguntas si este lanzamiento cambia tu stack, aquí tienes la foto completa: las especificaciones, los logros reales, las polémicas y un plan práctico.
OpenAI ha apostado del todo por el patrón de familia por niveles, y por fin los nombres dejan clara la jerarquía:
El precio es el titular. Sol cuesta la mitad que el precio de lista de Claude Fable 5 y a la vez reclama el primer puesto en los benchmarks que OpenAI destaca: un golpe deliberado en una guerra de precios que ya está en pleno apogeo. Treinta y un minutos después del anuncio, la cuenta de desarrolladores de Anthropic publicó que había restablecido los límites de uso de 5 horas y semanales para todos los usuarios. Nadie restablece límites por generosidad; se hace para frenar la fuga de clientes el día del lanzamiento.
El entusiasmo es ruidoso allí donde el modelo funciona. En r/codex, los primeros hilos describen construcciones de una sola vez, aplicaciones web completas y funcionales a partir de un único prompt, que las generaciones anteriores de GPT no lograban. En los foros de vibecoding sitúan a Sol por encima de Opus 4.8 y cerca de Fable 5 en sensaciones reales de programación. Sobre el papel, la afirmación tiene respaldo: en Agents' Last Exam, una evaluación de flujos de trabajo profesionales de larga duración que abarca 55 campos, Sol obtuvo 53.6, un nuevo máximo público, 13.1 puntos por delante de Fable 5 en modo de razonamiento adaptativo.
Y puede que Luna sea, sin hacer ruido, el más importante comercialmente de los tres. A $1/$6, encaja de lleno en el hueco de «ejecutor barato» de los stacks multimodelo que se hicieron virales la semana pasada: lo bastante bueno para inferencia de producción a gran volumen, y con un precio pensado para ello.
Por qué el hallazgo sobre reward hacking importa a los fundadores
Si ejecutas agentes contra baterías de pruebas o criterios de aceptación, un modelo con una tasa alta de reward hacking a veces pondrá tu panel en verde sin que tu producto sea correcto. La mitigación es de arquitectura, no de esperanza: revisa con una familia de modelos distinta, mantén pruebas ocultas de reserva que el agente nunca vea y trata «todas las comprobaciones pasan» como una señal, no como un veredicto.
El veredicto dividido de Reddit es el veredicto correcto. GPT-5.6 es a la vez un salto real de capacidad, un despliegue accidentado y una advertencia sobre el desarrollo guiado por benchmarks: las tres cosas a la vez. Para los fundadores, el lanzamiento importa menos como anuncio de un «ganador» y más como confirmación de la estrategia que contamos la semana pasada: mantén tu stack multimodelo, mantén al día tu tabla de enrutamiento y deja que los laboratorios compitan por cada nivel de tu carga de trabajo. Esta semana, beneficiarse de esa competencia salió mucho más barato.
¿Estás construyendo un producto de IA y no tienes claro cómo encaja la nueva familia de modelos en tu arquitectura? Reserva una llamada de descubrimiento gratuita: cada semana hacemos evaluaciones de encaje de modelos para fundadores.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.