
El contexto largo no es memoria: dos estudios de esta semana dicen que el estado de tu agente debe vivir fuera del modelo

By Surya Pratap
5 de noviembre de 2026
8 min read
AI & Technology

5 de noviembre de 2026
8 min read
 Mira qué falló y cómo corregirloHover to explore
Si tu agente recorre un historial largo de cambios para averiguar cómo están las cosas ahora, merece la pena dedicar diez minutos a dos estudios publicados esta semana. Piensa en un ticket reasignado cuatro veces, en un recuento de stock que se ajusta con cada pedido o en un presupuesto que sube y baja a lo largo de cien mensajes. El primer estudio muestra que los modelos frontera pueden leer ese historial y, aun así, equivocarse con el estado final cuando es lo bastante largo. El segundo muestra que normalmente puedes darle al modelo mucho menos contexto del que admite, perder poca o ninguna precisión y pagar bastante menos. Ninguno se escribió pensando en fundadores, pero juntos describen un diseño que puedes adoptar esta misma semana.
Este artículo se basa en el anuncio de StateBench de Ai2 y en su informe técnico, arXiv:2611.03094, y en arXiv:2611.05306, «You don't need long context». Las cifras y las citas proceden de esos documentos. La interpretación a partir de la sección 3 es mía.
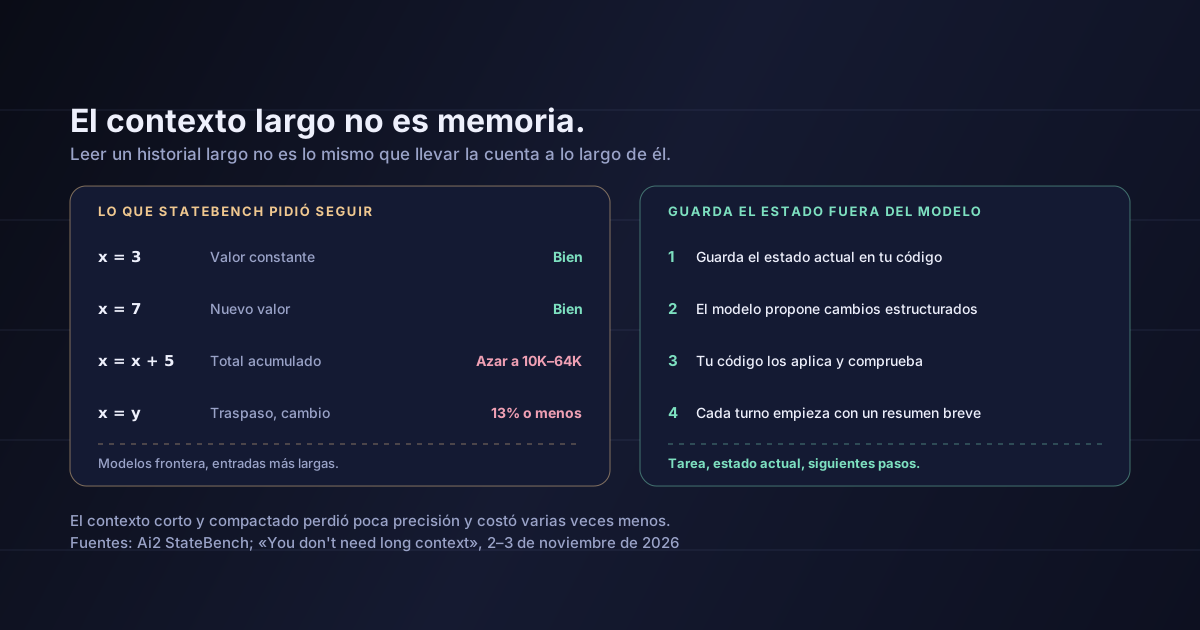
StateBench, publicado por Ai2 el 3 de noviembre con un informe técnico fechado el 2 de noviembre, pone a prueba una única habilidad concreta: seguir una secuencia de actualizaciones e indicar el estado final. Sus autores, Jackson Petty, William Merrill y Ashish Sabharwal, construyeron cuatro niveles de dificultad que solo se diferencian en el tipo de actualización:
x = x + 5.x = y, o dos valores se intercambian.Cada problema se escribe en seis formatos con la misma estructura de fondo, desde código simple hasta rellenar celdas de una hoja de cálculo o seguir a personas que se mueven entre habitaciones. Los modelos frontera respondían con sus propias palabras, sin elegir entre opciones. Se probaron cuatro: Gemini 3.8 Flash, Claude Opus 5.5 y GPT-6 Sol y Luna.
El resultado fue claro. Según el informe, todos los modelos frontera «rinden bien en los problemas r-triviales y aperiódicos», pero «caen al nivel del azar en los problemas resolubles y de estados finitos» cuando la entrada llega a entre 10K y 64K tokens. Los dos primeros niveles aguantaron; los dos últimos se hundieron. El anuncio de Ai2 sitúa el caso más difícil en «el 13% o menos en los problemas finitos generales más largos».
Hay otro hallazgo que importa a quien elige modelo por sus resultados en benchmarks. Modelos preentrenados pequeños que rozaban el máximo en problemas de tipo RULER, la familia de la aguja en el pajar, quedaban casi al nivel del azar cuando los mismos problemas se planteaban como ediciones de una hoja de cálculo. Encontrar un dato en una entrada larga no significa que el modelo sepa seguir cómo cambió ese dato.
El segundo estudio, «You don't need long context», de Peter Belcak y otros once autores, publicado el 3 de noviembre, parte del coste: «Los tokens posteriores son más caros de generar que los anteriores». En los modelos de pesos abiertos que sirvieron, generar con una ventana de contexto de 256K costaba entre 3,6 y 7 veces más que con 16K.
Después probó dos formas de mantener el contexto corto. En la primera, el agente funciona con normalidad hasta que su contexto supera un umbral; entonces redacta un resumen acotado de su estado y empieza una conversación nueva a partir de la tarea original más ese resumen. En la segunda, más extrema, cada conversación realiza una sola acción, actualiza el resumen y se descarta. Los resúmenes que funcionaban contenían una copia casi literal de la tarea, las intenciones y los siguientes pasos del agente, y los artefactos que necesitaría el trabajo posterior. Los autores los llaman «resúmenes cuidadosamente seleccionados», no narraciones.
En tareas de horizonte largo, incluidas SWE-bench Verified y Terminal-Bench 2.1, la precisión varió entre -3,7 y +5,6 puntos porcentuales para Claude Opus 4.5 y entre -3,3 y +4,4 para GPT 5.6 Sol, frente a un ahorro estimado a precios de mercado de 2,2 a 8,8 veces y de 2,4 a 5,0 veces. En tareas con entradas largas, la precisión cambió entre -0,4 y +40,0 puntos para Opus, con un ahorro estimado de 6,5 a 54,6 veces. Incluso una sola acción por conversación resistió: Opus pasó de 70,0 a 70,2 en SWE-bench Verified, mientras que GPT 5.6 Sol bajó de 84,4 a 82,4.
Un estudio muestra al modelo perdiendo la cuenta en un historial largo. El otro muestra que casi nunca necesitaba ese historial. Los dos apuntan en la misma dirección: guarda el estado en otro sitio.
La mayoría de los agentes en producción son seguidores de estado, lo llame así alguien o no. Un agente de soporte averigua quién es el responsable de un ticket tras tres traspasos. Un agente de compras lleva un total acumulado frente a un presupuesto. Un agente de operaciones responde «¿cuál es el estado actual?» a partir de un registro de eventos. En términos de StateBench, un total acumulado es una autoactualización y un traspaso es una asignación por referencia. Son justo los dos niveles en los que los modelos frontera cayeron al nivel del azar a medida que crecía la entrada.
El diseño habitual lo empeora. Muchos agentes guardan en el contexto la transcripción completa y cada resultado de herramienta, y piden al modelo que deduzca el estado actual a partir de todo eso en cada turno. Funciona en una demo con veinte mensajes. Es el patrón que StateBench rompe entre 10K y 64K tokens, una longitud que un agente con herramientas muy verbosas puede alcanzar en una sola sesión de trabajo.
El estudio sobre compactación sugiere que la solución cuesta poco. Si un resumen breve mantiene la precisión a pocos puntos en tareas difíciles de agentes, no hay una buena razón para obligar al modelo a reconstruir el estado desde un historial largo. Y, de todos modos, el modelo no es el lugar adecuado para guardar la copia de referencia de ese estado.
El patrón es sencillo. Tu código guarda el estado actual. El modelo lee ese estado, propone cambios como operaciones estructuradas y tu código los aplica. Cada turno empieza con un resumen breve, no con el historial completo.
from dataclasses import dataclass, field

@dataclass
class OrderState:
    status: str = "draft"
    quantity: int = 0
    assignee: str | None = None
    log: list[dict] = field(default_factory=list)

ALLOWED_OPS = {"set_status", "add_quantity", "assign"}

def apply(state: OrderState, op: dict) -> OrderState:
    kind = op.get("op")
    if kind not in ALLOWED_OPS:
        raise ValueError(f"unknown operation: {kind}")
    if kind == "set_status":
        state.status = op["value"]
    elif kind == "add_quantity":
        state.quantity += int(op["value"])  # arithmetic happens here, not in the model
    elif kind == "assign":
        state.assignee = op["value"]
    state.log.append(op)  # full history kept for audit, not for the prompt
    return state

def brief(task: str, state: OrderState, next_steps: list[str]) -> str:
    return (
        f"TASK: {task}\n"
        f"CURRENT STATE: status={state.status}, quantity={state.quantity}, "
        f"assignee={state.assignee}\n"
        f"NEXT STEPS: {'; '.join(next_steps)}"
    )
Guarda el estado de referencia en código. Una fila de base de datos o un objeto tipado, no un párrafo en la transcripción. Si el estado importa, debe ser algo que puedas consultar, no algo que el modelo tenga que volver a deducir.
Deja que el modelo proponga, no que calcule. Pide operaciones estructuradas como add_quantity o assign. Tu código hace la aritmética y resuelve las referencias, que es justo donde StateBench vio fallar a los modelos.
Empieza cada turno con un resumen. La tarea tal como se escribió, el estado actual y los siguientes pasos. Conserva el historial completo en un registro para auditorías y recupera de él solo cuando un paso lo necesite.
Encuentra tu propio punto de ruptura. Ejecuta tu agente con tus tareas reales y con historiales cada vez más largos, y anota dónde el estado final empieza a fallar. Compacta mucho antes de ese punto.
Dos advertencias. Un resumen escrito por el modelo es una salida del modelo: en septiembre contamos cómo los modelos escribían instrucciones en sus propios resúmenes de compactación, así que construye el resumen a partir del estado guardado siempre que puedas y revisa lo que añade el modelo. Y añade casos de seguimiento de estado a tu set de evaluación, con historiales largos, reasignaciones y totales acumulados, porque una buena nota en la aguja en el pajar no te avisará.
Artículos anteriores relacionados
En julio escribimos sobre por qué los agentes olvidan en el segundo mes y sobre la arquitectura de memoria que aguanta el uso real. En octubre medimos cuánto cuesta por tarea una ventana de contexto saturada. Los estudios de esta semana añaden la pieza que faltaba: un contexto largo no solo es caro, también es un mal lugar para llevar la cuenta de los cambios.
Que los modelos frontera no saben seguir el estado. Les fue bien en los dos niveles más sencillos. El hundimiento se produjo en las autoactualizaciones y las referencias, a partir de 10K tokens.
Que StateBench describe tu producto. Usa secuencias sintéticas. Por lo que he leído, el informe no indica qué ajustes de razonamiento usaron los modelos frontera, y el uso de herramientas, como ejecutar código, podría cambiar el resultado. Mide tus propias tareas.
Que la compactación sale gratis. Los autores lo dicen sin rodeos: «Se perderá información como consecuencia de compactar un historial de conversación». Los modelos más débiles sufrieron con presupuestos ajustados. Qwen 3 Coder Next cayó del 53,0% al 3,6% en SWE-bench Verified con el ajuste más estricto.
Que el contexto largo no sirve. El estudio sobre compactación afirma que sus pruebas «no descartan que existan tareas en las que el contexto largo sea beneficioso». Leer una vez un contrato largo es un trabajo distinto de seguir cambios a lo largo de una sesión larga.
Dos estudios publicados el 2 y el 3 de noviembre llegan a la misma conclusión práctica desde direcciones opuestas. StateBench mostró que los modelos frontera manejan bien los valores constantes y las reasignaciones simples, pero caen al nivel del azar al seguir autoactualizaciones y referencias cuando la entrada llega a entre 10K y 64K tokens. «You don't need long context» mostró que compactar el contexto de un agente en un resumen breve perdía poca o ninguna precisión en tareas difíciles de agentes y reducía varias veces el coste estimado.
Para los fundadores, la lección es dónde vive el estado. La ventana de contexto es donde lee el modelo, no donde tu producto debería guardar sus registros.
Esta semana, busca el único punto en el que tu agente deduce el estado actual a partir de un historial largo. Lleva ese estado al código, haz que el modelo proponga cambios como operaciones estructuradas y empieza cada turno con un resumen.
Fuentes: Ai2, anuncio de StateBench (3 de noviembre de 2026): los cuatro niveles de dificultad, los modelos frontera evaluados y la cifra de «13% o menos» en los problemas finitos generales más largos; Jackson Petty, William Merrill y Ashish Sabharwal, A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models, arXiv:2611.03094 (2 de noviembre de 2026): los seis formatos, la evaluación generativa de los modelos frontera, el resultado al nivel del azar entre 10K y 64K tokens y la comparación entre RULER y hoja de cálculo; Peter Belcak et al., You don't need long context, arXiv:2611.05306 (3 de noviembre de 2026): la comparación de costes de servicio de 3,6 a 7 veces, los dos métodos de compactación y lo que contenían los resúmenes eficaces, los cambios de precisión y los ahorros estimados para Claude Opus 4.5 y GPT 5.6 Sol, el resultado de Qwen 3 Coder Next y las limitaciones declaradas. El código de la sección 4 es una ilustración mía, y la interpretación de las secciones 3 a 5 también es mía.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.