
El muro del segundo mes: por qué tu agente de IA olvida, y la arquitectura de memoria que lo resuelve (2026)

By Surya Pratap
27 de julio de 2026
10 min read
AI & Technology

27 de julio de 2026
10 min read
Ahora mismo circula una queja muy concreta en los rincones de Reddit donde se construyen agentes (r/AI_Agents, r/Automation, r/n8n), y siempre llega con el mismo calendario. La demo funcionó. El piloto funcionó. Luego, hacia la sexta u octava semana, con uso real y sesiones de longitud real, el agente empezó a equivocarse de forma sutil. Volvió a preguntar algo que ya le habían respondido. Actuó sobre un dato del cliente que había cambiado hacía dos semanas. Perdió el hilo de una tarea larga y terminó con toda seguridad la tarea equivocada. Los constructores han empezado a llamarlo el muro del segundo mes, y lo frustrante es que nada se rompió. Ningún error, ninguna excepción, ningún despliegue fallido. El agente simplemente fue empeorando en silencio.
El instinto es culpar al modelo y actualizarlo. Eso casi nunca lo arregla, porque no es un fallo del modelo: es un fallo de la arquitectura de memoria. La mayoría de los fallos de agentes en producción son fallos de contexto, y la forma del problema se ha vuelto lo bastante clara en 2026 como para tener nombre, un conjunto de mediciones detrás y una serie de soluciones aburridas en el mejor sentido posible. Esta es una guía para fundadores sobre lo que realmente sale mal, por qué las ventanas de contexto más grandes no salvaron a nadie y cómo debería ser la capa de memoria antes de que tu agente llegue a su segundo mes.
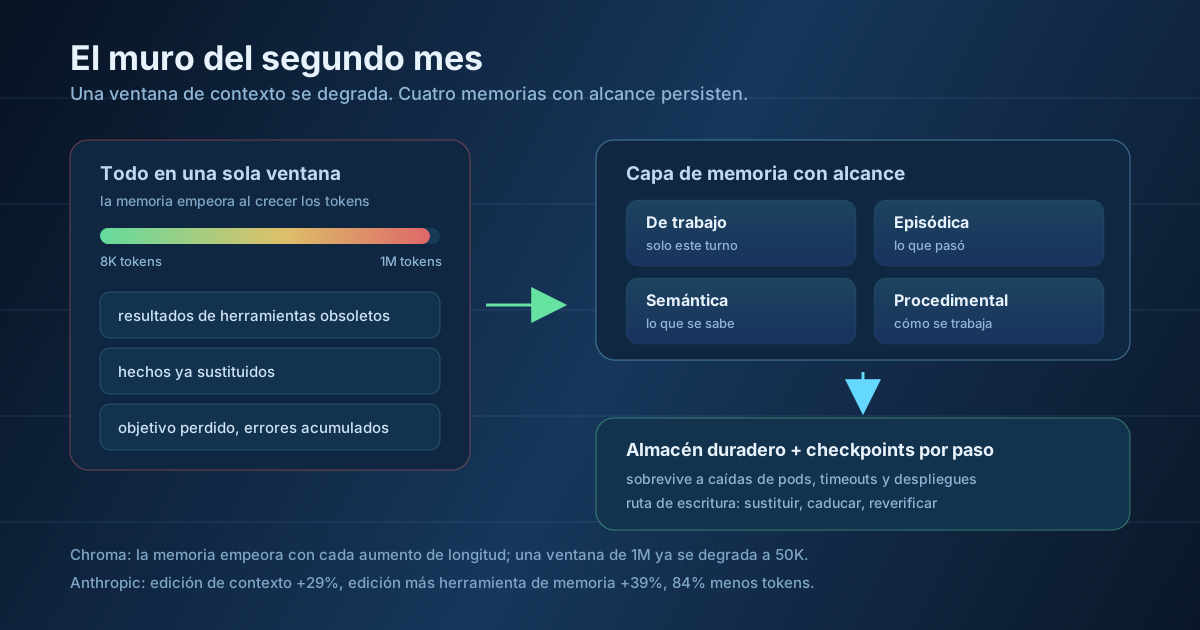
La evidencia más clara viene de la investigación Context Rot de Chroma, que evaluó 18 modelos de frontera, entre ellos GPT-4.1, Claude 4, Gemini 2.5 y Qwen3, con ocho longitudes de entrada en tareas deliberadamente sencillas como la recuperación y la replicación de texto. El resultado es incómodo: los modelos no procesan el contexto de forma uniforme. La capacidad de recordar se degrada con cada incremento de longitud, no solo cerca del límite. Un modelo con una ventana de contexto de un millón de tokens ya muestra una degradación medible a los cincuenta mil tokens.
Hay dos detalles que importan más que el titular. Primero, la degradación se acelera a medida que cae la similitud semántica entre el dato enterrado y la pregunta, de modo que cuanto más difícil es la recuperación, más rápida es la degradación. Segundo, los distractores y la estructura del pajar cambian la curva con independencia de la longitud bruta. Juntos apuntan a la misma conclusión: la relación señal-ruido importa más que la capacidad. Llenar una ventana más grande no es una estrategia; es justo lo que causa el problema.
Por qué el muro aparece precisamente en el segundo mes
Las demos son cortas. Los pilotos son cortos. El uso real es donde las sesiones se alargan, el historial se acumula y los datos aprendidos en la primera semana se quedan obsoletos. El contexto que estaba limpio en el lanzamiento es, en el segundo mes, un gran montón de resultados de herramientas medio relevantes y verdades ya sustituidas, y ese es exactamente el régimen en el que la capacidad de recordar se desmorona.
El cambio de enfoque más útil es entender que la «memoria» no es una sola cosa. Los sistemas de agentes en producción separan al menos cuatro tipos, y la mayoría de los primeros MVP los colapsan todos en una única transcripción de conversación que no para de crecer. La memoria de trabajo es lo que el agente necesita para el paso actual y debería ser desechable sin contemplaciones. La memoria episódica es lo que pasó: el registro de sesiones y resultados anteriores. La memoria semántica es lo que se sabe: datos duraderos sobre un usuario, una cuenta o un dominio. La memoria procedimental es cómo se hace el trabajo: los flujos y patrones aprendidos que deberían sobrevivir a cada sesión.
Tienen vidas útiles completamente distintas, y de eso se trata. La memoria de trabajo debería borrarse constantemente; la semántica debería persistir durante meses pero poder corregirse; la procedimental debería versionarse como el código. Cuando las cuatro viven en una sola ventana de contexto, obtienes la peor política para cada una: nada se borra nunca, nada se actualiza bien nunca, y cada dato compite por la atención con cada resultado de herramienta obsoleto. La degradación del contexto, la deriva de la memoria, los objetivos perdidos y los errores que se acumulan son lo que ese diseño de ventana única produce bajo carga.
Además de los tipos, importa el alcance. Los sistemas de memoria maduros indexan la recuperación por identidad: usuario, agente, sesión o ejecución, y organización. Un dato aprendido sobre un usuario no debería filtrarse a la sesión de otro; un flujo aprendido a nivel de organización debería estar disponible en todas partes. Si tu agente no tiene un modelo de alcance, o bien olvida demasiado o bien recuerda cosas que no le corresponde recordar, y el segundo fallo es un incidente de privacidad esperando a ocurrir.
Lo alentador de 2026 es que las soluciones son medibles, y son de arquitectura, no dependen del modelo. Los resultados publicados por Anthropic sobre sus propias evaluaciones de búsqueda agéntica son el ejemplo más limpio: la edición de contexto, que elimina automáticamente de la ventana las llamadas y los resultados de herramientas obsoletos, aportó una mejora del 29% en tareas complejas de varios pasos. Añadir una herramienta de memoria, con la que el modelo lee y escribe archivos en un directorio de memoria que vive fuera de la ventana de contexto, llevó la mejora combinada al 39%. En una evaluación de búsqueda web de cien turnos, la edición de contexto permitió a los agentes terminar flujos que antes morían por agotamiento del contexto, a la vez que reducía el consumo de tokens en un 84%.
Lee esa combinación con atención, porque es la lección de diseño. La edición por sí sola ayuda porque eleva la relación señal-ruido. La edición más una memoria externa ayuda más porque el agente deja de tener que elegir entre olvidar algo y ahogarse en ello. La reducción del 84% de tokens es la parte que los fundadores deberían mirar dos veces: es uno de los raros casos en que la mejora de fiabilidad y la de coste son el mismo cambio.
Las capas de memoria dedicadas reportan mejoras similares en los benchmarks habituales: puntuaciones entre los noventa bajos y medios en LoCoMo y LongMemEval con unos siete mil tokens por consulta, y saltos de dos dígitos en razonamiento temporal y de varios saltos frente a enfoques anteriores. Pero la cifra honesta es la de la evaluación a gran escala: en BEAM, el rendimiento cae de alrededor de 64 con un millón de tokens de historial a alrededor de 49 con diez millones. Incluso los buenos sistemas de memoria se degradan a medida que crece el historial. La calidad de la recuperación es una limitación real, no un problema resuelto, y cualquier hoja de ruta que dé por hecho que «basta con añadir memoria» se está saltando la mitad difícil.
El primer paso más barato
Antes de evaluar un solo proveedor de memoria, añade edición de contexto: haz caducar los resultados de herramientas en cuanto se haya actuado sobre ellos, y descarta las trazas de razonamiento que ya no informan el siguiente paso. Son unos pocos días de trabajo, no necesita infraestructura nueva y es el cambio con mejor retorno medido por hora invertida.
Casi todas las conversaciones sobre memoria se centran en la recuperación: embeddings, rerankers, búsqueda híbrida. Pero los fallos que describen los constructores en Reddit son abrumadoramente fallos de la ruta de escritura. El agente recordó algo correctamente y luego el mundo cambió. El cliente pasó a otro plan. La política se actualizó. La persona de contacto que aprobaba las cosas se fue. La memoria no se equivoca sobre el pasado; se equivoca sobre el presente, y el sistema no tiene ningún mecanismo para darse cuenta.
Un comentarista de esos hilos lo expresó mejor que la mayoría de la documentación de los proveedores: la fiabilidad a largo plazo necesita una forma de olvidar, sustituir y volver a verificar los datos. Son tres operaciones distintas. Olvidar es un tiempo de vida para memorias que solo eran circunstanciales. Sustituir es escribir un dato nuevo que retira explícitamente uno antiguo en lugar de quedarse a su lado, porque dos memorias contradictorias en un índice de recuperación son un cara o cruz, no una base de conocimiento. Volver a verificar es comprobar de nuevo los datos críticos contra el sistema de origen antes de actuar sobre ellos, en lugar de fiarse de una nota de hace seis semanas.
La obsolescencia de la memoria se reconoce abiertamente como un problema sin resolver incluso por los equipos que construyen infraestructura de memoria, junto con la abstracción temporal y la resolución de identidades. Así que no esperes a que una librería se encargue. Decide, por categoría de dato, cuánto tiempo sigue siendo cierto y qué pasa cuando deja de serlo, y escribe esa política en el sistema y no en un documento de diseño.
La otra mitad del muro del segundo mes no es cognitiva en absoluto: es de infraestructura. Los agentes que funcionan durante horas o días se toparán con timeouts del proveedor, caídas de pods, despliegues programados e interrupciones de red. No son casos extremos; con un horizonte lo bastante largo están garantizados. Si el estado de la sesión vive en la memoria del proceso o en el disco efímero de un pod, cada uno de esos eventos destruye en silencio todo lo que sabía el agente, y el agente reinicia el flujo desde el principio, quemando tokens y a veces repitiendo efectos secundarios que nunca debería repetir.
El patrón que funciona es aburrido y bien conocido: estado en almacenamiento duradero, checkpoints escritos antes de ejecutar cada paso y reanudación en el punto exacto del fallo en lugar de desde el principio. La observación de esas mismas comunidades de constructores es tajante: los agentes que ganan dinero tienen rutas de recuperación duraderas, y los que fallan en producción no. También por eso caló tanto la crítica recurrente en el debate de este verano en X sobre grafos frente a bucles para la orquestación: como señaló el creador de XState, el sector no deja de redescubrir patrones de ingeniería de software de hace décadas con nombres nuevos. Las máquinas de estado duraderas son uno de ellos. Tu agente necesita las mismas garantías de recuperación que ha necesitado cualquier trabajo de larga duración en los últimos treinta años.
Si vas a lanzar un MVP con IA el próximo trimestre, no necesitas un sistema de memoria de nivel de investigación. Necesitas no chocar con el muro. Es un trabajo mucho más pequeño, y consiste sobre todo en tomar cuatro decisiones de forma explícita en lugar de por accidente.
Ese último punto es el que la mayoría de los equipos se salta. Toda la razón por la que el muro del segundo mes es una sorpresa es que nadie hizo pruebas para el segundo mes: el conjunto de evaluación se construyó con tareas limpias, cortas y de primera sesión, así que siguió aprobando mientras la fiabilidad real se deslizaba. Si te quedas con una sola cosa de todo esto, que sea esta: mete en tu batería de pruebas una sesión deliberadamente larga y deliberadamente obsoleta, con un dato que cambió a mitad de camino, y comprueba si tu agente se da cuenta.
Merece la pena nombrar el cambio de fondo. En 2026 los compradores han dejado de impresionarse con las demos de agentes, porque todo el mundo tiene una. Lo que de verdad compran es completar tareas de forma que aguante en la centésima ejecución, y eso lo decide casi por completo una arquitectura que la demo nunca pone a prueba. La memoria es donde se gana esa batalla: no por el modelo que eliges, sino por lo que decides conservar, lo que decides tirar y lo que te aseguras de que sobreviva a un despliegue.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.