
AWS dejó que unos agentes construyeran un emulador de su nube sin revisión humana del código. La revisión se trasladó a los tests

By Surya Pratap
13 de noviembre de 2026
8 min read
AI & Technology

13 de noviembre de 2026
8 min read
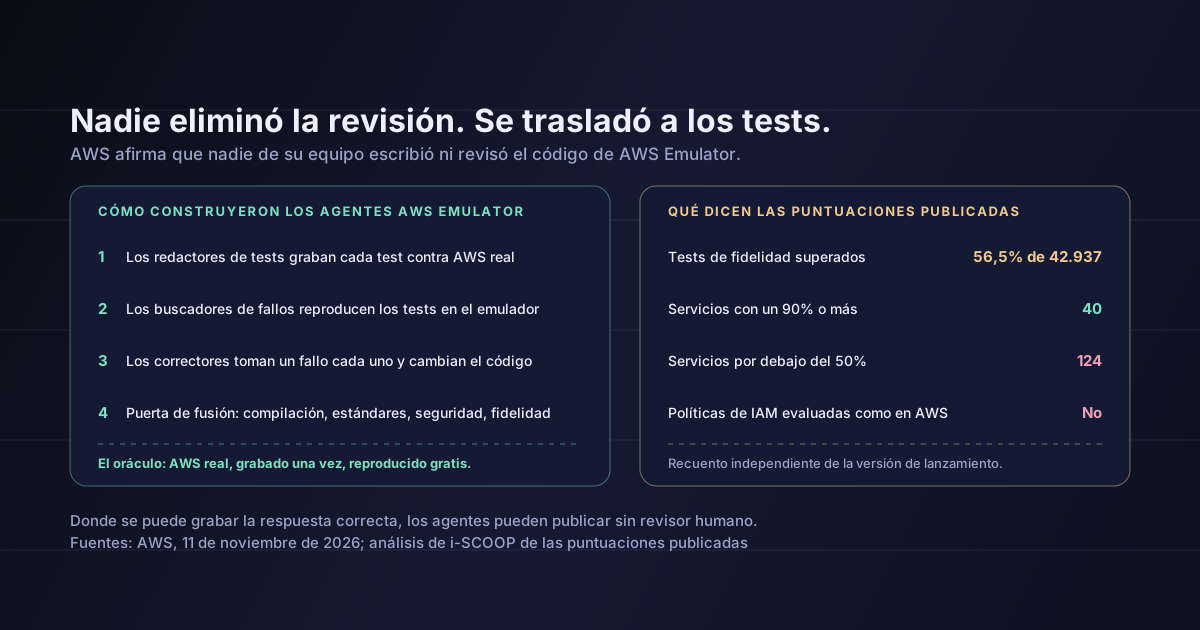 Ver el proceso y las puntuacionesHover to explore
El 11 de noviembre, AWS publicó AWS Emulator, un sustituto local de sus servicios que puedes ejecutar en tu portátil para construir y probar aplicaciones sin llamar a la nube. La herramienta es útil, pero a los fundadores les importa más la afirmación que la acompañó. En palabras de Matthew Goldberg, el ingeniero principal sénior que firmó el anuncio: «El emulador lo escribieron íntegramente agentes autónomos. Nuestro equipo no ha escrito ni revisado nada del código». La mayoría de las startups ha descubierto este año que la revisión humana es el paso más lento en un equipo que trabaja con muchos agentes. AWS ha mostrado una forma de eliminarla, y lo útil son las condiciones que lo hicieron posible.
AWS describe el producto de forma sencilla: «un emulador local de los servicios de AWS que puedes ejecutar en tu máquina para construir y probar tus aplicaciones de AWS». La cobertura añade los detalles:
AWS explica que el emulador «lo construyen fundamentalmente tres equipos de agentes. Un equipo gestiona un conjunto de tests; otro encuentra fallos en el emulador; y otro corrige esos fallos». Una cuarta etapa decide qué se publica.
La escala es grande. AWS dice que «cientos de agentes trabajan simultáneamente en el código» y que ha «visto miles de fallos corregidos cada día». El proyecto empezó como un experimento de fin de semana: un servidor web vacío que aceptaba peticiones para todos los modelos de API «pero no hacía nada», con el conjunto de tests como especificación.
Nadie eliminó la revisión. AWS la trasladó de una persona que lee diffs a un conjunto de tests comprobados contra el sistema real.
El artículo de AWS no da tasas de acierto; promete un artículo posterior sobre cómo se mide la fidelidad. Help Net Security informa de que AWS publica puntuaciones de fidelidad por servicio con cada versión, e i-SCOOP las contó para la versión de lanzamiento. Sus resultados:
Hay que leer esas cifras con la advertencia del propio i-SCOOP: «un test solo se supera si el emulador devuelve exactamente lo que devolvió AWS», y «un test fallido suele significar un mensaje de error equivocado, no un servicio roto». Su resumen es justo: un emulador rápido y gratuito «que acierta en gran medida los caminos habituales de los servicios populares».
Las limitaciones están más claras que las puntuaciones. Help Net Security informa de que el emulador «no evalúa AWS Identity and Access Management (IAM) ni las políticas basadas en recursos como lo hace AWS», lo guarda todo en memoria y debe usarse con una sola región y una sola cuenta. i-SCOOP añade que una petición que AWS denegaría puede tener éxito en local, y al revés.
Una condición hizo la mayor parte del trabajo: AWS tenía un oráculo. Para cualquier petición, AWS real da la respuesta correcta, y esa respuesta se puede grabar una vez y reproducir miles de veces gratis. El cambio de un agente no se juzga por si a un revisor le gusta el diff. Se juzga por si el emulador coincide ahora con el sistema que copia. Es una comprobación más fuerte que la mayoría de las revisiones humanas, y nunca se cansa.
La mayor parte del código de una startup no tiene un oráculo así. Nadie puede grabar la respuesta correcta a «¿es bueno este flujo de onboarding?» o «¿está bien esta página de precios?». Pero muchas partes de un producto sí lo tienen, y esas partes pueden acercarse al modelo de AWS:
import json, pathlib

CASES = pathlib.Path("fidelity_cases")

def record(name: str, request: dict, call_real) -> None:
    """Run once against the real system and save its answer."""
    response = call_real(request)
    CASES.joinpath(f"{name}.json").write_text(
        json.dumps({"request": request, "expected": response}, indent=2))

def replay(call_ours) -> dict:
    """Run every saved case against our code; no calls to the real system."""
    results = {"pass": 0, "fail": []}
    for path in sorted(CASES.glob("*.json")):
        case = json.loads(path.read_text())
        if call_ours(case["request"]) == case["expected"]:
            results["pass"] += 1
        else:
            results["fail"].append(path.stem)
    return results

def gate(before: dict, after: dict) -> bool:
    """Merge only if nothing that passed before fails now."""
    newly_failing = set(after["fail"]) - set(before["fail"])
    return not newly_failing
Encuentra tus oráculos. Haz una lista de las partes de tu código en las que existe una respuesta correcta fuera de él: la API de un proveedor, el sistema antiguo, un conjunto de datos de referencia. Son las partes en las que los agentes pueden trabajar con menos revisión humana.
Graba antes de delegar. Captura primero las respuestas del sistema real, como hicieron los redactores de tests de AWS, y comprueba cada una contra la fuente. Un test que un agente escribe sin comprobarlo contra el sistema real solo confirma lo que el agente ya cree.
Filtra por regresiones, no por gustos. Fusiona solo cuando la compilación pasa, las comprobaciones de estándares y seguridad pasan y nada de lo que pasaba antes falla ahora. Es una regla barata de ejecutar y difícil de discutir.
Publica tu propia puntuación. Sigue la tasa de acierto por área y muéstrasela al equipo. Una cifra que admite un 56,5% es más útil que una promesa de completitud, porque la gente ve dónde puede fiarse del código.
Mantén a las personas donde no hay oráculo: el criterio de producto, los límites de seguridad y todo lo que tenga que ver con permisos. El propio resultado de AWS apunta en esa dirección. La única área que el emulador no intenta igualar, el control de acceso, es justo donde una respuesta equivocada es más peligrosa. En julio defendimos que una startup debería contratar al revisor antes que al programador. AWS Emulator matiza ese consejo: contrata al revisor para las partes sin oráculo y dedica el resto del esfuerzo a construir uno. Para las partes de un producto de IA en las que puedes definir el comportamiento correcto, empieza por un conjunto de evaluación con tareas reales de usuarios.
Si piensas usar AWS Emulator
Trátalo como un ciclo local rápido, no como la prueba de que tu código funciona en AWS. No lo uses para probar el control de acceso, porque las políticas de IAM y de recursos no se evalúan como las evalúa AWS. Usa una sola región y una sola cuenta, cuenta con que el estado desaparece cuando se detiene y consulta la puntuación por servicio de los servicios de los que dependes. i-SCOOP advierte además de que, si tu SDK no apunta al emulador, «llama sin avisar a AWS real con las credenciales que encuentre». Haz las comprobaciones finales en AWS real.
Que no participó ningún humano. Según AWS, ningún humano escribió ni revisó el código. Pero fueron personas quienes eligieron el oráculo, diseñaron los tres equipos, fijaron los estándares de código y construyeron la puerta de fusión. AWS lo atribuye a «las salvaguardas que hemos establecido». El trabajo humano se movió a una fase anterior del proceso; no desapareció.
Que un 56,5% significa que la mitad del emulador está rota. Los tests exigen coincidencias exactas, mensajes de error incluidos. Los caminos habituales de los servicios populares puntúan mucho más alto que la cola larga.
Que tu producto puede hacer lo mismo. AWS tenía un sistema de referencia perfecto y barato de consultar, y presupuesto para ejecutar cientos de agentes. La mayoría de las startups no tienen ninguna de las dos cosas para la mayor parte de su código. Copia el método donde tengas un oráculo, no en todas partes.
Que las cifras son definitivas. El anuncio de AWS habla tanto de «miles» como de «cientos» de agentes, y las tasas de acierto vienen de un recuento externo de una sola versión, no de AWS. Es de esperar que ambas cosas cambien a medida que AWS publique más.
El 11 de noviembre de 2026, AWS publicó AWS Emulator, un emulador local y gratuito de sus servicios, y afirmó que nadie de su equipo había escrito ni revisado el código. Unos agentes escribieron tests comprobados contra AWS real, otros los reprodujeron para encontrar divergencias, un tercer grupo corrigió cada fallo y una puerta de fusión comprobó compilación, estándares, seguridad y fidelidad. Un recuento independiente de las puntuaciones iniciales encontró que se superaba el 56,5% de 42.937 tests de fidelidad, con grandes diferencias entre servicios y sin evaluación de las políticas de IAM.
Para los fundadores, la lección no es que la revisión esté obsoleta. Es que la revisión puede trasladarse a los tests cuando tienes una fuente fiable de respuestas correctas, y debe quedarse en manos de personas cuando no la tienes.
Esta semana, elige una parte de tu código que tenga un oráculo, graba veinte respuestas reales de él y convierte «nada de lo que pasaba falla ahora» en una regla de fusión para los cambios de los agentes en esa parte.
Fuentes: Matthew Goldberg, AWS, AWS Emulator: a local emulator built 100% by autonomous AI agents (11 de noviembre de 2026) — la descripción del producto, los 438 modelos de API, la licencia CC0, los tres equipos de agentes, la puerta de fusión, el número de agentes y de fallos, y la afirmación de que el equipo no había escrito ni revisado el código; Anamarija Pogorelec, Help Net Security, AWS Emulator: Open-source tool for testing AWS apps locally, built by autonomous AI agents (12 de noviembre de 2026) — las cuatro formas de ejecutarlo, las puntuaciones por servicio publicadas con cada versión y las limitaciones de IAM, región, cuenta y memoria; Tom Cuylaerts, i-SCOOP, AWS Emulator was built by AI agents nobody reviewed, and its own test scores show where to trust it (12 de noviembre de 2026) — el recuento de las puntuaciones iniciales, las cifras por servicio, las advertencias sobre las coincidencias exactas, la nota sobre los pull requests y el código de terceros con licencia Apache, y la advertencia sobre los endpoints del SDK. El código de la sección 4 es una ilustración mía, y la interpretación de las secciones 4 y 5 es mía.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.