A Anthropic bloqueou 1 ação de agente em 47.000. O número a copiar é o 100%

By Surya Pratap
19 de setembro de 2026
11 min read
AI & Technology

19 de setembro de 2026
11 min read
 Mil milhões entram, cinquenta saemHover to explore
O artigo de ontem terminava com uma queixa: não podes rever o que não registas. Hoje existe um documento que mostra como é a outra ponta desse argumento quando alguém a construiu a sério, a uma escala que mais ninguém publicou.
Os números deste artigo vêm de «Measurements for understanding the pace of AI development inside frontier labs» da Anthropic, publicado a 17 de setembro de 2026, e da cobertura da Engadget, do Quartz e da FourWeekMBA. Todos os números são a Anthropic a medir-se a si própria, uma ressalva que a própria Anthropic enuncia com clareza e que repito na secção 7. A leitura que faço deles, e tudo o que vem a partir da secção 4, é minha.
A Anthropic publicou três medições da sua própria investigação e desenvolvimento em IA, propostas como algo que os laboratórios de fronteira deveriam reportar por rotina e não como uma divulgação pontual.
Quanto do trabalho de investigação em IA da empresa é liderado pelo Claude, avaliado numa escala de autonomia de AL0 a AL5 originalmente desenvolvida pela Epoch AI.
Quantos agentes internos correm, quanto daquilo que fazem está monitorizado, e o que acontece quando um monitor levanta objeção.
Que fração da computação de I&D em IA foi para trabalho de segurança, medida ao longo de uma única semana.
O título que toda a gente apanhou foi o primeiro: o Claude lidera 26% do trabalho de I&D em IA da Anthropic em agosto de 2026, contra menos de 1% em fevereiro. Esse número anda a ser citado sem a sua segunda metade, que o altera — mais sobre isso na secção 5.
A segunda medição é a que eu levaria mesmo para uma reunião de desenho.
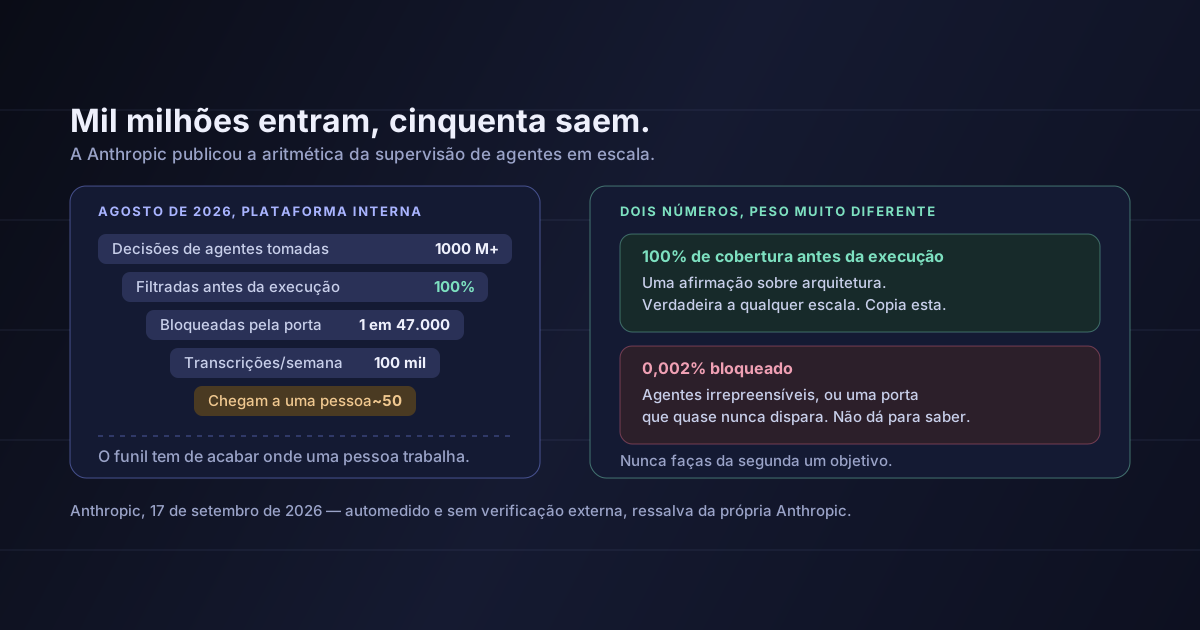
Em agosto de 2026, na plataforma interna principal da Anthropic:
Mil milhões de decisões numa ponta, cinquenta revisões humanas na outra, e um caminho declarado entre as duas.
Seja o que for discutível aqui, aquele funil é um artefacto de engenharia real. É a primeira vez que um laboratório publica a aritmética de como o trabalho automatizado é estreitado até algo a que uma pessoa consegue mesmo dar atenção.
0,002% é o valor que vai acabar em apresentações e, por si só, quase nada informa. A própria Anthropic o diz, por palavras suas: uma taxa tão baixa é compatível com agentes que raramente tentam algo que mereça bloqueio, e igualmente compatível com um monitor que raramente intervém por desenho.
São mundos muito diferentes, e nenhuma taxa de bloqueio os distingue. Um monitor que não bloqueia nada pontua exatamente como uma frota de agentes irrepreensíveis.
Porque é que uma taxa de bloqueio falha como métrica
Leva a lógica aos extremos. Um monitor sem regras bloqueia 0% e parece perfeito. Um monitor que bloqueia tudo bloqueia 100% e parece alarmante, sendo perfeitamente seguro e perfeitamente inútil. A métrica mexe-se por razões que nada têm a ver com o funcionamento da supervisão, o que significa que não pode servir de objetivo — e, assim que alguém a toma por objetivo, deixa de medir até o pouco que media.
Os números que transportam informação são os que falam de cobertura:
«100% das ações passa pelo monitor antes da execução» é uma afirmação sobre arquitetura. É verificável, é falsificável, não oscila com o comportamento do modelo e é a mesma afirmação quer os teus agentes tomem mil milhões de decisões por mês ou quatrocentas. «100% ingerido depois» é o mesmo tipo de afirmação sobre a segunda camada.
Se copiares uma só coisa desta publicação, copia o compromisso de cobertura. Não copies a meta.
Perante um número como 30.000 agentes, o instinto é achar que nada disto se aplica a uma equipa de cinco. A estrutura aplica-se; só as constantes mudam.
| A camada da Anthropic | O que faz | A versão à escala de um MVP |
|---|---|---|
| Monitor em linha, 100% antes da execução | Barato, síncrono, bloqueia antes de a ação aterrar | Uma verificação de política no caminho da chamada de ferramenta: lista branca, validação de argumentos, tetos de gasto e de raio de impacto |
| Ações bloqueadas para revisão humana em uma semana | Latência limitada na via de exceção | Uma fila com dono e uma regra sobre quanto pode envelhecer um item |
| Monitor fora de linha, 100% depois do facto | Lê tudo, sem orçamento de latência, apanha aquilo para que a porta não foi escrita | Uma passagem noturna sobre as transcrições de ontem com um classificador barato |
| ~1–2 marcações por cada mil, ~50 para uma pessoa | Afinado para que a ponta humana seja um número que um humano consiga fazer | Afina o limiar à capacidade de revisão que tens de facto |
A pista de afinação escondida nos números
Trabalha para trás a partir da última coluna, não da primeira. A taxa de marcação fora de linha da Anthropic aterra em cerca de cinquenta itens por semana a chegar a uma pessoa — um número que uma equipa consegue mesmo despachar. O limiar foi quase de certeza escolhido para produzir isso, e não derivado de primeiros princípios para depois se descobrir que era comportável. Define o teu da mesma maneira: decide quantas transcrições uma pessoa lê por semana e põe a fasquia onde produza esse número.
A divisão em duas camadas é a parte que a maioria das equipas pequenas erra. Constroem um único monitor, põem-no em linha, e depois têm de o manter barato e rápido — o que significa que só pode verificar coisas baratas e rápidas de verificar. As camadas em linha e fora de linha existem precisamente porque essas restrições são diferentes. A porta trava o óbvio e o irreversível. A passagem posterior é onde te podes dar ao luxo de ser lento, minucioso e desconfiado.
De volta ao título, porque a forma como está a ser citado importa a quem planeie contratações a partir dele.
Os 26% são a fração de tarefas medidas de I&D em IA que o Claude lidera em AL4, e AL4 define-se como concluir a maior parte de uma tarefa de ponta a ponta a partir de uma instrução de alto nível enquanto uma pessoa supervisiona. AL5 — sem humano no circuito — está em 0%. Mais de 90% das tarefas medidas estão em AL3 ou acima, onde a IA faz grandes blocos de trabalho sob direção humana próxima.
O resumo honesto do índice não é, portanto, «um quarto da investigação está automatizado». É que um quarto da investigação é liderado por um modelo com alguém ainda a ver, e que a categoria sem supervisão está vazia.
E um número de metodologia que merece mais atenção do que os 26%:
As avaliações são produzidas por um modelo juiz, e a Anthropic reporta que o juiz e os avaliadores humanos concordaram exatamente 59% das vezes, ficando a um nível de distância 97% das vezes.
É uma divulgação genuinamente útil, e transpõe-se diretamente para o teu conjunto de avaliação. Um juiz que concorda com uma pessoa três em cada cinco vezes é quase inútil para decidir sobre uma tarefa isolada, e perfeitamente aceitável para seguir um agregado ao longo do tempo — que é exatamente para o que este índice serve. Se usas um modelo para pontuar o teu próprio agente, essa distinção é o jogo todo: os agregados toleram juízes ruidosos, as decisões individuais de passa ou chumba não.
Quatro coisas, pela ordem em que eu as faria, dimensionadas para uma equipa que não tem trinta mil agentes.
Escreve o teu número de cobertura. Não a meta: a fração real de ações do agente que passa por uma verificação antes da execução. Se não for 100%, a diferença é a lista do que o teu agente consegue fazer sem ninguém a olhar.
Separa a porta da auditoria. Uma verificação síncrona no caminho da chamada de ferramenta, barata o bastante para correr sobre tudo. Uma passagem assíncrona sobre as transcrições, lenta o bastante para ser minuciosa. Querer as duas de um só componente é o que produz um monitor que não faz bem nenhuma.
Define o limiar de escalamento a partir da tua capacidade de revisão. Decide primeiro quantas transcrições uma pessoa lê por semana e depois afina o classificador até ser isso o que chega. Uma fila que ninguém esvazia não é supervisão.
Põe um limite de latência na via de exceção. O da Anthropic é uma semana para uma ação bloqueada. O teu pode ser o que conseguires sustentar, mas tem de estar escrito, porque uma fila de revisão sem limite torna-se em silêncio numa lista de recusa que ninguém volta a abrir.
Nada disto exige uma equipa de segurança. Exige decidir que o caminho de monitorização é produto e não um acrescento — e a razão para o decidir agora é que instalar cobertura à posteriori num agente que já tem cinquenta ferramentas é bastante mais difícil do que construí-la com cinco.
Cada um destes números é a Anthropic a medir a Anthropic. Nenhuma parte externa verificou qualquer das avaliações. A Anthropic diz que planeia integrar avaliadores independentes de terceiros com acesso comparável ao das equipas internas de risco; isso é um plano declarado, não um facto existente, e deve ser lido como tal.
Os números de computação para segurança cobrem uma semana. 6% da computação de I&D em IA para segurança, 12% dentro da I&D em IA conduzida por IA, medidos de 13 a 20 de julho de 2026. A Anthropic é explícita: uma única janela de sete dias chega para mostrar que a medição é possível e não chega para mostrar uma tendência. Foi por isso que deixei esses números fora do argumento acima.
O índice de automatização mede um cabaz congelado de tipos de tarefa. Segue o quanto o trabalho conhecido se automatizou, não se estão a aparecer novos tipos de trabalho — que é justamente o que mais provavelmente mexeria no número verdadeiro.
«Monitorizado» não é «compreendido». A Anthropic nota que faz este tipo de monitorização há meses e não há anos, e que é difícil ter a certeza de que o retrato dos comportamentos possíveis esteja completo. Cobertura total das ações não é cobertura total dos modos de falha.
A correspondência da secção 4 é minha. A Anthropic publicou a sua arquitetura, não uma recomendação para equipas de cinco. Que a estrutura se reduza de escala é inferência minha, e as constantes daquela tabela são ilustrativas.
O interessante nesta publicação não é os números serem favoráveis — são, são autodeclarados, e ambas as coisas devem ser descontadas.
O interessante é que um laboratório publicou a forma da supervisão de agentes a uma escala em que essa forma é obrigada a ser real. Mil milhões de decisões não se revêem com boas intenções. Alguma coisa tem de filtrar tudo de forma barata, outra tem de ler tudo devagar, e o funil entre as duas tem de terminar num número que um ser humano consiga mesmo despachar numa quinta-feira à tarde.
Essa estrutura não é um luxo de laboratório de fronteira. É o aspeto que a supervisão toma assim que um agente executa mais ações por dia do que consegues ler, o que na maioria das equipas acontece por volta da terceira semana.
Não te compares com a taxa de bloqueio. Pergunta que fração das ações do teu agente passa por uma verificação antes de acontecer, e sê honesto com a resposta.
Fontes: Anthropic, «Measurements for understanding the pace of AI development inside frontier labs», publicado a 17 de setembro de 2026 — a escala AL0–AL5, os 26% em AL4, os mais de 90% em AL3, os cerca de 30.000 agentes, as afirmações de cobertura de 100% em linha e fora de linha, a taxa de bloqueio de 0,002% e o enquadramento de uma em 47.000, a taxa de marcação de uma a duas por mil, as cerca de 100.000 transcrições por semana e os cerca de 50 escalamentos humanos, o limite de revisão de uma semana, os 6% e 12% de computação para segurança de 13 a 20 de julho de 2026, a concordância de 59% exata e de 97% a um nível, e todas as ressalvas da secção 7 estão tal como aí publicados. A escala AL0–AL5 tem origem na Epoch AI. Engadget e Quartz, 18 de setembro de 2026, para a cobertura e o enquadramento; FourWeekMBA para a data de publicação e uma tabela consolidada dos valores. A correspondência com a arquitetura de equipas pequenas na secção 4, o argumento sobre taxas de bloqueio na secção 3 e a leitura da concordância do juiz na secção 5 são meus. Para o artigo a que este dá seguimento — a entrada do agente que ninguém regista — vê o teu agente escreve o seu próprio contexto. Para a tese de que um trilho de auditoria já não pode vir de o modelo explicar-se a si próprio, vê a monitorabilidade foi no sentido contrário.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.