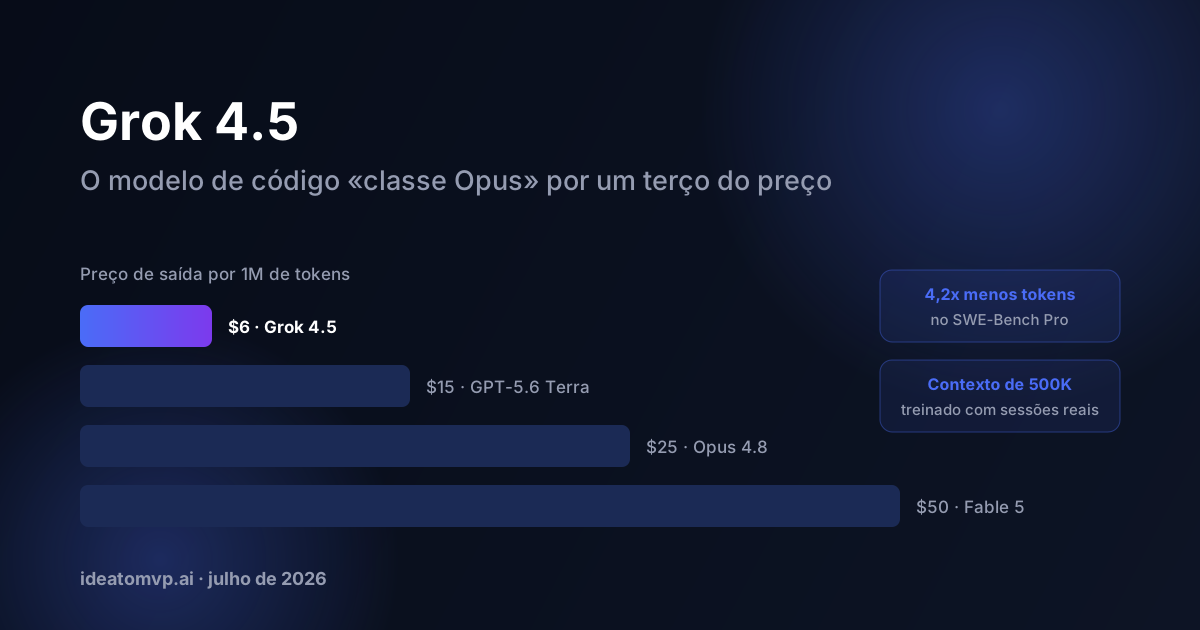
Julho de 2026 vai ficar na memória como o mês em que a guerra dos modelos se transformou numa guerra de preços. Um dia antes de a OpenAI lançar o GPT-5.6, a xAI lançou o Grok 4.5, o seu primeiro modelo treinado especificamente para programação e agentes autónomos, a $2 por milhão de tokens de entrada e $6 por milhão de saída. O posicionamento de Elon Musk foi, como habitualmente, direto: «É um modelo de classe Opus, mas mais rápido, mais eficiente em tokens e mais barato.» Não o modelo mais inteligente do mundo, mas o mais económico entre os que são suficientemente bons para trabalho real de engenharia.
Esse enquadramento, «mais barato e suficientemente bom» como estratégia de destaque e não como desculpa, é novo num laboratório de fronteira, e as reações no X e no LinkedIn durante a semana do lançamento dividiram-se exatamente por essa linha. Eis o que o modelo realmente é, o que dizem os primeiros utilizadores e como um fundador deve pensar nele.
O que o Grok 4.5 realmente é
- Um modelo pensado primeiro para programação e agentes. A xAI treinou-o com dados de sessões reais de developers, graças à parceria com o Cursor: sessões completas dentro de bases de código reais, e não apenas corpora de código estáticos. O objetivo do desenho é um agente que aguenta uma sessão longa sem descarrilar.
- $2 / $6 por milhão de tokens, 500K de contexto. É mais de 60% mais barato do que o Opus 4.8 e o GPT-5.5 a preço de tabela, com a entrada em cache a $0.50.
- Extremamente eficiente em tokens. No SWE-Bench Pro, a xAI indica que o Grok 4.5 resolve as tarefas com uma média de ~16K tokens de saída, contra ~67K do Opus 4.8 em modo máximo: uma diferença de 4,2 vezes. Como os tokens de saída são o que mais paga, a eficiência multiplica o desconto da etiqueta: a Artificial Analysis mediu $0.49 por tarefa concluída, quase 90% mais barato do que os modelos acima dele na sua tabela.
Os benchmarks, lidos com honestidade
O retrato honesto é misto, e por isso mais interessante. No Intelligence Index da Artificial Analysis, o Grok 4.5 obtém 54, quarto lugar na geral, atrás do Fable 5 (60), do Opus 4.8 (56) e do GPT-5.5 (55). Dos quatro benchmarks que a xAI escolheu publicar, bate o Opus 4.8 em dois (DeepSWE 1.0 e Terminal-Bench 2.1) e perde em dois (DeepSWE 1.1 por 6 pontos e SWE-Bench Pro por 4.5).
Por outras palavras: não é o melhor modelo. É um modelo legitimamente próximo da fronteira por uma fração do custo por tarefa, e a xAI não finge o contrário. O próprio Musk apresentou o objetivo como «fechar o ciclo da utilidade no mundo real, não dos benchmarks», citando engenheiros exigentes da Tesla e da SpaceX que o consideram genuinamente útil.
O que se diz no X e no LinkedIn
- Os primeiros utilizadores do Cursor estão impressionados. A análise inicial mais partilhada, do developer Danny Limanseta, descreveu-o como «Opus 4.8 ao dobro da velocidade e a um preço muito mais baixo», depois de uma sessão completa de brainstorming, planeamento e implementação de uma funcionalidade complexa de um jogo, sem correções manuais entre os passos.
- A leitura no LinkedIn é sobre o modelo de negócio. O comentário que mais circulou não falava de capacidade: dizia que um laboratório de fronteira compete agora sobretudo no preço por tarefa concluída, uma métrica que os analistas apresentaram como capaz de abalar a estrutura de margens tanto da Anthropic como da OpenAI.
- Os céticos apontam a escolha dos benchmarks. Publicar os dois benchmarks que se ganham ao lado dos dois que se perdem traz alguma credibilidade, mas críticos no X notaram que «classe Opus» compara com o nível anterior da Anthropic, e não com o Fable 5. Até a comparação do próprio Musk foi com «mais ou menos o Opus 4.7».
O número que importa: custo por tarefa concluída
O preço por token é a etiqueta; o custo por tarefa concluída é a fatura. Um modelo 20% menos capaz, que usa 4 vezes menos tokens e custa 60% menos por token, ganha na economia em cada tarefa que consegue realmente concluir. A pergunta certa nunca é «é mais inteligente?», mas sim «que parte da minha carga de trabalho consegue concluir, e a que custo por tarefa concluída?».
Onde o Grok 4.5 encaixa no stack de uma startup
- O lugar de executor acaba de ganhar um candidato sério. No stack planear → executar → rever que apresentámos na semana passada, o Grok 4.5 cai em cheio no nível de execução, com mais capacidade do que os executores baratos habituais. Para os ciclos de programação agêntica em que o consumo de tokens é o problema, o seu perfil de eficiência é exatamente o que pedia quem gasta $200 por dia.
- As sessões longas são o seu terreno. Treinado com dados reais de sessões completas e com 500K de contexto, foi feito para o padrão «continua a trabalhar nesta base de código durante uma hora», e não para excertos isolados. Teste-o primeiro nos seus fluxos de agentes mais longos.
- Por agora, mantenha o planeamento e a revisão noutro lado. O quarto lugar em inteligência geral é excelente para o preço, mas as decisões de arquitetura e a revisão final continuam a pertencer ao melhor raciocinador que conseguir pagar, e a revisão entre famílias de modelos importa mais, e não menos, à medida que cada laboratório otimiza com mais força para os benchmarks agênticos.
- Aproveite a guerra de preços a três. O Grok 4.5 a 8 de julho, o GPT-5.6 a 9 de julho e a Anthropic a repor limites em menos de uma hora: três laboratórios de fronteira estão a licitar a sua carga de trabalho na mesma semana. Se fixou os preços com o seu fornecedor de IA há mais de um trimestre, está a pagar demais.
Conclusão
O Grok 4.5 é o sinal mais claro até agora de que a fronteira se está a dividir em duas corridas: uma pela inteligência máxima e outra pelo custo mínimo por tarefa concluída. Os fundadores não têm de escolher um lado: um stack bem encaminhado beneficia de ambas. Coloque o Grok 4.5 no seu nível de execução, ponha-o a correr nas suas cargas de trabalho reais durante uma semana e deixe que sejam os números, e não os tweets do lançamento, a decidir que parte da carga de trabalho ele merece.
Quer ajuda para comparar os novos modelos com as cargas de trabalho reais do seu produto? Marque uma chamada de descoberta gratuita: todos os meses construímos e afinamos stacks de encaminhamento de modelos para fundadores.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.