A AMD acabou de comprar um chip que corre um modelo e mais nada (2026)

By Surya Pratap
8 de agosto de 2026
11 min read
AI & Technology

8 de agosto de 2026
11 min read
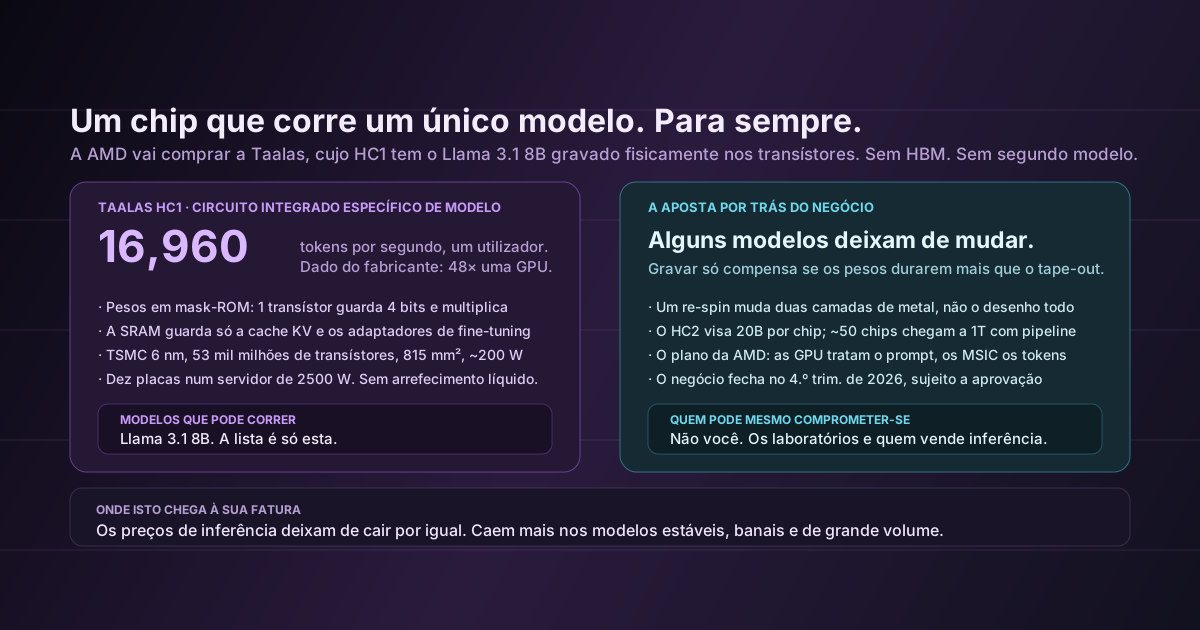
A 6 de agosto, a AMD aceitou comprar a Taalas, uma startup de Toronto com três anos que angariou 219 milhões de dólares para fabricar chips com o modelo incorporado. Não otimizados para ele. Incorporado. O primeiro produto da Taalas, o HC1, corre o Llama 3.1 8B da Meta, e a razão pela qual não consegue correr mais nada é que os pesos estão fisicamente gravados nos transístores.
Anuncia 16 960 tokens por segundo para um único utilizador. É um número publicado pelo fabricante, por isso trate-o como indicativo — mas o múltiplo reivindicado face às GPU atuais é de cerca de 48×, um número suficientemente grande para que, mesmo com um forte desconto, sobre algo interessante.
Ontem escrevi sobre dois agentes de programação lançados com um dia de diferença e com apostas opostas sobre se o harness devia ser portátil. Isto é o mesmo argumento numa camada muito mais baixa do stack, e numa versão muito mais extrema. Há dois anos que todo o tooling de IA otimiza a opcionalidade — gateways, routers, camadas de abstração, trocar de modelo com uma alteração de configuração. A AMD acabou de gastar dinheiro a sério na aposta contrária. Vale a pena perceber porquê, porque diz algo sobre o rumo da curva de custos.
O nome da categoria é circuito integrado específico de modelo — um MSIC, por analogia com o ASIC. O fluxo de desenho pega na matemática, no encaminhamento e nos parâmetros de um modelo treinado e dispõe-nos como lógica fixa.
O chip tem duas regiões. Os pesos vivem numa malha de leitura mask-ROM onde — segundo a descrição do fundador Ljubisa Bajic — um único transístor guarda quatro bits e faz a multiplicação associada. A SRAM trata das partes que têm mesmo de mudar em tempo de execução: a cache KV e os adaptadores de fine-tuning. Não há HBM em lado nenhum, e é esse o objetivo. Numa GPU, a maior parte da energia e da espera vai para mover pesos da memória de alta largura de banda para as unidades de cálculo, uma e outra vez, para cada token. Se os pesos já estão dentro da lógica, esse tráfego não existe.
Os números físicos: TSMC de 6 nm, 53 mil milhões de transístores num die de 815 mm², cerca de 200 watts por placa. Cabem dez placas num servidor x86 de dois sockets dentro de um envelope padrão de 2500 watts, sem arrefecimento líquido. Esse último pormenor passa facilmente despercebido e é, possivelmente, o de maior consequência em todo o anúncio — significa que isto se instala em racks comuns de edifícios comuns, e não nas instalações especializadas, limitadas em energia e com listas de espera de dezoito meses de que os clusters de GPU de fronteira precisam.
O HC2 de segunda geração, previsto para este verão, aponta a 20 mil milhões de parâmetros por chip, com paralelismo de pipeline entre aceleradores para ir mais longe — cerca de 50 chips para chegar a um bilião de parâmetros. A Taalas afirma que gravar um modelo em silício custa cerca de 100× menos do que treinar um modelo de fronteira, o que é uma comparação com um número enorme e deve ler-se como «acessível em relação a um treino», não como «barato».
O plano declarado da AMD não é substituir as suas GPU. É desagregar as duas metades da inferência, que nunca quiseram realmente o mesmo hardware.
Processar o seu prompt — o prefill — está limitado pela computação e é altamente paralelo. Todos os tokens de entrada podem ser trabalhados ao mesmo tempo, que é exatamente aquilo em que uma GPU é boa. Gerar a resposta — o decode — está limitado pela largura de banda de memória e é teimosamente sequencial: um token de cada vez, cada um a exigir que o conjunto completo de pesos seja lido de novo. As GPU são ineficientes nisto e sempre foram. No plano da AMD, as GPU Instinct tratam do prompt, os aceleradores da Taalas geram os tokens, e tudo encaixa na sua plataforma à escala de rack Helios, ao lado do EPYC e do ROCm. A alternativa que apresenta é um ciclo tick-tock: os clientes validam um modelo em GPU Instinct e depois passam a carga já estabilizada para um MSIC.
Há também uma leitura puramente competitiva. O fosso da NVIDIA é em grande parte um fosso de memória e de interligação. Um desenho que contorna completamente a HBM é um dos poucos ataques possíveis que não passam por superar a NVIDIA no seu próprio terreno. O negócio fecha no quarto trimestre de 2026, sujeito a aprovação regulatória, por isso nada disto é iminente.
Esta é a parte em que vale a pena parar. Gravar um modelo em silício só faz sentido económico se os pesos durarem mais do que o tape-out. A AMD está a pagar pela tese de que alguns modelos vão deixar de mudar.
Isso vai diretamente contra a narrativa dominante, incluindo a que tenho contado neste blog — que os modelos saem todos os meses, que qualquer decisão de encaminhamento fica errada num trimestre, que se deve construir para que responder a um lançamento novo seja barato. Tudo isso continua a ser verdade na fronteira. Mas a fronteira não é onde está o volume de tokens.
Pense em onde a inferência é realmente gasta num produto maduro: classificação, extração, reranking, pipelines de embeddings, decisões de encaminhamento, verificações de guardrails, os passos intermédios de um ciclo de agente que nenhum humano lê. Esse trabalho não precisa do modelo de fronteira deste trimestre. Precisa de um 8B competente que se comporte amanhã como hoje. As equipas fixam esses modelos de propósito, porque trocá-los obriga a revalidar tudo a jusante. O Llama 3.1 8B ser o primeiro alvo do HC1 não é por acaso — é um cavalo de batalha estável há tempo suficiente para acumular uma base instalada enorme, aborrecida e de grande volume.
Duas coisas que parecem contraditórias e não são
A rotação de modelos está a acelerar e uma grande parte dos tokens de produção está a consolidar-se num pequeno número de cavalos de batalha congelados. Ambas são verdade porque descrevem camadas diferentes. A fronteira mexe-se depressa porque é onde está a concorrência; a base assenta porque revalidar um modelo fixado em todo um sistema de produção é caro e ninguém o faz por gosto.
Um chip preso a um modelo num mercado que lança modelos novos todos os meses parece uma forma cara de ficar obsoleto. Há três coisas que atenuam isto, e uma que não.
Nunca vai comprar um destes. Vai alugar as consequências, e as consequências são mais concretas do que «a inferência fica mais barata».
Todos os números deste artigo foram publicados pelo fabricante, uma empresa que ainda não lançou o seu segundo produto, num negócio que ainda não fechou. Os roadmaps de silício derrapam, as alegações de desempenho encolhem com testes independentes, e as aquisições são absorvidas em linhas de produto e desaparecem sem ruído. Segure os pormenores sem apertar.
Segure a direção com mais firmeza. Durante três anos, todo o stack de IA foi mole — tudo era uma alteração de configuração, tudo era substituível, a opcionalidade preservada em cada camada porque ninguém sabia o que ia importar. O endurecimento começa quando as respostas deixam de mudar. Uma empresa que grava pesos em ROM está a afirmar que partes disto já são conhecidas o suficiente para se comprometer fisicamente com elas, e uma empresa do tamanho da AMD concordar é a verdadeira notícia, mais do que qualquer número de débito.
Para um fundador, o movimento útil não é escolher um lado. É saber que partes do seu próprio sistema são de que tipo. O que ainda vai estar a correr daqui a dois anos — o seu conjunto de avaliação, a sua lógica de recuperação, o modelo cavalo de batalha que faz os 90% pouco glamorosos dos seus tokens — merece ser tratado como infraestrutura e otimizado a fundo. A chamada ao modelo de fronteira que faz esta semana merece ficar atrás de um gateway onde mudá-la custa uma tarde. A maioria das equipas tem isto exatamente ao contrário: obcecam com a escolha de modelo que vai ficar obsoleta num trimestre e improvisam as partes que lhe vão sobreviver.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.