Schrijven naar de 12-uurscache van OpenAI kost 2,5×. Op papier verdien je het terug vanaf het derde verzoek

By Surya Pratap
21 oktober 2026
8 min read
AI & Technology

21 oktober 2026
8 min read
 Drie keer gebruiken om quitte te spelenHover to explore
Prompt caching is een van de weinige knoppen waarmee je de rekening van een AI-product verlaagt zonder aan kwaliteit te raken. De nieuwe optie van OpenAI laat de cache veel langer meegaan, tegen een hogere prijs voor het schrijven ernaar. Of je er geld mee bespaart, hangt af van iets wat de meeste teams nooit hebben gemeten: hoe lang de gaten zijn tussen verzoeken die dezelfde prompt delen.
Dit artikel is gebaseerd op de gids voor prompt caching en de changelog van OpenAI, en op berichtgeving van Runtime Wire. De prijzen zijn de vermenigvuldigers die OpenAI publiceert voor GPT-5.6 en later. De break-evencijfers in sectie 3 en 4 zijn mijn eigen berekeningen op basis van die vermenigvuldigers, met de vereenvoudigde aannames die daar staan, en komen niet van OpenAI.
Op 20 oktober 2026 liet OpenAI ontwikkelaars kiezen voor een promptcache van 12 uur in de Responses API, naast de bestaande standaardcache van 30 minuten. OpenAI richt zich daarmee op agents die blijven draaien: "Persistente agents, zoals dots, hergebruiken context de hele dag door," schreef het ontwikkelaarsaccount.
Op GPT-5.6 en later stel je hem in met prompt_cache_options.ttl op "12h" in plaats van de standaardwaarde "30m". Beide zijn minimale levensduren.
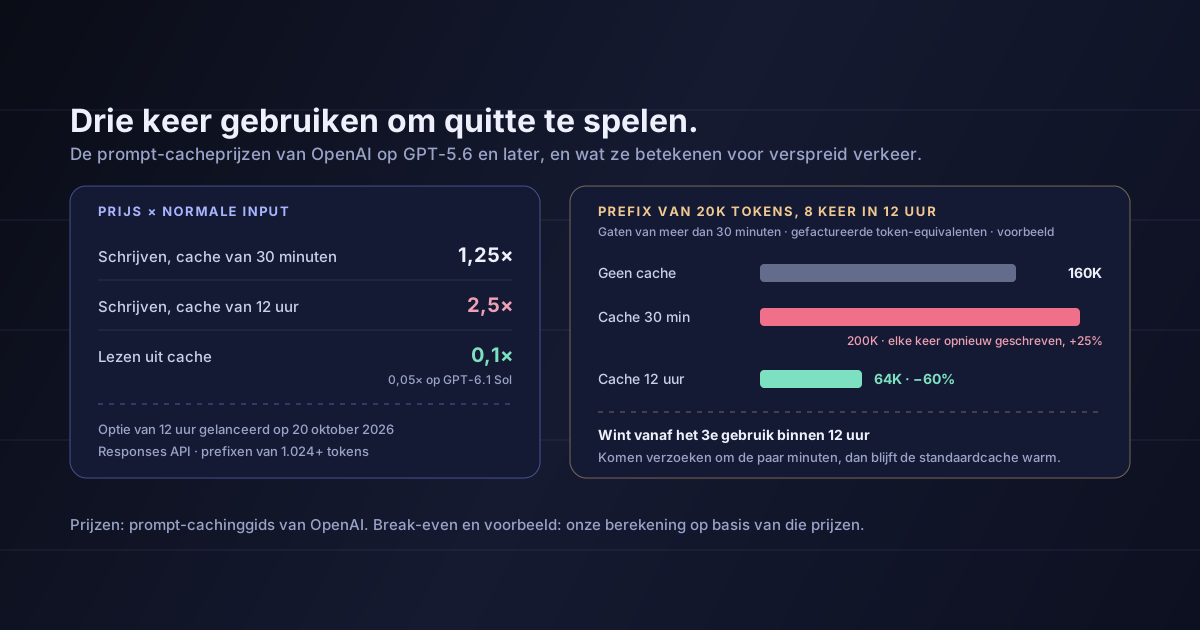
Voor GPT-5.6 en later, als veelvoud van de normale (niet-gecachete) prijs voor inputtokens:
| Prijs | |
|---|---|
| Schrijven, cache van 30 minuten | 1,25× |
| Schrijven, cache van 12 uur | 2,5× |
| Lezen uit cache | 0,1× (0,05× op GPT-6.1 Sol) |
Drie andere regels zijn belangrijk:
prompt_cache_key houd je caches gescheiden per klant of gebruiker.Op oudere modellen zijn er geen extra kosten voor schrijven naar de cache, en de bewaaropties zijn anders.
Neem een prefix — systeemprompt, tooldefinities, naslagmateriaal — met omvang P, die N keer binnen 12 uur wordt hergebruikt. Laat outputtokens en het deel van elke prompt dat verandert buiten beschouwing; die kosten in alle gevallen hetzelfde.
Reken je uit wanneer de 12-uurscache goedkoper is dan geen cache, dan kom je op N > 2,7. Tegenover een cache van 30 minuten die steeds verloopt, op N > 2,1. Met andere woorden: onder deze vereenvoudigde aannames wint de 12-uurscache vanaf het derde gebruik van dezelfde prefix binnen 12 uur — zolang de gaten lang genoeg zijn dat de standaardcache al zou zijn verlopen.
Komen verzoeken om de paar minuten, dan wordt de standaardcache nooit koud, en kost de 12-uursoptie gewoon 1,25 × P extra per venster, voor niets.
Een langere cache bespaart alleen geld als de gaten tussen je verzoeken langer zijn dan de standaardcache duurt.
Een denkbeeldige supportagent heeft een prefix van 20.000 tokens: instructies, toolschema's en een producthandleiding. Een klant gebruikt hem 8 keer op een werkdag, ongeveer eens per één à twee uur. Gefactureerde input voor de prefix, in token-equivalenten:
Dat is 60% minder dan zonder cache op de prefix — en het laat iets minder voor de hand liggends zien: bij verspreid verkeer als dit kan de standaardcache 25% meer kosten dan helemaal geen cache, omdat je de toeslag voor schrijven betaalt zonder ooit te lezen.
Heeft elke klant eigen naslagmateriaal in de prefix, dan heeft elke klant ook een eigen schrijfactie nodig. De besparing geldt dan nog steeds per klant, maar alleen voor klanten die drie keer of vaker binnen het venster terugkomen.
Waarschijnlijk wel baat. Assistenten en agents die per klant een paar keer per dag worden gebruikt, met lange, stabiele instructies of documenten: interne copilots, accountassistenten, geplande agents die elke één à twee uur wakker worden, B2B-tools die op een werkdag met tussenpozen worden gebruikt.
Waarschijnlijk geen baat. Drukbezochte functies waarbij dezelfde prefix om de paar minuten wordt geraakt — de standaardcache blijft dan al warm. Evenmin eenmalige verzoeken, prompts van minder dan 1.024 tokens en prompts waarvan het begin bij elke aanroep verandert.
Repareer eerst de prefix. Zet alles wat stabiel is vooraan — instructies, tooldefinities, naslagmateriaal — en alles wat verandert achteraan. Een tijdstempel in de eerste regel van de systeemprompt maakt elke cacheduur ongemerkt waardeloos.
Meet voordat je overstapt. Log per prefix hoe vaak die wordt hergebruikt en hoe groot de gaten ertussen zijn, en bekijk de aantallen gecachete tokens die de API teruggeeft. Zet de 12 uur alleen aan voor prefixen die echt in dat patroon passen, niet voor alles.
Check wat je standaardcache je kost
Ben je overgestapt op GPT-5.6 of later en is je verkeer per prefix verspreid, kijk dan nu naar je rekening. De schrijfprijs van 1,25× op de standaardcache valt makkelijk weg, en bij verzoeken die meer dan 30 minuten uit elkaar liggen, is het pure overhead. Die kosten betaal je misschien al, nog voordat je iets beslist over 12 uur.
Lange, herhaalde context is de grootste verborgen kostenpost van producten met agents, zoals we zagen toen één refactor 14,29 dollar aan tokens kostte. Cachen is de goedkoopste oplossing — maar alleen als het past bij hoe je gebruikers zich echt gedragen.
Dat de 12-uurscache altijd 12 uur meegaat, of dat lezen uit de cache gegarandeerd is. OpenAI beschrijft beide levensduren als minimum, en een cache kan toch missen. De echte besparing valt wat lager uit dan de rekensom.
Dat de break-evencijfers van OpenAI komen. Het zijn mijn berekeningen op basis van gepubliceerde vermenigvuldigers, uitgaande van identieke prefixen en zonder rekening te houden met gedeeltelijke matches.
Dat deze prijzen voor elk model gelden. Ze gelden voor GPT-5.6 en later; oudere modellen hebben geen schrijftoeslag en andere bewaaropties, en GPT-6.1 Sol leest tegen 0,05×.
Dat cachen zonder controle geschikt is voor gevoelige data. OpenAI vermeldt dat gecachete data in lokale GPU-opslag kan worden bewaard. Heb je afspraken over databewaring, check dan hoe cachen daarin past voordat je de cache verlengt.
OpenAI biedt nu een promptcache van 12 uur in de Responses API. Op GPT-5.6 en later kost schrijven ernaar 2,5× de inputprijs, tegen 1,25× voor de standaardcache van 30 minuten, en lezen kost 0,1×. Volgens een vereenvoudigde rekensom verslaat de 12-uurscache zowel geen cache als een verlopende cache van 30 minuten vanaf het derde hergebruik van dezelfde prefix binnen 12 uur — maar alleen als verzoeken meer dan 30 minuten uit elkaar liggen. Bij frequent verkeer voegt hij kosten toe, en bij verspreid verkeer kost de standaardcache misschien nu al meer dan geen cache.
De beslissing gaat niet over de functie. Die gaat over je verkeerspatroon.
Log deze week hoe vaak elke lange prefix wordt hergebruikt en hoe groot de gaten ertussen zijn. Zet stabiele content vooraan in je prompts. Zet daarna de 12 uur alleen aan voor de prefixen die drie keer of vaker per dag terugkomen met lange gaten.
Bronnen: OpenAI, gids voor prompt caching — de standaardcache van 30 minuten en de 12-uursoptie, de parameter prompt_cache_options.ttl op GPT-5.6 en later, de schrijfprijzen van 1,25× en 2,5× en de leesprijs van 0,1× (0,05× op GPT-6.1 Sol), het minimum van 1.024 tokens, prefixmatching, prompt_cache_key, het ontbreken van een schrijftoeslag op oudere modellen en de opmerking over lokale GPU-opslag. OpenAI, API-changelog — de lancering op 20 oktober 2026. Runtime Wire — de reikwijdte van de Responses API, persistente agents als beoogd gebruik en het citaat van OpenAI Developers over dots. De break-evenberekeningen en het voorbeeld van de supportagent zijn van mij, op basis van de aannames in sectie 3 en 4.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.