Anthropic blokkeerde 1 agentactie op 47.000. Het getal om te kopiëren is 100%

By Surya Pratap
19 september 2026
11 min read
AI & Technology

19 september 2026
11 min read
 Een miljard erin, vijftig eruitHover to explore
Het artikel van gisteren eindigde met een klacht: je kunt niet nakijken wat je niet logt. Vandaag is er een document dat laat zien hoe het andere uiteinde van dat argument eruitziet wanneer iemand het echt heeft gebouwd, op een schaal die niemand anders heeft gepubliceerd.
De cijfers in dit artikel komen uit Anthropic's "Measurements for understanding the pace of AI development inside frontier labs", gepubliceerd op 17 september 2026, en uit de berichtgeving van Engadget, Quartz en FourWeekMBA. Elk getal is Anthropic dat zichzelf meet, een voorbehoud dat Anthropic zelf onomwonden maakt en dat ik in paragraaf 7 herhaal. De lezing ervan, en alles vanaf paragraaf 4, is van mij.
Anthropic publiceerde drie metingen van zijn eigen AI-onderzoek en -ontwikkeling, voorgesteld als iets wat frontier labs routinematig zouden moeten rapporteren en niet als een eenmalige openbaarmaking.
Hoeveel van het AI-onderzoekswerk van het bedrijf door Claude wordt geleid, beoordeeld tegen een autonomieschaal van AL0 tot AL5 die oorspronkelijk door Epoch AI is ontwikkeld.
Hoeveel interne agents draaien, hoeveel van wat ze doen wordt gemonitord, en wat er gebeurt wanneer een monitor bezwaar maakt.
Welk deel van de AI-R&D-compute naar veiligheidswerk ging, gemeten over één enkele week.
De kop die iedereen oppikte was de eerste: Claude leidt 26% van het AI-R&D-werk van Anthropic per augustus 2026, tegen minder dan 1% in februari. Dat getal wordt geciteerd zonder de tweede helft, die het verandert — daarover meer in paragraaf 5.
De tweede meting is degene die ik daadwerkelijk mee zou nemen naar een ontwerpoverleg.
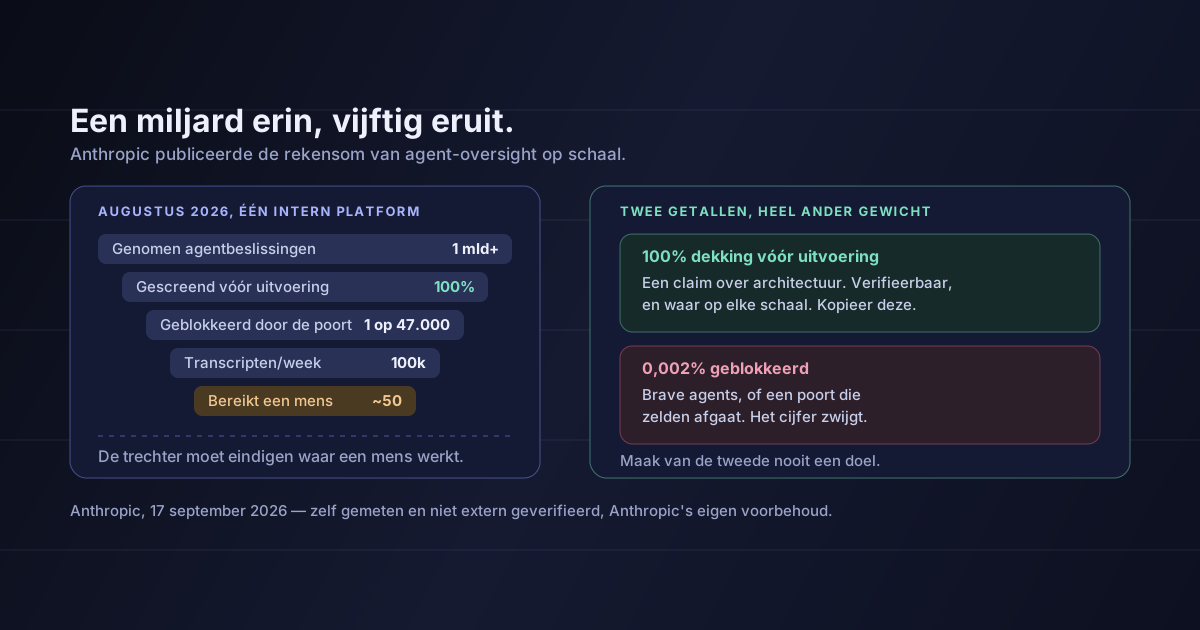
Per augustus 2026, op het belangrijkste interne platform van Anthropic:
Een miljard beslissingen aan het ene eind, vijftig menselijke reviews aan het andere, en een uitgesproken pad daartussen.
Wat er verder ook betwistbaar is, die trechter is een echt stuk engineering. Het is de eerste keer dat een lab de rekensom publiceert waarmee geautomatiseerd werk wordt versmald tot iets waar een mens werkelijk aandacht aan kan geven.
0,002% is het cijfer dat in presentaties belandt, en op zichzelf zegt het bijna niets. Anthropic zegt dat zelf, met zoveel woorden: zo'n laag percentage past bij agents die zelden iets proberen wat blokkeren rechtvaardigt, en even goed bij een monitor die per ontwerp zelden ingrijpt.
Dat zijn heel verschillende werelden, en geen enkel blokkeerpercentage kan ze uit elkaar houden. Een monitor die niets blokkeert scoort precies hetzelfde als een vloot onberispelijke agents.
Waarom een blokkeerpercentage faalt als metric
Trek de logica door naar de uitersten. Een monitor zonder regels blokkeert 0% en lijkt perfect. Een monitor die alles blokkeert komt op 100% en oogt alarmerend terwijl hij volmaakt veilig en volmaakt nutteloos is. De metric beweegt om redenen die niets te maken hebben met de vraag of het toezicht werkt, wat betekent dat hij niet als doel kan dienen — en zodra iemand hem tot doel maakt, meet hij zelfs het weinige niet meer dat hij mat.
De cijfers die wél informatie dragen, gaan over dekking:
"100% van de acties gaat vóór uitvoering langs de monitor" is een uitspraak over architectuur. Die is verifieerbaar, die is falsifieerbaar, die verschuift niet mee met modelgedrag, en het is dezelfde claim of je agents nu een miljard beslissingen per maand nemen of vierhonderd. "100% achteraf ingelezen" is hetzelfde soort claim over de tweede laag.
Als je één ding uit deze publicatie kopieert, kopieer dan de dekkingstoezegging. Kopieer niet het streefgetal.
Bij een getal als 30.000 agents is de reflex dat dit allemaal niet geldt voor een team van vijf. De structuur geldt wel; alleen de constanten veranderen.
| De laag van Anthropic | Wat die doet | De versie op MVP-schaal |
|---|---|---|
| Online monitor, 100% vóór uitvoering | Goedkoop, synchroon, blokkeert voordat de actie landt | Een policy-check in het pad van de tool call: allowlist, argumentvalidatie, plafonds voor uitgaven en impactradius |
| Geblokkeerde acties binnen een week naar menselijke review | Begrensde latency op het uitzonderingspad | Een wachtrij met een eigenaar en een regel over hoe oud een item mag worden |
| Offline monitor, 100% achteraf | Leest alles, geen latency-budget, vangt waar de poort niet voor geschreven is | Een nachtelijke pass over de transcripten van gisteren met een goedkope classifier |
| ~1–2 markeringen per duizend, ~50 naar een mens | Afgesteld zodat het menselijke eind een getal is dat een mens aankan | Stel de drempel af op de reviewcapaciteit die je werkelijk hebt |
Het afsteltrucje dat in de cijfers verstopt zit
Werk terug vanaf de laatste kolom, niet vanaf de eerste. Het offline markeerpercentage van Anthropic komt uit op zo'n vijftig items per week die een persoon bereiken — een getal dat één team echt kan wegwerken. De drempel is vrijwel zeker gekozen om dat op te leveren, en niet afgeleid uit eerste principes om daarna te ontdekken dat het behapbaar was. Stel die van jou net zo in: bepaal hoeveel transcripten een mens per week leest en leg de lat waar dat aantal uitkomt.
De splitsing in twee lagen is het deel dat de meeste kleine teams verkeerd doen. Ze bouwen één monitor, zetten die inline, en moeten hem dan goedkoop en snel houden — waardoor hij alleen dingen kan controleren die goedkoop en snel te controleren zijn. De online en offline lagen bestaan juist omdat die randvoorwaarden verschillen. De poort stopt het overduidelijke en het onomkeerbare. De pass achteraf is waar je je traag, grondig en wantrouwig kunt veroorloven te zijn.
Terug naar de kop, want hoe die geciteerd wordt doet ertoe voor wie er personeelsplanning op baseert.
De 26% is het aandeel gemeten AI-R&D-taken dat Claude leidt op AL4, en AL4 is gedefinieerd als het grootste deel van een taak end-to-end afronden vanuit een prompt op hoofdlijnen terwijl een mens toezicht houdt. AL5 — geen mens in de loop — staat op 0%. Meer dan 90% van de gemeten taken zit op AL3 of hoger, waar AI grote brokken werk doet onder nauwe menselijke aansturing.
De eerlijke samenvatting van de index is dus niet "een kwart van het onderzoek is geautomatiseerd". Het is dat een kwart van het onderzoek wordt geleid door een model met iemand die nog meekijkt, en dat de categorie zonder toezicht leeg is.
En één methodologiecijfer dat meer aandacht verdient dan die 26%:
De beoordelingen worden gemaakt door een modeljury, en Anthropic meldt dat de jury en menselijke beoordelaars het precies 59% van de tijd eens waren, en 97% van de tijd binnen één niveau van elkaar zaten.
Dat is een oprecht nuttige openbaarmaking, en ze is rechtstreeks over te zetten naar jouw evaluatieset. Een jury die het drie op de vijf keer met een mens eens is, is vrijwel onbruikbaar om één losse taak te beoordelen, en prima bruikbaar om een totaal over de tijd te volgen — precies waar deze index voor dient. Als je een model gebruikt om je eigen agent te scoren, is dat onderscheid de hele kern: totalen verdragen ruizige jury's, individuele beslissingen over slagen of zakken niet.
Vier dingen, in de volgorde waarin ik ze zou doen, op maat van een team dat geen dertigduizend agents heeft.
Schrijf je dekkingscijfer op. Niet het streefgetal — het werkelijke deel van de agentacties dat vóór uitvoering langs een controle gaat. Is het geen 100%, dan is het gat de lijst met dingen die je agent kan doen zonder dat iemand kijkt.
Scheid de poort van de audit. Eén synchrone controle in het pad van de tool call, goedkoop genoeg om op alles te draaien. Eén asynchrone pass over de transcripten, traag genoeg om grondig te zijn. Beide uit één component willen halen is precies wat een monitor oplevert die geen van beide goed doet.
Bepaal de escalatiedrempel vanuit je reviewcapaciteit. Bepaal eerst hoeveel transcripten een mens per week leest, stel dan de classifier bij tot dat is wat er binnenkomt. Een wachtrij die niemand leegmaakt is geen toezicht.
Zet een latency-grens op het uitzonderingspad. Die van Anthropic is één week voor een geblokkeerde actie. De jouwe mag zijn wat je kunt volhouden, maar ze moet opgeschreven staan, want een onbegrensde reviewwachtrij wordt stilletjes een denylist die niemand nog opnieuw bekijkt.
Niets hiervan vraagt om een veiligheidsteam. Het vraagt om de beslissing dat het monitoringpad product is en geen bijzaak — en de reden om dat nu te beslissen, is dat dekking achteraf inbouwen in een agent die al vijftig tools heeft aanzienlijk lastiger is dan haar bouwen bij vijf.
Elk van deze getallen is Anthropic dat Anthropic meet. Geen externe partij heeft ook maar één beoordeling geverifieerd. Anthropic zegt onafhankelijke derde beoordelaars te willen inbedden met toegang vergelijkbaar met die van interne risicoteams; dat is een uitgesproken plan, geen bestaand feit, en zo hoort het gelezen te worden.
De cijfers over veiligheidscompute beslaan één week. 6% van de AI-R&D-compute naar veiligheid, 12% binnen de door AI aangedreven AI-R&D, gemeten van 13 tot 20 juli 2026. Anthropic is expliciet dat één venster van zeven dagen genoeg is om te tonen dat de meting kan worden gedaan en niet genoeg om een trend te tonen. Daarom heb ik die cijfers buiten het betoog hierboven gelaten.
De automatiseringsindex meet een bevroren mandje met soorten taken. Hij volgt hoe geautomatiseerd bekend werk is geworden, niet of er nieuwe soorten werk verschijnen — en dat is juist wat het echte getal het sterkst zou verschuiven.
"Gemonitord" is niet "begrepen". Anthropic merkt op dat het dit soort monitoring maanden en geen jaren doet, en dat het moeilijk is zeker te weten of het beeld van mogelijke agentgedragingen compleet is. Volledige dekking van acties is geen volledige dekking van faalwijzen.
De vertaling in paragraaf 4 is van mij. Anthropic publiceerde zijn architectuur, geen aanbeveling voor teams van vijf. Dat de structuur omlaag schaalt is mijn gevolgtrekking, en de constanten in die tabel zijn illustratief.
Het interessante aan deze publicatie is niet dat de cijfers vleiend zijn — dat zijn ze, ze zijn zelf gerapporteerd, en beide horen te worden afgewaardeerd.
Het interessante is dat een lab de vorm van agent-oversight publiceerde op een schaal waar die vorm wel echt moet zijn. Een miljard beslissingen laat zich niet nakijken met goede bedoelingen. Iets moet alles goedkoop screenen, iets anders moet alles langzaam lezen, en de trechter daartussen moet uitkomen op een getal dat een mens op een donderdagmiddag echt kan doorwerken.
Die structuur is geen luxe voor frontier labs. Zo ziet toezicht eruit zodra een agent meer acties per dag doet dan jij kunt lezen, en bij de meeste teams gebeurt dat rond week drie.
Meet jezelf niet af aan het blokkeerpercentage. Vraag welk deel van de acties van je agent langs een controle gaat voordat ze plaatsvinden, en wees eerlijk over het antwoord.
Bronnen: Anthropic, "Measurements for understanding the pace of AI development inside frontier labs", gepubliceerd op 17 september 2026 — de AL0–AL5-schaal, de 26% op AL4, de meer dan 90% op AL3, de circa 30.000 agents, de claims van 100% online en offline dekking, het blokkeerpercentage van 0,002% en de framing als één op 47.000, het offline markeerpercentage van één tot twee per duizend, de circa 100.000 transcripten per week en de circa 50 menselijke escalaties, de reviewgrens van één week, de 6% en 12% veiligheidscompute van 13 tot 20 juli 2026, de 59% exacte en 97% binnen-één-niveau overeenstemming, en alle voorbehouden in paragraaf 7 zijn zoals daar gepubliceerd. De AL0–AL5-schaal komt van Epoch AI. Engadget en Quartz, 18 september 2026, voor de berichtgeving en de framing; FourWeekMBA voor de publicatiedatum en een samengevatte tabel met de cijfers. De vertaalslag naar kleine teams in paragraaf 4, het argument over blokkeerpercentages in paragraaf 3 en de lezing van de jury-overeenstemming in paragraaf 5 zijn van mij. Voor het artikel waar dit op volgt — de agent-input die niemand logt — zie je agent schrijft zijn eigen context. Voor het betoog dat een audit trail niet langer kan komen van het model dat zichzelf uitlegt, zie monitorbaarheid ging de andere kant op.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.