AMD kocht net een chip die één model draait en verder niets (2026)

By Surya Pratap
8 augustus 2026
11 min read
AI & Technology

8 augustus 2026
11 min read
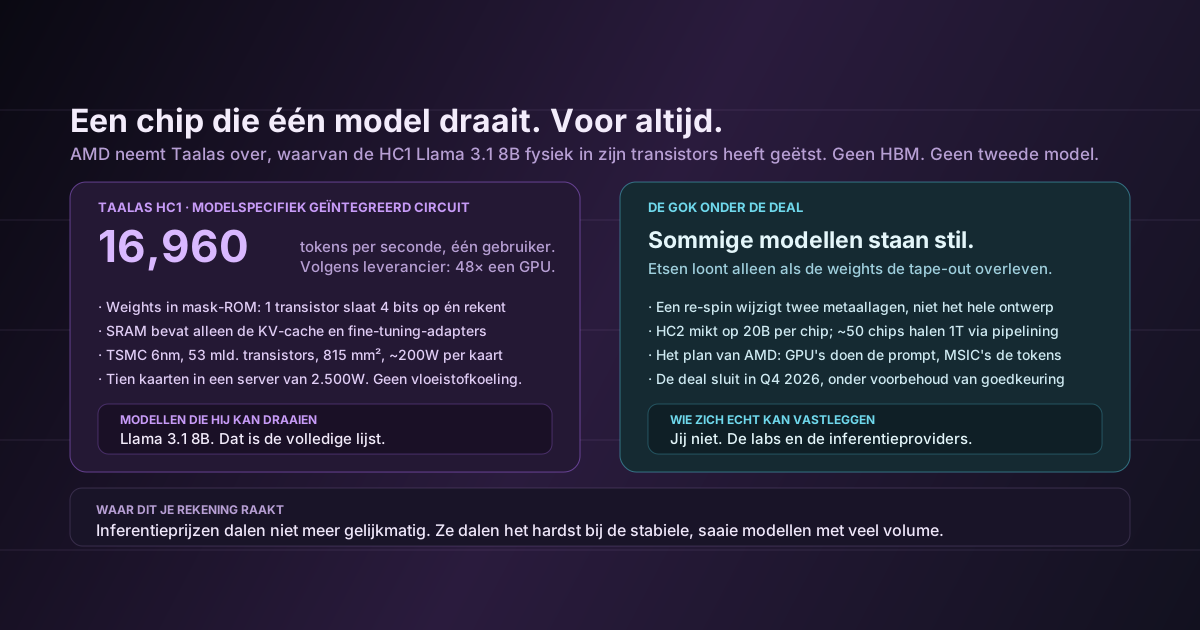
Op 6 augustus stemde AMD in met de overname van Taalas, een drie jaar oude startup uit Toronto die $219 miljoen ophaalde om chips te bouwen met het model erin gebakken. Niet ervoor geoptimaliseerd. Erin gebakken. Het eerste product van Taalas, de HC1, draait Llama 3.1 8B van Meta, en de reden dat hij niets anders kan draaien, is dat de weights fysiek in de transistors zijn geëtst.
Hij haalt volgens opgave 16.960 tokens per seconde voor één gebruiker. Dat is door de leverancier gepubliceerd, dus behandel het als richtinggevend — maar de geclaimde factor ten opzichte van huidige GPU's is ongeveer 48×, groot genoeg dat er zelfs na flinke korting iets interessants overblijft.
Gisteren schreef ik over twee coding agents die een dag na elkaar uitkwamen met tegengestelde gokken over de vraag of de harness draagbaar moet zijn. Dit is hetzelfde argument op een veel lagere laag van de stack, en in een veel extremere vorm. Alle AI-tooling optimaliseert al twee jaar voor optionaliteit — gateways, routers, abstractielagen, van model wisselen met een configuratiewijziging. AMD heeft net echt geld uitgegeven aan de tegenovergestelde gok. Dat is het begrijpen waard, want het zegt iets over waar de kostencurve naartoe gaat.
De categorie heet model-specific integrated circuit — een MSIC, naar analogie van de ASIC. Het ontwerpproces neemt de wiskunde, de routering en de parameters van een getraind model en legt die vast als vaste logica.
De chip heeft twee gebieden. De weights staan in een mask-ROM-structuur waarin — volgens oprichter Ljubisa Bajic — één transistor vier bits opslaat en de bijbehorende vermenigvuldiging uitvoert. SRAM regelt de delen die tijdens runtime echt moeten veranderen: de KV-cache en fine-tuning-adapters. Er zit nergens HBM in, en daar draait het om. Op een GPU gaat het grootste deel van de energie en van het wachten op aan het verplaatsen van weights van geheugen met hoge bandbreedte naar de rekeneenheden, steeds opnieuw, voor elk token. Als de weights al in de logica zitten, bestaat dat verkeer niet.
De fysieke cijfers: TSMC 6nm, 53 miljard transistors op een die van 815 mm², ongeveer 200 watt per kaart. Tien kaarten passen in een x86-server met twee sockets binnen een standaard budget van 2.500 watt, zonder vloeistofkoeling. Dat laatste detail lees je makkelijk over het hoofd en is misschien wel het belangrijkste van de hele aankondiging — het betekent dat dit in gewone racks in gewone gebouwen past, niet in de gespecialiseerde, stroombeperkte faciliteiten met achttien maanden wachttijd die frontier-GPU-clusters nodig hebben.
De HC2 van de tweede generatie, gepland voor deze zomer, mikt op 20 miljard parameters per chip, met pipeline-parallellisme over accelerators om groter te gaan — ongeveer 50 chips voor een biljoen parameters. Taalas stelt dat het etsen van een model in silicium ongeveer 100× minder kost dan het trainen van een frontiermodel. Dat is een vergelijking met een heel groot getal en moet je lezen als "betaalbaar vergeleken met een trainingsrun", niet als "goedkoop".
AMD wil zijn GPU's niet vervangen. Het plan is de twee helften van inferentie uit elkaar te trekken, die eigenlijk nooit dezelfde hardware wilden.
Je prompt verwerken — prefill — wordt begrensd door rekenkracht en is sterk parallel. Alle inputtokens kunnen tegelijk worden bewerkt, precies waar een GPU goed in is. Het antwoord genereren — decode — wordt begrensd door geheugenbandbreedte en is hardnekkig sequentieel: één token tegelijk, en voor elk token moet de volledige set weights opnieuw worden gelezen. Daar zijn GPU's verspillend in, en dat zijn ze altijd geweest. In het plan van AMD doen Instinct-GPU's de prompt, genereren Taalas-accelerators de tokens, en zit het geheel in het Helios-platform op rackschaal naast EPYC en ROCm. Het alternatief dat AMD noemt, is een tick-tockcyclus: klanten valideren een model op Instinct-GPU's en zetten de uitgekristalliseerde workload daarna over op een MSIC.
Er is ook een puur concurrentiële lezing. De slotgracht van NVIDIA is voor een groot deel een slotgracht van geheugen en interconnect. Een ontwerp dat volledig om HBM heen gaat, is een van de weinige aanvallen die niet vereisen dat je NVIDIA op zijn eigen terrein verslaat. De deal sluit in Q4 2026, onder voorbehoud van goedkeuring door toezichthouders, dus niets hiervan is direct.
Hier loont het om even stil te staan. Een model in silicium etsen is economisch alleen zinvol als de weights langer meegaan dan de tape-out. AMD betaalt voor de stelling dat sommige modellen niet meer zullen veranderen.
Dat gaat recht in tegen het heersende verhaal, ook het verhaal dat ik op deze blog vertel: dat modellen maandelijks verschijnen, dat elke routeringsbeslissing binnen een kwartaal verkeerd is, dat je zo moet bouwen dat reageren op een nieuwe release goedkoop is. Dat blijft allemaal waar aan de frontier. Maar de frontier is niet waar het tokenvolume zit.
Denk na over waar inferentie in een volwassen product echt naartoe gaat: classificatie, extractie, reranking, embedding-pipelines, routeringsbeslissingen, guardrail-checks, de tussenstappen van een agentloop die geen mens ooit leest. Dat werk heeft het frontiermodel van dit kwartaal niet nodig. Het heeft een competente 8B nodig die zich morgen hetzelfde gedraagt als vandaag. Teams pinnen die modellen bewust vast, omdat wisselen betekent dat alles stroomafwaarts opnieuw moet worden gevalideerd. Dat Llama 3.1 8B het eerste doel van de HC1 is, is geen toeval — het is een werkpaard dat lang genoeg stabiel is om een enorme, saaie installatiebasis met veel volume op te bouwen.
Twee dingen die tegenstrijdig lijken en het niet zijn
Het modelverloop versnelt en een groot deel van de productietokens concentreert zich op een klein aantal bevroren werkpaarden. Allebei waar, omdat ze verschillende lagen beschrijven. De frontier beweegt snel omdat daar de concurrentie zit; de onderlaag komt tot rust omdat een vastgepind model opnieuw valideren in een heel productiesysteem duur is en niemand dat voor de lol doet.
Een chip die vastzit aan één model, in een markt die elke maand nieuwe modellen uitbrengt, klinkt als een dure manier om verouderd te raken. Drie dingen zwakken dat af, en één niet.
Je gaat er nooit een kopen. Je huurt de gevolgen, en die gevolgen zijn specifieker dan "inferentie wordt goedkoper".
Elk getal in dit stuk is gepubliceerd door de leverancier, een bedrijf dat zijn tweede product nog niet heeft geleverd, binnen een deal die nog niet rond is. Siliciumroadmaps lopen uit, prestatieclaims krimpen bij onafhankelijke tests, en overnames worden opgenomen in productlijnen en verdwijnen stilletjes. Houd de details losjes vast.
Houd de richting steviger vast. Drie jaar lang was de hele AI-stack zacht — alles een configuratiewijziging, alles verwisselbaar, optionaliteit op elke laag behouden omdat niemand wist wat ertoe zou doen. Verharding begint als de antwoorden niet meer veranderen. Een bedrijf dat weights in ROM etst, beweert dat delen hiervan nu goed genoeg bekend zijn om je er fysiek aan te binden, en dat een bedrijf van de omvang van AMD het daarmee eens is, is het echte nieuws, meer dan welk doorvoercijfer ook.
Voor founders is de nuttige zet niet een kant kiezen. Het is weten welke delen van je eigen systeem welke zijn. Wat je over twee jaar nog draait — je evaluatieset, je retrievallogica, het werkpaardmodel dat de onopvallende 90% van je tokens doet — verdient het om als infrastructuur te worden behandeld en stevig te worden geoptimaliseerd. De frontieraanroep die je deze week doet, hoort achter een gateway te blijven waar wisselen een middag kost. De meeste teams hebben dat precies omgekeerd: ze zijn geobsedeerd door de modelkeuze die over een kwartaal verouderd is en improviseren de delen die haar overleven.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.