Anthropic a bloqué 1 action d'agent sur 47 000. Le chiffre à copier, c'est le 100 %

By Surya Pratap
19 septembre 2026
11 min read
AI & Technology

19 septembre 2026
11 min read
 Un milliard entre, cinquante sortentHover to explore
L'article d'hier se terminait sur une plainte : on ne peut pas relire ce que l'on ne journalise pas. Aujourd'hui il existe un document qui montre à quoi ressemble l'autre bout de cet argument quand quelqu'un l'a réellement construit, à une échelle que personne d'autre n'a publiée.
Les chiffres de cet article proviennent de « Measurements for understanding the pace of AI development inside frontier labs » d'Anthropic, publié le 17 septembre 2026, et de la couverture d'Engadget, Quartz et FourWeekMBA. Chaque nombre est Anthropic se mesurant elle-même, réserve qu'Anthropic énonce clairement et que je reprends à la section 7. La lecture que j'en fais, et tout ce qui suit la section 4, est la mienne.
Anthropic a publié trois mesures de sa propre recherche et développement en IA, proposées comme des indicateurs que les laboratoires de frontière devraient rapporter régulièrement plutôt que comme une divulgation ponctuelle.
Quelle part du travail de recherche en IA de l'entreprise Claude mène, évaluée sur une échelle d'autonomie d'AL0 à AL5 développée à l'origine par Epoch AI.
Combien d'agents internes tournent, quelle part de ce qu'ils font est surveillée, et ce qui se passe quand un moniteur s'y oppose.
Quelle part du calcul de R&D en IA est allée au travail de sûreté, mesurée sur une seule semaine.
Le titre repris partout fut le premier : Claude mène 26 % du travail de R&D en IA d'Anthropic en août 2026, contre moins de 1 % en février. Ce chiffre circule sans sa seconde moitié, qui le change — voir la section 5.
La deuxième mesure est celle que j'emporterais en réunion de conception.
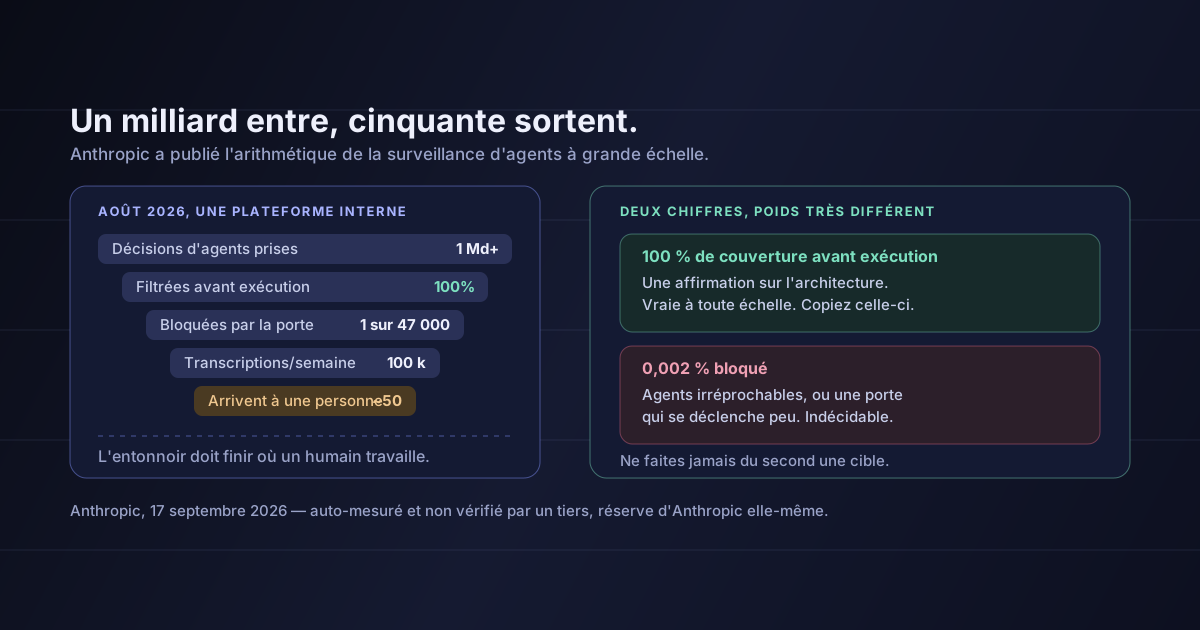
En août 2026, sur la plateforme interne principale d'Anthropic :
Un milliard de décisions à un bout, cinquante relectures humaines à l'autre, et un chemin annoncé entre les deux.
Quoi qu'on discute par ailleurs, cet entonnoir est un véritable artefact d'ingénierie. C'est la première fois qu'un laboratoire publie l'arithmétique par laquelle le travail automatisé se resserre jusqu'à quelque chose qu'une personne peut réellement traiter.
0,002 %, c'est le nombre qui finira dans les présentations, et pris isolément il n'informe presque pas. Anthropic le dit elle-même, en toutes lettres : un taux aussi bas est compatible avec des agents qui tentent rarement quelque chose méritant un blocage, et tout aussi compatible avec un moniteur qui intervient rarement par conception.
Ce sont deux mondes très différents, et aucun taux de blocage ne peut les distinguer. Un moniteur qui ne bloque rien obtient le même score qu'une flotte d'agents irréprochables.
Pourquoi un taux de blocage échoue comme métrique
Poussez la logique à ses extrêmes. Un moniteur sans règles bloque 0 % et paraît parfait. Un moniteur qui bloque tout bloque 100 % et paraît alarmant tout en étant parfaitement sûr et parfaitement inutile. La métrique bouge pour des raisons sans rapport avec le bon fonctionnement de la surveillance, ce qui veut dire qu'elle ne peut pas servir de cible — et dès que quelqu'un la cible, elle cesse de mesurer même le peu qu'elle mesurait.
Les chiffres qui, eux, portent de l'information sont ceux qui parlent de couverture :
« 100 % des actions passent par le moniteur avant exécution » est une affirmation sur l'architecture. Elle est vérifiable, elle est réfutable, elle ne bouge pas avec le comportement du modèle, et c'est la même affirmation que vos agents prennent un milliard de décisions par mois ou quatre cents. « 100 % ingéré après coup » est le même type d'affirmation sur la seconde couche.
Si vous ne copiez qu'une chose de cette publication, copiez l'engagement de couverture. Ne copiez pas la cible.
Face à un chiffre comme 30 000 agents, l'instinct est de se dire que rien de tout cela ne concerne une équipe de cinq. La structure, si ; seules les constantes changent.
| La couche d'Anthropic | Ce qu'elle fait | La version à l'échelle d'un MVP |
|---|---|---|
| Moniteur en ligne, 100 % avant exécution | Bon marché, synchrone, bloque avant que l'action n'atterrisse | Un contrôle de politique sur le chemin d'appel d'outil : liste blanche, validation des arguments, plafonds de dépense et de rayon d'impact |
| Actions bloquées relues par une personne sous une semaine | Latence bornée sur la voie d'exception | Une file avec un responsable et une règle sur l'âge maximal d'un élément |
| Moniteur hors ligne, 100 % après coup | Lit tout, sans budget de latence, attrape ce pour quoi la porte n'a pas été écrite | Un passage nocturne sur les transcriptions de la veille avec un classifieur bon marché |
| ~1 à 2 signalements sur mille, ~50 à une personne | Réglé pour que le bout humain soit un nombre qu'un humain peut traiter | Réglez le seuil sur la capacité de relecture dont vous disposez réellement |
L'astuce de réglage cachée dans les chiffres
Travaillez à rebours depuis la dernière colonne, pas la première. Le taux de signalement hors ligne d'Anthropic aboutit à une cinquantaine d'éléments par semaine arrivant chez une personne — un nombre qu'une équipe peut vraiment absorber. Le seuil a presque certainement été choisi pour produire cela, plutôt que dérivé de premiers principes puis jugé gérable après coup. Réglez le vôtre pareil : décidez combien de transcriptions une personne lira chaque semaine, puis placez la barre là où elle en produit autant.
Le découpage en deux couches est ce que la plupart des petites équipes ratent. Elles construisent un seul moniteur, le placent en ligne, et doivent alors le garder bon marché et rapide — donc il ne peut vérifier que ce qui est bon marché et rapide à vérifier. Les couches en ligne et hors ligne existent précisément parce que ces contraintes diffèrent. La porte arrête l'évident et l'irréversible. Le passage après coup est l'endroit où vous pouvez vous permettre d'être lent, minutieux et méfiant.
Revenons au titre, car sa manière d'être cité compte pour qui planifie des recrutements dessus.
Les 26 % sont la part des tâches mesurées de R&D en IA que Claude mène au niveau AL4, et AL4 se définit comme accomplir l'essentiel d'une tâche de bout en bout à partir d'une consigne de haut niveau pendant qu'une personne supervise. AL5 — sans humain dans la boucle — est à 0 %. Plus de 90 % des tâches mesurées se situent à AL3 ou au-dessus, où l'IA abat de grands blocs de travail sous direction humaine étroite.
Le résumé honnête de l'indice n'est donc pas « un quart de la recherche est automatisé ». C'est qu'un quart de la recherche est mené par un modèle avec quelqu'un qui regarde encore, et que la catégorie sans supervision est vide.
Et un chiffre de méthodologie qui mérite plus d'attention que les 26 % :
Les évaluations sont produites par un modèle juge, et Anthropic rapporte que le juge et les évaluateurs humains étaient d'accord exactement 59 % du temps, et à un niveau près 97 % du temps.
C'est une divulgation réellement utile, et elle se transpose directement à votre jeu d'évaluation. Un juge qui s'accorde avec une personne trois fois sur cinq est presque inutile pour trancher une tâche isolée, et parfaitement acceptable pour suivre un agrégat dans le temps — ce à quoi sert précisément cet indice. Si vous utilisez un modèle pour noter votre propre agent, cette distinction est tout l'enjeu : les agrégats tolèrent des juges bruités, les décisions individuelles de réussite ou d'échec non.
Quatre choses, dans l'ordre où je les ferais, dimensionnées pour une équipe qui n'a pas trente mille agents.
Écrivez votre chiffre de couverture. Pas la cible : la fraction réelle des actions de l'agent qui passe un contrôle avant exécution. Si ce n'est pas 100 %, l'écart est la liste de ce que votre agent peut faire sans que personne regarde.
Séparez la porte de l'audit. Un contrôle synchrone sur le chemin d'appel d'outil, assez bon marché pour tourner sur tout. Un passage asynchrone sur les transcriptions, assez lent pour être minutieux. Vouloir les deux d'un seul composant, c'est ce qui produit un moniteur qui ne fait bien ni l'un ni l'autre.
Fixez le seuil d'escalade depuis votre capacité de relecture. Décidez d'abord combien de transcriptions une personne lira chaque semaine, puis réglez le classifieur jusqu'à ce que ce soit ce qui arrive. Une file que personne ne vide n'est pas de la surveillance.
Bornez la latence de la voie d'exception. Celle d'Anthropic est d'une semaine pour une action bloquée. La vôtre peut être ce que vous pouvez tenir, mais elle doit être écrite, car une file de relecture sans borne devient en silence une liste de refus que personne ne rouvre.
Rien de tout cela n'exige une équipe de sûreté. Cela exige de décider que le chemin de surveillance est du produit et non un ajout — et la raison de le décider maintenant, c'est que rétro-installer la couverture sur un agent qui a déjà cinquante outils est nettement plus dur que de la construire avec cinq.
Chacun de ces nombres, c'est Anthropic mesurant Anthropic. Aucune partie externe n'a vérifié la moindre évaluation. Anthropic dit prévoir d'intégrer des évaluateurs tiers indépendants avec un accès comparable à celui des équipes de risque internes ; c'est un plan annoncé, pas un fait existant, et il faut le lire ainsi.
Les chiffres de calcul de sûreté couvrent une semaine. 6 % du calcul de R&D en IA à la sûreté, 12 % au sein de la R&D en IA menée par l'IA, mesurés du 13 au 20 juillet 2026. Anthropic est explicite : une unique fenêtre de sept jours suffit à montrer que la mesure est faisable, pas à montrer une tendance. C'est pourquoi j'ai laissé ces chiffres hors de l'argument ci-dessus.
L'indice d'automatisation mesure un panier figé de types de tâches. Il suit à quel point le travail connu s'est automatisé, pas si de nouveaux types de travail apparaissent — ce qui est justement le plus susceptible de faire bouger le vrai chiffre.
« Surveillé » n'est pas « compris ». Anthropic note qu'elle pratique ce type de surveillance depuis des mois et non des années, et qu'il est difficile d'être certain que le tableau des comportements possibles soit complet. Une couverture totale des actions n'est pas une couverture totale des modes de défaillance.
La transposition de la section 4 est la mienne. Anthropic a publié son architecture, pas une recommandation pour des équipes de cinq. Que la structure se transpose vers le bas est mon inférence, et les constantes de ce tableau sont illustratives.
Ce qui est intéressant dans cette publication, ce n'est pas que les chiffres soient flatteurs — ils le sont, ils sont auto-déclarés, et ces deux points devraient être escomptés.
Ce qui est intéressant, c'est qu'un laboratoire a publié la forme de la surveillance d'agents à une échelle où cette forme est forcée d'être réelle. Un milliard de décisions ne se relit pas avec de bonnes intentions. Quelque chose doit tout filtrer à bas coût, autre chose doit tout lire lentement, et l'entonnoir entre les deux doit se terminer sur un nombre qu'un être humain peut réellement traiter un jeudi après-midi.
Cette structure n'est pas un luxe de laboratoire de frontière. C'est à quoi ressemble la surveillance dès qu'un agent prend plus d'actions par jour que vous ne pouvez en lire, ce qui arrive pour la plupart des équipes vers la troisième semaine.
Ne vous comparez pas au taux de blocage. Demandez quelle fraction des actions de votre agent passe un contrôle avant de se produire, et soyez honnête sur la réponse.
Sources : Anthropic, « Measurements for understanding the pace of AI development inside frontier labs », publié le 17 septembre 2026 — l'échelle AL0–AL5, les 26 % en AL4, les plus de 90 % en AL3, les quelque 30 000 agents, les affirmations de couverture à 100 % en ligne et hors ligne, le taux de blocage de 0,002 % et le cadrage à une sur 47 000, le taux de signalement d'une à deux sur mille, les quelque 100 000 transcriptions par semaine et la cinquantaine d'escalades humaines, la borne de relecture d'une semaine, les 6 % et 12 % de calcul de sûreté du 13 au 20 juillet 2026, l'accord de 59 % exact et 97 % à un niveau près, et toutes les réserves de la section 7 sont tels que publiés là. L'échelle AL0–AL5 vient d'Epoch AI. Engadget et Quartz, 18 septembre 2026, pour la couverture et le cadrage ; FourWeekMBA pour la date de publication et un tableau consolidé des chiffres. La transposition aux petites équipes de la section 4, l'argument sur les taux de blocage de la section 3 et la lecture de l'accord du juge de la section 5 sont les miens. Pour l'article que celui-ci prolonge — l'entrée d'agent que personne ne journalise — voir votre agent écrit son propre contexte. Pour la thèse selon laquelle une piste d'audit ne peut plus venir du modèle s'expliquant lui-même, voir la surveillabilité est allée dans l'autre sens.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.