AMD vient d'acheter une puce qui n'exécute qu'un seul modèle (2026)

By Surya Pratap
8 août 2026
11 min read
AI & Technology

8 août 2026
11 min read
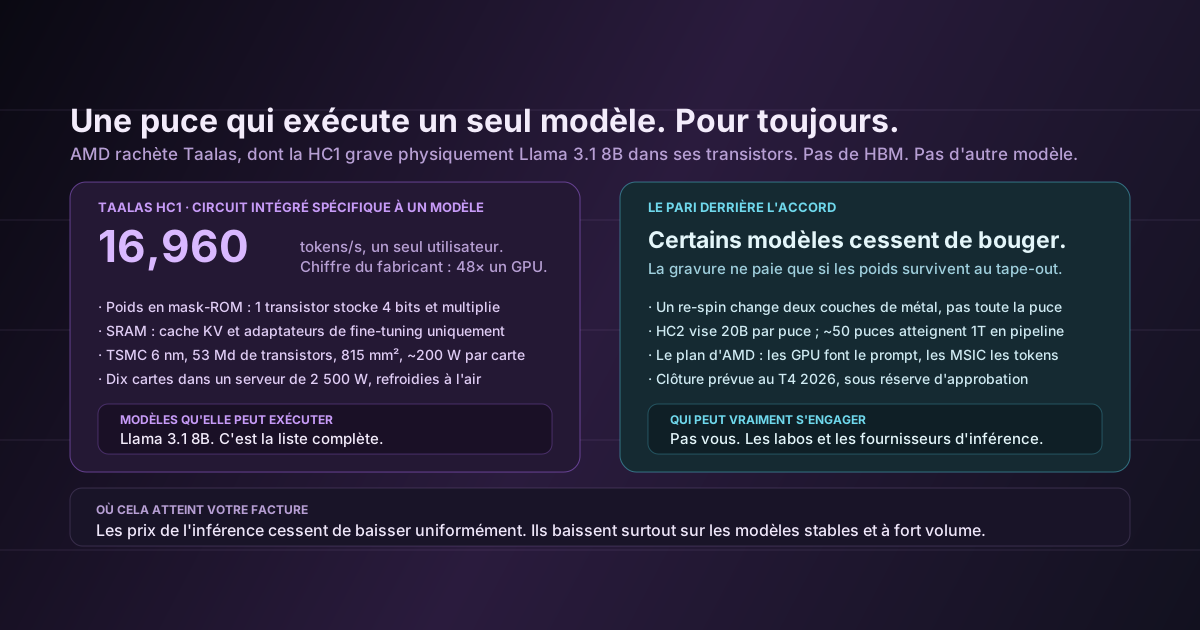
Le 6 août, AMD a accepté de racheter Taalas, une startup torontoise de trois ans qui a levé 219 millions de dollars pour fabriquer des puces dans lesquelles le modèle est intégré. Pas optimisées pour lui. Intégré. Le premier produit de Taalas, la HC1, exécute Llama 3.1 8B de Meta, et si elle ne peut rien exécuter d'autre, c'est que les poids sont physiquement gravés dans les transistors.
Elle annonce 16 960 tokens par seconde pour un seul utilisateur. C'est un chiffre publié par le fabricant, à prendre comme une indication — mais le multiple revendiqué face aux GPU actuels est d'environ 48×, un chiffre assez grand pour qu'il reste quelque chose d'intéressant même après une forte décote.
Hier, j'ai écrit sur deux agents de code sortis à un jour d'intervalle avec des paris opposés sur la portabilité du harness. C'est le même débat à une couche bien plus basse du stack, et dans une version bien plus extrême. Depuis deux ans, tout l'outillage IA optimise l'optionalité : gateways, routeurs, couches d'abstraction, changement de modèle par simple modification de configuration. AMD vient de dépenser de l'argent réel sur le pari inverse. Cela mérite d'être compris, car cela dit quelque chose de la direction que prend la courbe des coûts.
Le nom de la catégorie est circuit intégré spécifique à un modèle — un MSIC, par analogie avec l'ASIC. Le flux de conception prend les calculs, le routage et les paramètres d'un modèle entraîné et les dispose sous forme de logique fixe.
La puce comporte deux régions. Les poids résident dans une matrice de lecture mask-ROM où — selon la description du fondateur Ljubisa Bajic — un seul transistor stocke quatre bits et effectue la multiplication associée. La SRAM gère ce qui doit vraiment changer à l'exécution : le cache KV et les adaptateurs de fine-tuning. Il n'y a de HBM nulle part, et c'est tout l'intérêt. Sur un GPU, l'essentiel de l'énergie et de l'attente sert à déplacer les poids de la mémoire à haute bande passante vers les unités de calcul, encore et encore, pour chaque token. Si les poids sont déjà dans la logique, ce trafic n'existe pas.
Les chiffres physiques : TSMC 6 nm, 53 milliards de transistors sur une puce de 815 mm², environ 200 watts par carte. Dix cartes tiennent dans un serveur x86 bi-socket dans une enveloppe standard de 2 500 watts, sans refroidissement liquide. Ce dernier détail passe facilement inaperçu et c'est sans doute le plus lourd de conséquences de toute l'annonce : cela signifie que la puce se déploie dans des baies ordinaires de bâtiments ordinaires, et non dans les installations spécialisées, contraintes en puissance et avec dix-huit mois d'attente dont ont besoin les clusters de GPU de pointe.
La HC2 de deuxième génération, attendue cet été, vise 20 milliards de paramètres par puce, avec un parallélisme de pipeline entre accélérateurs pour aller plus loin — une cinquantaine de puces pour atteindre mille milliards de paramètres. Taalas affirme que graver un modèle dans le silicium coûte environ 100 fois moins cher qu'entraîner un modèle de pointe, ce qui est une comparaison avec un chiffre énorme et doit se lire comme « abordable par rapport à un entraînement », pas comme « bon marché ».
Le plan affiché d'AMD n'est pas de remplacer ses GPU. Il est de désagréger les deux moitiés de l'inférence, qui n'ont jamais vraiment voulu le même matériel.
Traiter votre prompt — le prefill — est limité par le calcul et très parallèle. Tous les tokens d'entrée peuvent être traités en même temps, ce qui est exactement ce que fait bien un GPU. Générer la réponse — le decode — est limité par la bande passante mémoire et obstinément séquentiel : un token à la fois, chacun exigeant de relire l'ensemble des poids. Les GPU y sont inefficaces, et l'ont toujours été. Dans le plan d'AMD, les GPU Instinct traitent le prompt, les accélérateurs Taalas génèrent les tokens, et l'ensemble s'intègre à sa plateforme à l'échelle de la baie Helios, aux côtés d'EPYC et de ROCm. L'alternative évoquée est un cycle tick-tock : les clients valident un modèle sur GPU Instinct, puis basculent la charge stabilisée sur un MSIC.
Il y a aussi une lecture purement concurrentielle. La douve de NVIDIA est en grande partie une douve de mémoire et d'interconnexion. Une conception qui contourne entièrement la HBM est l'une des rares attaques possibles qui ne passent pas par battre NVIDIA sur son propre terrain. L'accord sera conclu au quatrième trimestre 2026 sous réserve d'approbation réglementaire, donc rien de tout cela n'est imminent.
C'est sur ce point qu'il vaut la peine de s'arrêter. Graver un modèle dans le silicium n'a de sens économique que si les poids survivent au tape-out. AMD paie pour la thèse selon laquelle certains modèles vont cesser de changer.
Cela va directement à l'encontre du récit dominant, y compris celui que je tiens sur ce blog : les modèles sortent chaque mois, toute décision de routage est caduque en un trimestre, il faut construire pour qu'il soit peu coûteux de répondre à une nouvelle version. Tout cela reste vrai à la pointe. Mais la pointe n'est pas là où se trouve le volume de tokens.
Pensez à l'endroit où l'inférence est réellement dépensée dans un produit mature : classification, extraction, reranking, pipelines d'embeddings, décisions de routage, contrôles de garde-fous, étapes intermédiaires d'une boucle d'agent qu'aucun humain ne lit. Ce travail n'a pas besoin du modèle de pointe de ce trimestre. Il a besoin d'un 8B compétent qui se comporte demain comme aujourd'hui. Les équipes figent ces modèles délibérément, parce que les changer impose de tout revalider en aval. Que Llama 3.1 8B soit la première cible de la HC1 n'est pas un hasard : c'est un cheval de trait resté stable assez longtemps pour accumuler une base installée énorme, ennuyeuse et à fort volume.
Deux choses qui semblent contradictoires et ne le sont pas
Le renouvellement des modèles s'accélère et une large part des tokens de production se concentre sur un petit nombre de chevaux de trait figés. Les deux sont vrais parce qu'ils décrivent des couches différentes. La pointe bouge vite parce que c'est là qu'est la concurrence ; le socle se stabilise parce que revalider un modèle figé dans tout un système de production coûte cher, et que personne ne le fait par plaisir.
Une puce liée à un seul modèle dans un marché qui sort de nouveaux modèles chaque mois ressemble à une façon coûteuse de devenir obsolète. Trois éléments nuancent ce constat, un non.
Vous n'achèterez jamais une de ces puces. Vous louerez leurs conséquences, et ces conséquences sont plus précises que « l'inférence devient moins chère ».
Chaque chiffre de cet article est publié par le fabricant, une entreprise qui n'a pas encore livré son deuxième produit, dans le cadre d'un accord qui n'est pas encore conclu. Les feuilles de route du silicium glissent, les performances annoncées se tassent sous les tests indépendants, et les acquisitions sont absorbées dans des gammes de produits puis disparaissent sans bruit. Tenez les détails sans les serrer.
Tenez la direction plus fermement. Pendant trois ans, tout le stack IA a été souple — tout se réglait par configuration, tout était interchangeable, l'optionalité préservée à chaque couche parce que personne ne savait ce qui compterait. Le durcissement commence quand les réponses cessent de changer. Une entreprise qui grave des poids en ROM affirme que certaines parties sont désormais assez bien connues pour qu'on s'y engage physiquement, et qu'une entreprise de la taille d'AMD lui donne raison est la véritable nouvelle, bien plus que n'importe quel chiffre de débit.
Pour un fondateur, le geste utile n'est pas de choisir un camp. C'est de savoir quelles parties de son propre système relèvent de quoi. Ce que vous exécuterez encore dans deux ans — votre jeu d'évaluation, votre logique de recherche, le modèle cheval de trait qui produit les 90 % peu glorieux de vos tokens — mérite d'être traité comme de l'infrastructure et optimisé à fond. L'appel au modèle de pointe que vous faites cette semaine mérite de rester derrière une gateway où le changer coûte un après-midi. La plupart des équipes font exactement l'inverse : elles s'obsèdent sur le choix de modèle qui sera obsolète dans un trimestre et improvisent les parties qui lui survivront.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.