Anthropic bloqueó 1 acción de agente entre 47.000. La cifra que hay que copiar es el 100%

By Surya Pratap
19 de septiembre de 2026
11 min read
AI & Technology

19 de septiembre de 2026
11 min read
 Mil millones entran, cincuenta salenHover to explore
El artículo de ayer terminaba con una queja: no puedes revisar lo que no registras. Hoy hay un documento que enseña cómo es el otro extremo de ese argumento cuando alguien lo ha construido de verdad, a una escala que nadie más ha publicado.
Las cifras de este artículo proceden de «Measurements for understanding the pace of AI development inside frontier labs» de Anthropic, publicado el 17 de septiembre de 2026, y de la cobertura de Engadget, Quartz y FourWeekMBA. Todos los números son Anthropic midiéndose a sí misma, una salvedad que la propia Anthropic enuncia con claridad y que repito en el apartado 7. La lectura que hago de ellos, y todo lo que va del apartado 4 en adelante, es mía.
Anthropic publicó tres mediciones de su propia investigación y desarrollo en IA, propuestas como algo que los laboratorios de frontera deberían reportar de forma rutinaria y no como una divulgación puntual.
Cuánto del trabajo de investigación en IA de la compañía lidera Claude, valorado contra una escala de autonomía de AL0 a AL5 desarrollada originalmente por Epoch AI.
Cuántos agentes internos se ejecutan, cuánto de lo que hacen está monitorizado y qué pasa cuando un monitor objeta.
Qué proporción del cómputo de I+D en IA fue a trabajo de seguridad, medido a lo largo de una sola semana.
El titular que todos recogieron fue el primero: Claude lidera el 26% del trabajo de I+D en IA de Anthropic a agosto de 2026, frente a menos del 1% en febrero. Esa cifra se está citando sin su segunda mitad, que la cambia — más sobre eso en el apartado 5.
La segunda medición es la que yo sí llevaría a una reunión de producto.
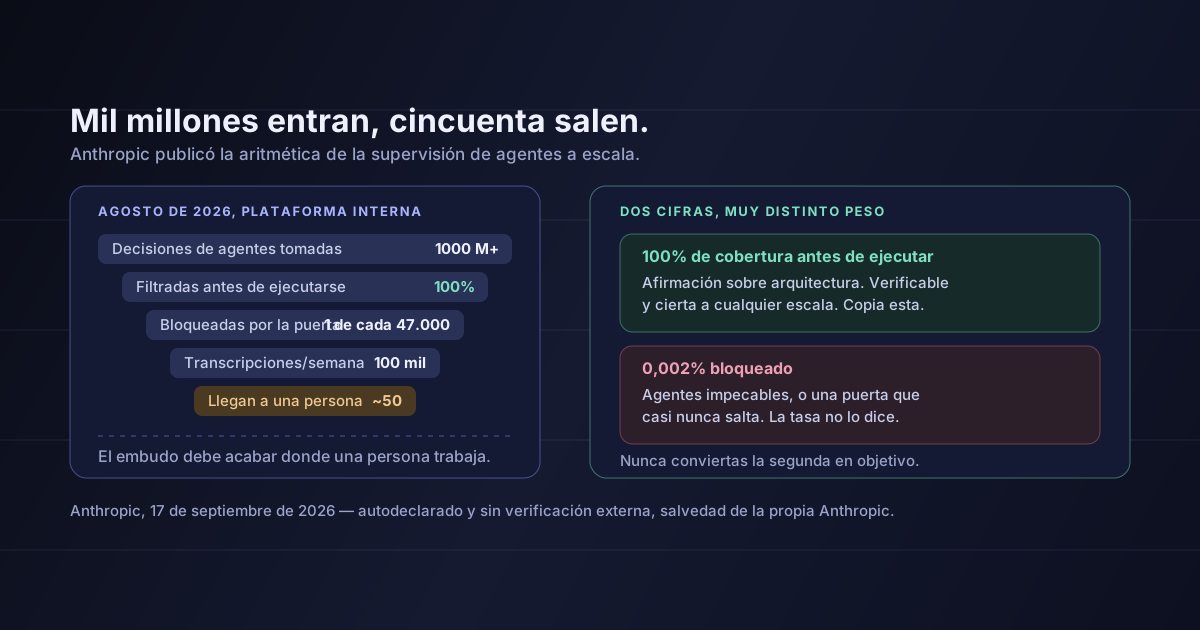
A agosto de 2026, en la plataforma interna principal de Anthropic:
Mil millones de decisiones en un extremo, cincuenta revisiones humanas en el otro y un camino declarado entre ambos.
Sea lo que sea discutible aquí, ese embudo es un artefacto de ingeniería real. Es la primera vez que un laboratorio publica la aritmética de cómo el trabajo automatizado se estrecha hasta algo que una persona puede atender de verdad.
El 0,002% es el dato que acabará en presentaciones, y por sí solo apenas informa. La propia Anthropic lo dice con todas las letras: una tasa así de baja encaja con agentes que rara vez intentan algo que merezca bloqueo, y encaja igual de bien con un monitor que interviene poco por diseño.
Son mundos muy distintos, y ninguna tasa de bloqueo puede distinguirlos. Un monitor que no bloquea nada puntúa exactamente igual que una flota de agentes impecables.
Por qué una tasa de bloqueo falla como métrica
Lleva la lógica a sus extremos. Un monitor sin reglas bloquea el 0% y parece perfecto. Un monitor que bloquea todo bloquea el 100% y parece alarmante siendo perfectamente seguro y perfectamente inútil. La métrica se mueve por razones que no tienen nada que ver con si la supervisión funciona, lo que significa que no puede usarse como objetivo — y en cuanto alguien la convierte en objetivo, deja de medir incluso lo poco que medía.
Las cifras que sí llevan información son las que hablan de cobertura:
«El 100% de las acciones pasa por el monitor antes de ejecutarse» es una afirmación sobre la arquitectura. Es verificable, es falsable, no se mueve con el comportamiento del modelo y es la misma afirmación tanto si tus agentes toman mil millones de decisiones al mes como cuatrocientas. «El 100% se ingiere después» es el mismo tipo de afirmación sobre la segunda capa.
Si copias una sola cosa de esta publicación, copia el compromiso de cobertura. No copies el objetivo.
El instinto ante una cifra como 30.000 agentes es que nada de esto aplica a un equipo de cinco. La estructura sí aplica; lo único que cambia son las constantes.
| La capa de Anthropic | Qué hace | La versión a escala de MVP |
|---|---|---|
| Monitor en línea, 100% previo a la ejecución | Barato, síncrono, bloquea antes de que la acción aterrice | Una comprobación de política en la ruta de llamada a herramientas: lista blanca, validación de argumentos, topes de gasto y de radio de impacto |
| Acciones bloqueadas a revisión humana en una semana | Latencia acotada en la vía de excepción | Una cola con responsable y una regla sobre cuánto puede envejecer un elemento |
| Monitor fuera de línea, 100% a posteriori | Lee todo, sin presupuesto de latencia, atrapa aquello para lo que no se escribió la puerta | Una pasada nocturna sobre las transcripciones de ayer con un clasificador barato |
| ~1–2 marcas por cada mil, ~50 a una persona | Ajustado para que el extremo humano sea un número que un humano pueda hacer | Ajusta el umbral a la capacidad de revisión que realmente tienes |
La clave de ajuste escondida en las cifras
Trabaja hacia atrás desde la última columna, no desde la primera. La tasa de marcado fuera de línea de Anthropic aterriza en unos cincuenta elementos por semana llegando a una persona — un número que un equipo puede procesar de verdad. Casi con seguridad el umbral se eligió para producir eso, y no se derivó de primeros principios para descubrir luego que era manejable. Tu umbral debería fijarse igual: decide cuántas transcripciones leerá una persona cada semana y pon el listón donde produzca esa cantidad.
La división en dos capas es la parte que la mayoría de los equipos pequeños hace mal. Construyen un único monitor, lo ponen en línea y entonces tienen que mantenerlo barato y rápido — lo que significa que solo puede comprobar cosas baratas y rápidas de comprobar. Las capas en línea y fuera de línea existen precisamente porque esas restricciones son distintas. La puerta detiene lo evidente y lo irreversible. La pasada a posteriori es donde puedes permitirte ser lento, minucioso y desconfiado.
Volvamos al titular, porque cómo se cita importa para quien planifique contrataciones a partir de él.
El 26% es la proporción de tareas medidas de I+D en IA que Claude lidera en AL4, y AL4 se define como completar la mayor parte de una tarea de principio a fin desde una instrucción de alto nivel mientras una persona supervisa. AL5 — sin humano en el bucle — es el 0%. Más del 90% de las tareas medidas están en AL3 o por encima, donde la IA hace grandes bloques de trabajo bajo dirección humana estrecha.
Así que el resumen honesto del índice no es «un cuarto de la investigación está automatizada». Es que un cuarto de la investigación está liderada por un modelo con una persona todavía mirando, y que la categoría sin supervisión está vacía.
Y una cifra metodológica que merece más atención que el 26%:
Las valoraciones las produce un modelo juez, y Anthropic informa de que el juez y los evaluadores humanos coincidieron exactamente el 59% de las veces, quedando a un nivel de distancia el 97% de las veces.
Es una divulgación genuinamente útil, y se traslada directa a tu conjunto de evaluación. Un juez que coincide con una persona tres de cada cinco veces es casi inútil para decidir sobre una tarea concreta, y perfectamente servible para seguir un agregado en el tiempo — que es exactamente para lo que se usa este índice. Si usas un modelo para puntuar tu propio agente, esa distinción lo es todo: los agregados toleran jueces ruidosos, las decisiones individuales de aprobado o suspenso no.
Cuatro cosas, en el orden en que yo las haría, dimensionadas para un equipo que no tiene treinta mil agentes.
Escribe tu cifra de cobertura. No el objetivo: la fracción real de acciones del agente que pasa por una comprobación antes de ejecutarse. Si no es el 100%, la diferencia es la lista de cosas que tu agente puede hacer sin que nadie mire.
Separa la puerta de la auditoría. Una comprobación síncrona en la ruta de llamada a herramientas, barata como para correr sobre todo. Una pasada asíncrona sobre las transcripciones, lenta como para ser minuciosa. Querer ambas de un solo componente es lo que produce un monitor que no hace bien ninguna.
Fija el umbral de escalado desde tu capacidad de revisión. Decide primero cuántas transcripciones leerá una persona cada semana y luego ajusta el clasificador hasta que llegue esa cantidad. Una cola que nadie vacía no es supervisión.
Pon un límite de latencia en la vía de excepción. El de Anthropic es una semana para una acción bloqueada. El tuyo puede ser el que puedas sostener, pero tiene que estar escrito, porque una cola de revisión sin límite se convierte en silencio en una lista de denegación que nadie revisa.
Nada de esto exige un equipo de seguridad. Exige decidir que la ruta de monitorización es producto y no un añadido — y la razón para decidirlo ahora es que poner cobertura a posteriori en un agente que ya tiene cincuenta herramientas es bastante más difícil que construirla con cinco.
Todos estos números son Anthropic midiendo a Anthropic. Ninguna parte externa ha verificado ninguna de las valoraciones. Anthropic dice que planea incorporar evaluadores independientes de terceros con un acceso comparable al de los equipos internos de riesgo; eso es un plan declarado, no un hecho existente, y debe leerse como tal.
Las cifras de cómputo de seguridad cubren una semana. Un 6% del cómputo de I+D en IA a seguridad, un 12% dentro de la I+D en IA impulsada por IA, medido del 13 al 20 de julio de 2026. Anthropic es explícita en que una única ventana de siete días basta para demostrar que la medición puede hacerse y no basta para mostrar una tendencia. Por eso he dejado esas cifras fuera del argumento anterior.
El índice de automatización mide una cesta congelada de tipos de tarea. Sigue cuánto se ha automatizado el trabajo conocido, no si están apareciendo tipos nuevos de trabajo — que es lo que más probablemente mueva la cifra real.
«Monitorizado» no es «entendido». Anthropic señala que lleva meses, no años, haciendo este tipo de monitorización, y que es difícil estar seguro de que el retrato de las conductas posibles de los agentes esté completo. Cobertura total de las acciones no es cobertura total de los modos de fallo.
La correspondencia del apartado 4 es mía. Anthropic publicó su arquitectura, no una recomendación para equipos de cinco personas. Que la estructura se reduzca de escala es inferencia mía, y las constantes de esa tabla son ilustrativas.
Lo interesante de esta publicación no es que las cifras sean favorables — lo son, son autodeclaradas, y ambas cosas deberían descontarse.
Lo interesante es que un laboratorio publicó la forma de la supervisión de agentes a una escala en la que la forma está obligada a ser real. Mil millones de decisiones no se revisan con buenas intenciones. Algo tiene que filtrarlo todo de forma barata, otra cosa tiene que leerlo todo despacio, y el embudo entre ambas tiene que terminar en un número que una persona pueda procesar de verdad un jueves por la tarde.
Esa estructura no es un lujo de laboratorio de frontera. Es lo que parece la supervisión en cuanto un agente ejecuta más acciones al día de las que puedes leer, cosa que en la mayoría de los equipos ocurre hacia la tercera semana.
No te compares con la tasa de bloqueo. Pregúntate qué fracción de las acciones de tu agente pasa por una comprobación antes de ocurrir, y sé honesto con la respuesta.
Fuentes: Anthropic, «Measurements for understanding the pace of AI development inside frontier labs», publicado el 17 de septiembre de 2026 — la escala AL0–AL5, el 26% en AL4, el más del 90% en AL3, los unos 30.000 agentes, las afirmaciones de cobertura del 100% en línea y fuera de línea, la tasa de bloqueo del 0,002% y el marco de una entre 47.000, la tasa de marcado de una a dos por mil, las unas 100.000 transcripciones semanales y las unas 50 escaladas a personas, el límite de revisión de una semana, las cifras del 6% y el 12% de cómputo de seguridad del 13 al 20 de julio de 2026, la concordancia del 59% exacta y del 97% a un nivel, y todas las salvedades del apartado 7 están tal como se publican ahí. La escala AL0–AL5 es de Epoch AI. Engadget y Quartz, 18 de septiembre de 2026, para la cobertura y el encuadre; FourWeekMBA para la fecha de publicación y una tabla consolidada de las cifras. La correspondencia con la arquitectura de equipos pequeños del apartado 4, el argumento sobre tasas de bloqueo del apartado 3 y la lectura de la concordancia del juez del apartado 5 son míos. Para el artículo al que este sigue — la entrada del agente que nadie registra — véase tu agente escribe su propio contexto. Para el argumento de que una traza auditable ya no puede venir de que el modelo se explique, véase la monitorización fue en dirección contraria.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.