
Los trabajos de CI de Anthropic crecieron 25x en seis meses. El aviso estaba en lo rápido que dejaba de funcionar cada arreglo

By Surya Pratap
16 de septiembre de 2026
12 min de lectura
IA y tecnología

16 de septiembre de 2026
12 min de lectura
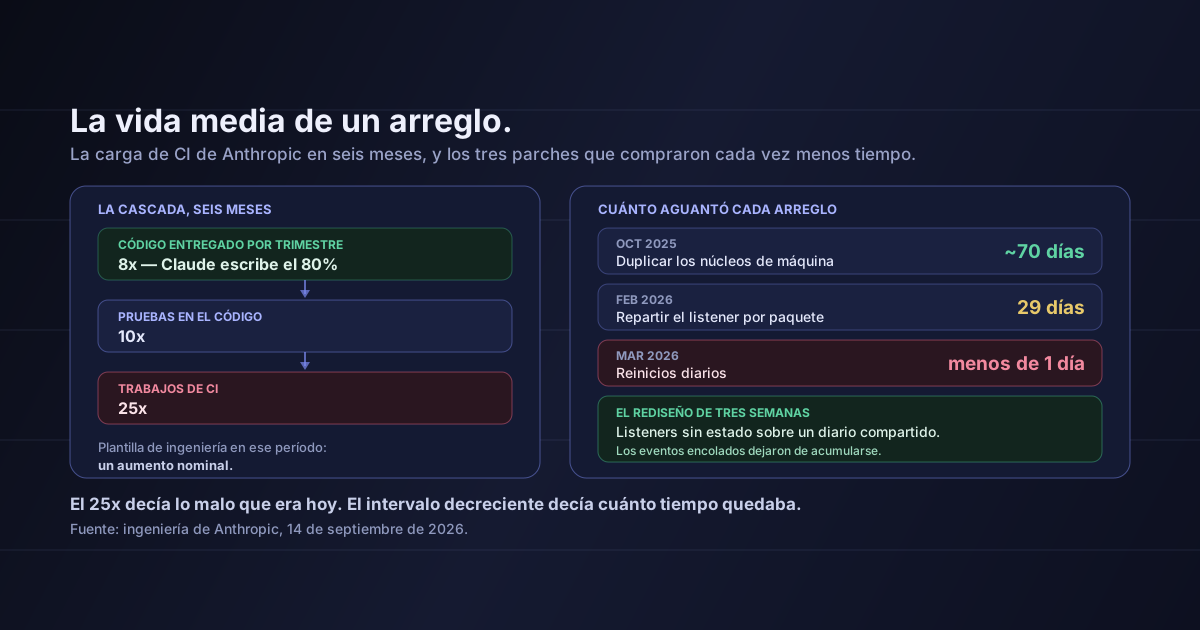 La vida media de un arregloHover to explore
Anthropic publicó sus cifras de integración continua el 14 de septiembre de 2026, en un artículo de ingeniería de Sachin Malhotra sobre la reconstrucción del servicio que decide qué pruebas ejecutar. Las cifras destacadas corrieron rápido, y con razón. Pero lo más útil del artículo es un detalle que casi nadie repitió.
Seis meses de código agéntico, medidos desde dentro
La propia organización de ingeniería de Anthropic, no el caso de un cliente
Léalas juntas y no por separado. La relación interesante no es ningún múltiplo suelto: es que 8x más código produjo 10x más pruebas y 25x más trabajos de CI. La carga no escaló con el código. Escaló con el código multiplicado por las pruebas multiplicado por la cantidad de veces que alguien pregunta «¿esto sigue en verde?».
El planteamiento de Malhotra es lo que merece citarse literalmente, porque es más preciso que la paráfrasis habitual:
Escribir código ya no es la restricción, y en cuanto se acelera la revisión de PR, el CI empieza a notar la presión.
Eso es una secuencia, no un eslogan. Tres estaciones, en orden: escribir, revisar, verificar. El código agéntico eliminó la primera restricción. Acelerar la revisión eliminó la segunda. Ninguna de las dos creó capacidad: reubicaron la cola en lo siguiente que hubiera en la fila y no tuviera holgura.
Esto es lo que querría que un fundador se llevara del artículo, por delante de cualquier cifra que contenga. Eliminar un cuello de botella no produce rendimiento. Produce un cuello de botella nuevo, una estación más abajo, que llega más rápido que el anterior y casi siempre en un sistema que nadie mira desde hace dos años.
Para la mayoría de equipos pequeños, las estaciones posteriores a «escribir el código» son la revisión, el CI, los entornos de staging, los despliegues de vista previa y después —en silencio, la última y la más cara— las personas que tienen que entender qué se publicó.
Anthropic parcheó tres veces el servicio de test impact analysis antes de reconstruirlo. Los parches eran todos sensatos. Esto es lo que duró cada uno:
Setenta, veintinueve, uno.
Ninguna decisión concreta fue errónea. Duplicar núcleos cuando un servicio va lento es correcto. Repartir cuando un único worker se satura es correcto. Reiniciar un servicio que acumula retraso es algo normal de hacer un martes. Cada arreglo era proporcional al síntoma que tenía delante.
El fallo fue que nadie medía el intervalo entre arreglos como señal propia, y ese intervalo se reducía más o menos a la mitad cada vez.
El diagnóstico que conviene copiar
Cuando cada arreglo sucesivo del mismo sistema compra menos tiempo que el anterior, está aplicando remedios lineales a una carga exponencial, y le queda menos pista de la que parece. Las cifras absolutas le dicen lo malo que es hoy. La proporción entre ellas le dice cuánto tiempo tiene. Un parche que aguanta 70 días seguido de otro que aguanta 29 no son dos incidentes. Es una tendencia con dos puntos, y el tercero ya es predecible.
El servicio tenía dos mitades: un listener que registra el resultado de cada prueba de cada ejecución de CI, y un selector que decide qué pruebas necesita realmente una pull request concreta.
La restricción era que el listener era un singleton. Un único escritor tenía que mantener el historial acumulado por prueba, lo que impedía escalarlo en horizontal: las únicas jugadas disponibles eran una máquina más grande, luego un conjunto de máquinas particionado y luego reiniciar la máquina. Los tres parches no fueron una falta de imaginación. Eran el repertorio completo de opciones que esa arquitectura permitía.
El rediseño —un proyecto de tres semanas— separó las responsabilidades sacando el estado fuera del proceso:
Lo que sustituyó al singleton
Workers sin estado sobre estado compartido, en vez de workers con estado que lo poseen
Tras el cambio, el recuento de eventos de resultados encolados sin procesar se mantuvo plano, cuando antes crecía semana a semana. Esa línea plana es el entregable real. No más rápido: sin acumulación, que es una propiedad distinta y la única que sobrevive a otro 25x.
La recomendación de Malhotra es diseñar los sistemas iniciales para 10-20x la escala percibida, cuando el presupuesto lo permita, y asumir que la carga impulsada por IA puede alcanzar 25x en dos trimestres.
Tómese en serio la última cláusula: cuando el presupuesto lo permita está haciendo trabajo de verdad en esa frase. Anthropic describe su propia infraestructura interna, en un laboratorio frontera cuyo código lo escribe el modelo que vende. Un equipo en fase semilla que copie «construya para 20x» al pie de la letra sobredimensionará un producto que todavía no ha encontrado a nadie que lo quiera, y ese modo de fallo ha matado más startups que el retraso del CI.
La versión portable es más estrecha y más barata:
Las demás lecciones que se enuncian generalizan bien y no cuestan nada: evite que un camino crítico sea un singleton, instrumente los servicios para que un agente pueda investigarlos de forma autónoma y compruebe que el volumen que entra en una cola coincide con el que sale. Esto último es cómo se detecta que un sistema se queda atrás antes de que un humano note que está desactualizado.
Anthropic publicó recuentos de trabajos. No publicó lo que cuestan esos trabajos, y para un fundador esa omisión es toda la historia, porque el CI se mide y se cobra.
Un aumento de 25x en trabajos de CI es un aumento de 25x en minutos de cómputo contra la factura de los runners, modulado solo por lo bien que funcione la selección de pruebas, que es precisamente el servicio que se estaba cayendo. Si su equipo adopta código agéntico y no hace nada más, la secuencia observable es: la velocidad sube, todo el mundo contento y, unos dos meses después, alguien pregunta por qué la línea de CI de la factura de infraestructura se ha convertido sin ruido en una de las mayores partidas.
Es la misma aritmética que el impuesto de contexto, desplazada un sistema a la izquierda. El coste del desarrollo agéntico no es solo la inferencia que compra. Es la carga de verificación que crea aguas abajo el código generado —pruebas que ejecutar, entornos que levantar, artefactos que construir, revisiones que sostener— y esa carga crece más rápido que el código.
La cifra que poner en un panel esta semana
No los minutos de CI. Minutos de CI por pull request fusionada, con seguimiento semanal. Que suban los minutos totales es esperable y está bien: significa que está entregando. Que suban los minutos por fusión significa que cada unidad de trabajo es más cara de verificar, que es el indicador adelantado que aparece meses antes que la factura.
El artículo complementario describe a Anthropic apuntando Claude a los fallos de CI/CD como primer respondedor automático: vigila alertas, investiga en Grafana, almacenes de logs, PagerDuty, GitHub y Kubernetes, y propone arreglos. Las cifras publicadas: una mediana de 14 minutos hasta el primer análisis, los casos más rápidos dentro de 4 minutos y un ejemplo resuelto en 3 minutos desde la recomendación hasta la verificación. En un caso identificó 44 pruebas que un cambio de feature flag había dejado de ejecutar en silencio.
La lectura honesta es simétrica. Es una respuesta real a la mitad operativa del problema, y también son agentes desplegados para absorber carga que crearon los agentes. Ese bucle no es necesariamente malo; casi toda automatización responde a un volumen que produjo una automatización anterior. Pero conviene nombrarlo, porque marca la dirección del viaje: el coste del código agéntico se paga cada vez más en sistemas que vigilan a los sistemas, y esos tienen su propio coste operativo.
Una semana de trabajo, no un trimestre
Ordenado por coste de hacerlo frente a coste de habérselo saltado
«Claude escribe el 80% de nuestro código» no es una estadística portable. Describe un laboratorio frontera con herramientas poco habituales, un código poco habitual y un incentivo poco habitual para demostrar la afirmación. Tómelo como prueba de que el techo está alto, no como un objetivo respecto al que su equipo va retrasado.
8x de código entregado no es 8x de valor entregado. La métrica es volumen de código por trimestre. Nada en el artículo afirma ocho veces más resultados de producto, y el volumen de código es una medida que el utillaje agéntico infla casi por construcción.
El calendario de Anthropic es el extremo agresivo de la distribución. Dos trimestres hasta 25x es lo que pasa cuando una empresa es a la vez el usuario más intensivo y el proveedor. Su curva será probablemente más plana. Lo transferible es la forma, no la pendiente.
Esto es un problema resuelto, y la solución es antigua. Workers sin estado sobre un diario compartido no es arquitectura nueva; es práctica estándar de sistemas distribuidos que una herramienta interna de crecimiento rápido se saltó, como hacen las herramientas internas de crecimiento rápido. Aquí no hay ninguna técnica novedosa que adquirir, solo una corriente que aplicar antes de que parezca necesario.
El artículo de CI de Anthropic es un buen documento precisamente porque no tiene glamour: un servicio interno se le quedó pequeño al diseño, tres parches competentes compraron cada vez menos tiempo y una reconstrucción de tres semanas lo arregló bien. Todo eso ha pasado en todas las empresas que han crecido rápido alguna vez.
Lo que cambió el código agéntico es el reloj. Un sistema que históricamente habría tardado tres años en quedársele pequeña su arquitectura lo hace ahora en dos trimestres, y las señales de aviso llegan en el mismo orden de siempre, solo que comprimidas hasta el punto en que el instinto habitual —«lo parcheo ahora y lo arreglo bien el trimestre que viene»— se queda sin trimestres siguientes.
Si está entregando más código que hace seis meses, la restricción ya se ha movido aguas abajo de usted. La única pregunta es si se entera por un panel o por una factura.
Fuentes: Anthropic, «Agentic coding is straining CI. Here's how we scaled test impact analysis at Anthropic» de Sachin Malhotra, publicado el 14 de septiembre de 2026 · Anthropic, «How Claude Tag serves as Anthropic's first responder for CI/CD failures» · Analytics India Magazine, «Anthropic's CI Jobs Grew 25x in 6 Months as Claude Wrote 80% of Code» · VentureBeat, «Anthropic says 80% of its new production code is now authored by Claude». Las cifras de 8x, 80%, 10x y 25x, las tres duraciones de los parches, la descripción del rediseño y la recomendación de diseñar para 10-20x son de Anthropic, tal como se publicaron en el artículo de ingeniería; los tiempos del primer respondedor vienen del artículo complementario. Anthropic no publicó los costes de CI: la sección sobre la factura es una inferencia a partir de los recuentos de trabajos, y se señala como tal. El encuadre de la vida media de los parches, la lectura del cuello de botella como algo que se reubica en lugar de despejarse y todas las recomendaciones son míos. Para la estación anterior de la misma línea, vea contratar primero al revisor y después al programador.


IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.