AMD acaba de comprar un chip que ejecuta un modelo y nada más (2026)

By Surya Pratap
8 de agosto de 2026
11 min read
AI & Technology

8 de agosto de 2026
11 min read
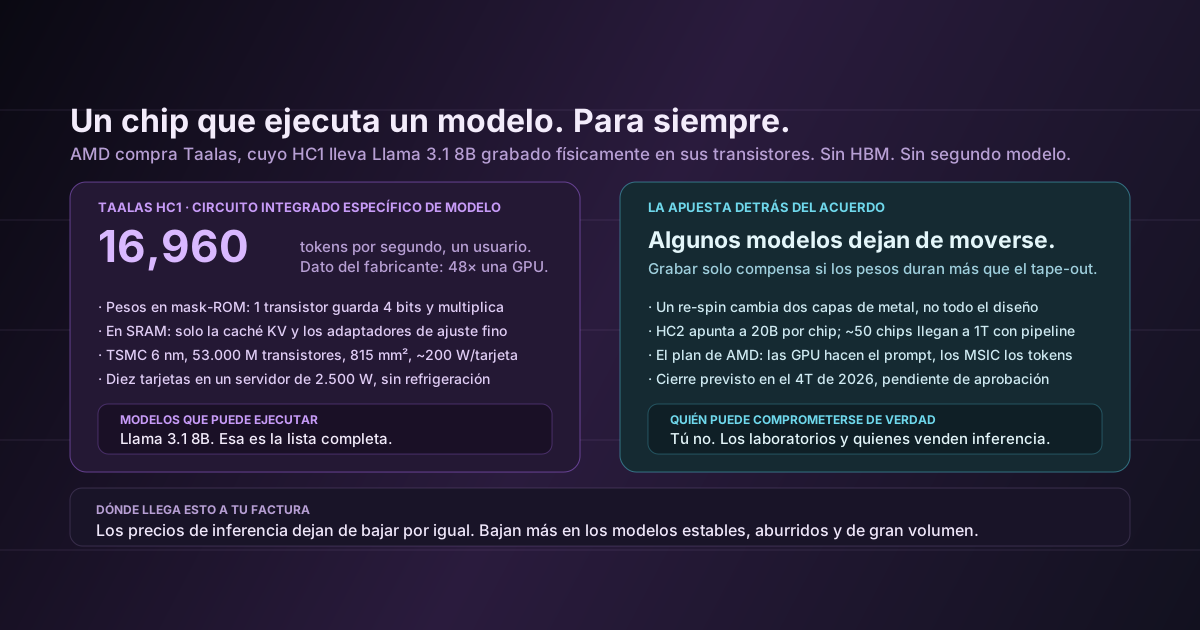
El 6 de agosto, AMD acordó comprar Taalas, una startup de Toronto con tres años de vida que ha levantado 219 millones de dólares para fabricar chips con el modelo incorporado. No optimizados para él. Incorporado. El primer producto de Taalas, el HC1, ejecuta Llama 3.1 8B de Meta, y la razón por la que no puede ejecutar nada más es que los pesos están grabados físicamente en los transistores.
Declara 16.960 tokens por segundo para un solo usuario. Es un dato publicado por el fabricante, así que tómalo como orientativo, pero el múltiplo que reivindica frente a las GPU actuales es de unas 48 veces, una cifra lo bastante grande como para que, incluso con un fuerte descuento, quede algo interesante.
Ayer escribí sobre dos agentes de programación que salieron con un día de diferencia haciendo apuestas opuestas sobre si el harness debía ser portable. Esto es el mismo debate en una capa mucho más baja del stack, y en una versión mucho más extrema. Todo el tooling de IA lleva dos años optimizando la opcionalidad: gateways, routers, capas de abstracción, cambiar de modelo con un cambio de configuración. AMD acaba de gastar dinero de verdad en la apuesta contraria. Merece la pena entenderlo, porque dice algo sobre hacia dónde va la curva de costes.
El nombre de la categoría es circuito integrado específico de modelo, un MSIC, por analogía con el ASIC. El flujo de diseño toma las matemáticas, el enrutamiento y los parámetros de un modelo entrenado y los dispone como lógica fija.
El chip tiene dos regiones. Los pesos viven en un tejido de recuperación mask-ROM donde, según la descripción del fundador Ljubisa Bajic, un solo transistor almacena cuatro bits y realiza la multiplicación asociada a ellos. La SRAM se ocupa de lo que de verdad tiene que cambiar en tiempo de ejecución: la caché KV y los adaptadores de ajuste fino. No hay HBM en ningún sitio, y de eso se trata. En una GPU, la mayor parte de la energía y de la espera se va en mover pesos desde la memoria de alto ancho de banda hasta las unidades de cómputo, una y otra vez, para cada token. Si los pesos ya están dentro de la lógica, ese tráfico no existe.
Las cifras físicas: TSMC de 6 nm, 53.000 millones de transistores en un die de 815 mm², unos 200 vatios por tarjeta. Caben diez tarjetas en un servidor x86 de doble socket dentro de una envolvente estándar de 2.500 vatios, sin refrigeración líquida. Ese último detalle es fácil de pasar por alto y es, posiblemente, el más relevante de todo el anuncio: significa que esto se despliega en racks normales de edificios normales, no en las instalaciones especializadas, limitadas de potencia y con listas de espera de dieciocho meses que necesitan los clústeres de GPU de frontera.
El HC2 de segunda generación, previsto para este verano, apunta a 20.000 millones de parámetros por chip, con paralelismo de pipeline entre aceleradores para crecer: unos 50 chips para llegar a un billón de parámetros. Taalas afirma que grabar un modelo en silicio cuesta unas 100 veces menos que entrenar un modelo de frontera, lo que es una comparación con una cifra enorme y debe leerse como «asequible en relación con un entrenamiento», no como «barato».
El plan declarado de AMD no es sustituir sus GPU. Es desagregar las dos mitades de la inferencia, que nunca han querido de verdad el mismo hardware.
Procesar tu prompt —el prefill— está limitado por el cómputo y es muy paralelo. Se puede trabajar con todos los tokens de entrada a la vez, que es exactamente lo que una GPU hace bien. Generar la respuesta —el decode— está limitado por el ancho de banda de memoria y es obstinadamente secuencial: un token cada vez, y cada uno exige volver a leer todo el conjunto de pesos. Las GPU son ineficientes en esto y siempre lo han sido. Con el plan de AMD, las GPU Instinct se encargan del prompt, los aceleradores de Taalas generan los tokens, y todo encaja en su plataforma a escala de rack Helios junto a EPYC y ROCm. La alternativa que plantea es un ciclo tick-tock: los clientes validan un modelo en GPU Instinct y luego trasladan la carga ya asentada a un MSIC.
También hay una lectura puramente competitiva. El foso de NVIDIA es en buena medida un foso de memoria e interconexión. Un diseño que esquiva por completo la HBM es uno de los pocos ataques posibles que no pasan por superar a NVIDIA en su propio terreno. El acuerdo se cerrará en el cuarto trimestre de 2026, pendiente de aprobación regulatoria, así que nada de esto es inminente.
Esta es la parte en la que merece la pena detenerse. Grabar un modelo en silicio solo tiene sentido económico si los pesos duran más que el tape-out. AMD paga por la tesis de que algunos modelos dejarán de cambiar.
Eso va directamente en contra del relato dominante, incluido el que vengo contando en este blog: que los modelos salen cada mes, que cualquier decisión de enrutamiento queda obsoleta en un trimestre, que hay que construir para que responder a un lanzamiento nuevo sea barato. Todo eso sigue siendo cierto en la frontera. Pero la frontera no es donde está el volumen de tokens.
Piensa en dónde se gasta realmente la inferencia en un producto maduro: clasificación, extracción, reranking, pipelines de embeddings, decisiones de enrutamiento, comprobaciones de guardrails, los pasos intermedios de un bucle de agente que ningún humano lee. Ese trabajo no necesita el modelo de frontera de este trimestre. Necesita un 8B competente que se comporte mañana igual que hoy. Los equipos fijan esos modelos a propósito, porque cambiarlos obliga a revalidar todo lo que viene después. Que Llama 3.1 8B sea el primer objetivo del HC1 no es casualidad: es un caballo de batalla que lleva estable el tiempo suficiente como para acumular una base instalada enorme, aburrida y de gran volumen.
Dos cosas que parecen contradictorias y no lo son
La rotación de modelos se acelera y una gran parte de los tokens de producción se está consolidando en un pequeño número de caballos de batalla congelados. Ambas cosas son ciertas porque describen capas distintas. La frontera se mueve deprisa porque ahí está la competencia; la base se asienta porque revalidar un modelo fijado en todo un sistema de producción es caro y nadie lo hace por gusto.
Un chip atado a un modelo en un mercado que lanza modelos nuevos cada mes suena a forma cara de quedarse obsoleto. Hay tres cosas que lo matizan, y una que no.
Nunca vas a comprar uno de estos. Alquilarás sus consecuencias, y las consecuencias son más concretas que «la inferencia se abarata».
Todas las cifras de este artículo las ha publicado el fabricante, una empresa que todavía no ha lanzado su segundo producto, dentro de un acuerdo que aún no se ha cerrado. Las hojas de ruta de silicio se retrasan, las afirmaciones de rendimiento se comprimen con las pruebas independientes, y las adquisiciones se absorben en líneas de producto y desaparecen sin ruido. Sostén los detalles con la mano abierta.
Sostén la dirección con más firmeza. Durante tres años, todo el stack de IA ha sido blando: todo era un cambio de configuración, todo era intercambiable, la opcionalidad se preservaba en cada capa porque nadie sabía qué iba a importar. El endurecimiento empieza cuando las respuestas dejan de cambiar. Una empresa que graba pesos en ROM está afirmando que partes de esto ya se conocen lo bastante bien como para comprometerse físicamente con ellas, y que una empresa del tamaño de AMD le dé la razón es la verdadera noticia, más que cualquier cifra de rendimiento.
Para un fundador, lo útil no es elegir bando. Es saber qué partes de tu propio sistema son de cada tipo. Lo que seguirás ejecutando dentro de dos años —tu conjunto de evaluación, tu lógica de recuperación, el modelo caballo de batalla que hace el 90 % poco glamuroso de tus tokens— merece tratarse como infraestructura y optimizarse a fondo. La llamada a un modelo de frontera que haces esta semana merece quedarse detrás de un gateway donde cambiarla cueste una tarde. La mayoría de los equipos lo tiene exactamente al revés: se obsesionan con la elección de modelo que quedará obsoleta en un trimestre e improvisan las partes que la sobrevivirán.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.