Dos formas de repartir cinco agentes de código: una desperdicia cuatro y la otra choca el 41,7% de las veces

By Surya Pratap
22 de septiembre de 2026
12 min read
AI & Technology

22 de septiembre de 2026
12 min read
 Reparto redundante y reparto divisivoHover to explore
Este año apareció una categoría de herramientas sin que nadie la bautizara demasiado alto, y lo interesante no es lo que hace bien. Es lo que te deja a ti, en silencio.
Este artículo parte de Orca, el entorno de agentes en paralelo de Stably AI con licencia MIT, y del artículo explicativo de ArshTechPro publicado el 20 de septiembre de 2026; del dataset AgenticFlict de Daniel Ogenrwot y John Businge; del estudio de Xu, Subramanian y Karthik sobre pull requests concurrentes de agentes; y del análisis que Daniel Vaughan hizo de ese estudio. La sección 8 dice de qué cifras me fío y hasta dónde. La distinción entre los dos repartos, el argumento de las costuras y todas las recomendaciones son míos.
El entorno de desarrollo de agentes — ADE, y sí, estamos a una letra de IDE a propósito — es una aplicación de escritorio que no contiene ningún modelo. Contiene una flota.
Orca es la que ha despegado. Tiene licencia MIT, funciona en macOS, Windows y Linux con una aplicación de acompañamiento para el móvil, y su propio eslogan es directo: "Ejecuta Codex, ClaudeCode, OpenCode o Pi en paralelo, cada uno en su propio worktree, todo desde un mismo sitio." Soporta alrededor de treinta agentes CLI con nombre propio y, en la práctica, cualquiera de ellos. Cuando revisé el repositorio el 22 de septiembre rondaba las 75.000 estrellas; las reseñas escritas durante el verano citan cifras más cercanas a 60.000, así que la curva es lo bastante empinada como para que cualquier número que leas ya esté desactualizado.
El mecanismo es una primitiva de git que lleva ahí desde 2015 y que de repente tiene una aplicación estrella:
Una tarea, un worktree. Cada agente recibe su propio directorio de trabajo compartiendo el mismo almacén de objetos: un sistema de archivos real, una rama real, sin stash.
Un worktree, una terminal. La sesión del agente, sus tests y su servidor de vista previa quedan acotados a ese directorio.
Sin peleas por .git/index.lock. El fallo en el que dos agentes escriben en el mismo directorio y se corrompen mutuamente sencillamente no puede ocurrir.
Diffs que puedes anotar. Dejas comentarios en markdown sobre líneas concretas del diff, los agrupas y se los devuelves al agente como feedback.
Esto es buena ingeniería y resuelve una molestia auténtica. Si alguna vez has querido empezar una segunda tarea mientras un agente se pelea con la primera, sabes exactamente qué problema se está resolviendo aquí.
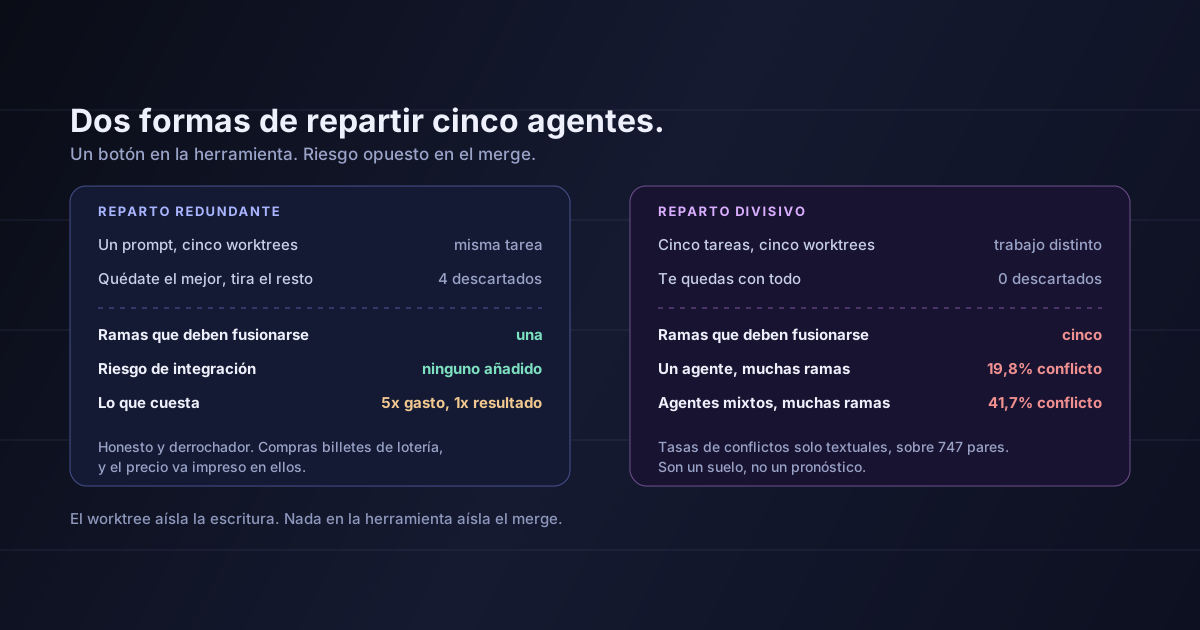
El worktree aísla la escritura. Nada en la herramienta aísla el merge.
Aquí está lo que me hizo querer escribir esto. La herramienta ofrece un solo gesto — reparte esto entre cinco agentes — y ese gesto único cubre dos operaciones completamente distintas.
El reparto redundante es la demo. Un prompt, cinco agentes, cinco worktrees, cinco intentos de la misma tarea. Lees los cinco diffs, te quedas con el mejor y borras cuatro ramas. El propio texto de Orca lo describe: reparte un prompt entre cinco agentes, compara los resultados y fusiona el ganador.
El reparto divisivo es aquello a lo que acabas pasando. Cinco tareas distintas, cinco worktrees, cinco agentes, y al final quieres las cinco. No se descarta nada, porque descartar nunca fue la idea: la idea era hacer cinco cosas en el tiempo de una.
En la interfaz son iguales. Son opuestos.
| Reparto redundante | Reparto divisivo | |
|---|---|---|
| Qué varía | El agente o la semilla | La tarea |
| Ramas que conservas | Una | Todas |
| Ramas que deben fusionarse | Una | Todas |
| Riesgo de integración añadido | Ninguno | El tema de este artículo |
| Lo que pagas | N× gasto por 1× resultado | N× gasto por N× resultado, menos conflictos |
El reparto redundante es un billete de lotería con el precio bien puesto. Gastas cinco veces para obtener un resultado y sabes desde el principio que cuatro quintas partes del gasto se tiran. El reseñador citado en la cobertura lo dice sin rodeos: ejecutar Claude Code tres veces en paralelo consume tres veces tu cuota. No hay coste oculto porque el desperdicio es precisamente la parte visible.
El reparto divisivo es donde vive el coste oculto. Parece más ahorrador — ¡no se descarta nada! — y por eso justamente la gente se pasa a él, normalmente en la primera semana tras instalar la herramienta.
Hay tres trabajos empíricos de 2026 que tocan este punto y, leídos juntos, cuentan una historia coherente.
¿Cómo de habitual es ya el trabajo concurrente de agentes?
Xu, Subramanian y Karthik revisaron 33.596 pull requests escritas por agentes en 2.807 repositorios. Con solapamiento temporal exacto, el 79,4% de las PR de agentes estaba activo a la vez que otra PR de agente, en el 40,2% de los repositorios. Si se amplía la ventana a una semana, son el 95% de las PR en el 53,4% de los repositorios.
El reparto divisivo no es una práctica de vanguardia que alguien podría probar. Es la condición por defecto de cualquier repositorio con agentes dentro.
¿Con qué frecuencia choca ese trabajo?
El dataset AgenticFlict de Daniel Ogenrwot y John Businge es el amplio: más de 142.000 pull requests de agentes procedentes de más de 59.000 repositorios, de las cuales más de 107.000 se reprodujeron mediante simulación determinista de merge. El resultado: el 27,67% — más de 29.000 PR — produjo conflictos textuales de merge, repartidos en más de 336.000 regiones de conflicto distintas.
La comparación que le da filo: los estudios previos sobre pull requests escritas por personas suelen situarse en la franja del 10–20%. Las contribuciones de agentes están chocando entre una vez y media y dos veces y media más que las humanas.
¿Importa qué agentes sean?
Este es el hallazgo que reencuadra el producto. Xu y sus colegas hicieron simulaciones de merge sobre 747 pares de PR y los separaron:
La función estrella es el peor caso
Los pares de agentes distintos chocaron aproximadamente al doble que los del mismo agente. La capacidad que encabeza cualquier ADE — ejecuta Claude Code y Codex y Cursor a la vez, porque para qué ser fiel a uno solo — es, en modo divisivo, la configuración que menos le gusta a los datos. Dos agentes entrenados de forma distinta, arrancados desde archivos de sistema distintos y con opiniones distintas sobre nombres, estructura de archivos y dónde debe vivir un helper van a discrepar estructuralmente de formas en las que dos ejecuciones del mismo agente en general no lo hacen.
Conviene decirlo con honestidad: en la práctica, el solapamiento entre agentes distintos sigue siendo raro — solo el 0,5% de los pares concurrentes implicaba agentes diferentes, en 122 de 2.807 repositorios. La cifra del 41,7% es lo que ocurre si lo haces, medido sobre una muestra pequeña. Y toda la propuesta de valor del ADE consiste en hacer fácil precisamente eso que era raro.
Desglosa qué son esos conflictos en realidad y el cuadro deja de ir sobre control de versiones. Según el análisis que Vaughan hizo del estudio, los pares en conflicto se reparten en tres:
| Clase de conflicto | Proporción | Qué significa en realidad |
|---|---|---|
| Solapamiento textual | 57,6% | Dos agentes editaron las mismas líneas. Un fallo de reparto: pusiste a dos personas en un solo escritorio |
| Modificar / borrar | 26,8% | Un agente cambió algo que el otro borró. Una decisión de arquitectura que nadie tomó, tomada dos veces y distinta |
| Añadir / añadir | 15,1% | Ambos agentes crearon el mismo archivo. Un fallo de especificación: a ninguno le dijeron que el otro lo necesitaría |
Solo el primero es un problema de merge. Los otros dos — alrededor del 42% juntos — son estructurales, no se pueden resolver mecánicamente y en realidad no son conflictos entre ramas. Son conflictos entre dos planes, descubiertos en el peor momento posible: cuando ambos planes ya están completamente implementados.
Un conflicto de añadir/añadir es especialmente revelador. Dos agentes concluyeron por separado que hacía falta un archivo, se lo inventaron y ninguno sabía del otro. Ninguna cantidad de herramientas de merge arregla eso. El arreglo está aguas arriba, en lo que les dijiste.
Y fíjate dónde caen estos conflictos: el 84,4% de los archivos en conflicto era código fuente, no archivos de bloqueo ni manifiestos de dependencias. No es el conflicto tedioso pero mecánico que resuelves quedándote con la versión del otro. Es del tipo en el que tienes que entender las dos partes.
Esta es la parte que subrayaría si solo pudiera quedarme con un párrafo.
Todas esas tasas son de conflictos únicamente textuales. Los autores lo dicen sin ambigüedad: las cifras son un límite inferior conservador que excluye los fallos de compilación y los conflictos semánticos. Es decir, miden los casos en los que git se detuvo y te avisó.
El caso peligroso es el otro.
El conflicto que fusiona limpio
Dos agentes en dos worktrees. Uno renombra una función y actualiza todas las llamadas que alcanza a ver. El otro añade una llamada nueva, en un archivo que el primero nunca abrió, usando el nombre antiguo. Archivos distintos. Ninguna línea solapada. Git lo fusiona sin rechistar — y ahora tienes una rama que no compila o, peor, una que sí. Cambia una regla de validación en una rama y confía en la regla vieja en la otra: obtienes CI en verde y un bug que aparece en producción quince días después. No existe un marcador de conflicto para "estos dos cambios discrepan sobre qué es verdad".
Los worktrees aíslan a nivel de sistema de archivos. No coordinan a nivel semántico, y dos ramas pueden tocar archivos completamente disjuntos y aun así contradecirse: a través de tablas de rutas, exportaciones agregadas, definiciones de tipos compartidas, configuración, esquemas de base de datos o una simple suposición sobre cómo se comporta algo.
Así que la lectura honesta del 27,67% es: esa es la proporción en la que el problema se anunció solo. Nadie ha medido la proporción en la que no lo hizo, y no es cero.
Aquí está el replanteamiento sobre el que yo construiría, y no va de herramientas en absoluto.
Todo ADE te invita a responder a la pregunta ¿cuántos agentes debería ejecutar? con un número sacado de tu presupuesto o de tu máquina. Cinco suena bien. Cinco es lo que enseña el marketing. Pero la restricción real no tiene nada que ver con la cuota:
Puedes ejecutar en paralelo tantos agentes como costuras tenga tu código: fronteras a ambos lados de las cuales se pueden escribir dos cambios sin necesidad de verse.
Una costura es un módulo con una interfaz estable, un servicio detrás de un contrato de API, una migración que solo añade, un componente que nadie más importa. Si tu código tiene cuatro costuras auténticas, cuatro agentes es el techo. Ejecutar ocho significa que cuatro de ellos están escribiendo contra suposiciones que los otros cuatro están cambiando a la vez, y descubrirás cuáles en el momento del merge, a las tasas de arriba.
Esto explica algo que de otro modo parece una paradoja: los equipos con un código bien factorizado cuentan que los agentes en paralelo funcionan de maravilla, los equipos con un código enredado cuentan un caos, y ambos ejecutan exactamente el mismo software. La variable no es la herramienta. Es el número de costuras.
También da la respuesta honesta a ¿deberíamos adoptar esto? Si tienes tres costuras, comprar un gestor de flotas para doce agentes es comprar una capacidad que no puedes usar. El trabajo que desbloquea el paralelismo es el mismo trabajo aburrido de modularidad de siempre, lo cual es una conclusión poco satisfactoria y, creo, cierta.
Cinco cosas, en orden, y ninguna exige que dejes de usar ninguna herramienta que te guste.
No necesitas un estudio; necesitas git merge-tree. Coge las ramas que produjeron tus agentes el último mes, reprodúcelas por pares contra su base común de merge y cuenta cuántas chocan. Ese número es tuyo: refleja la estructura de costuras de tu código, no la media del sector. Si queda bastante por debajo del 19,8%, tu reparto es mejor que el típico y puedes abrir más el abanico. Si supera el 40%, añadir agentes es añadir retrabajo.
Una simulación de merge es lo bastante barata como para lanzarla en un hook cada vez que un agente escribe un archivo. Que dos agentes vayan hacia las mismas líneas es una información valiosísima en el minuto tres y casi inservible en la hora dos, cuando ambos ya han construido encima del choque.
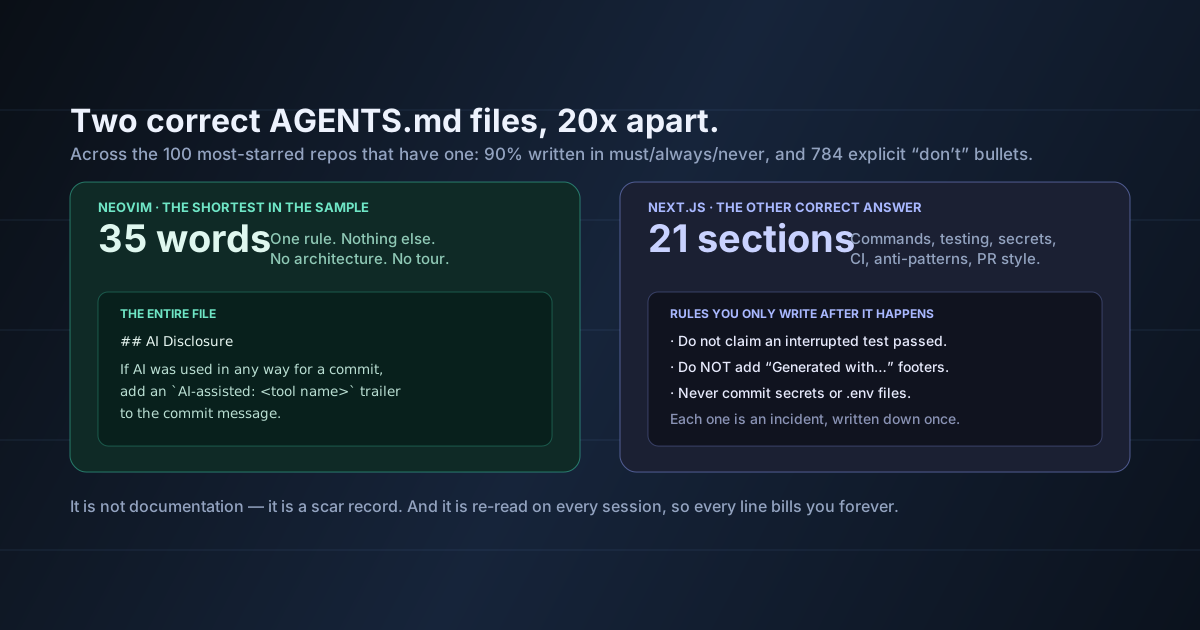
Antes de un reparto, nombra qué rutas puede tocar cada tarea — y trata que un agente salga de su conjunto como señal de que la tarea estaba mal acotada, no como algo que dejar pasar. AGENTS.md es el sitio adecuado para las fronteras que se mantienen entre tareas; mira qué escriben de verdad los mejores repositorios en el suyo.
Aterriza una rama, haz rebase de la siguiente sobre la nueva base y, cuando haya conflicto, dale al agente la base rebasada y déjale rehacer el cambio en vez de resolver a mano un conflicto entre dos cosas que no escribiste tú. Que el agente resuelva su propio trabajo contra la realidad actual es mejor desenlace que arbitrar tú entre dos planes en los que no participaste.
19,8% frente a 41,7% es la decisión más barata de todo este artículo. Guarda la comparación entre varios agentes para el reparto redundante, donde eliges un ganador y descartas el resto: allí la divergencia de estilo es justamente el objetivo y no te cuesta nada, porque solo aterriza una rama.
La regla general que hay debajo de las cinco:
Usa muchos agentes cuando vayas a quedarte con un resultado y un agente cuando vayas a quedarte con muchos. El ADE convierte ambas cosas en un solo clic, y precisamente por eso la distinción tiene que vivir en tu cabeza.
747 pares es una muestra pequeña y el intervalo entre agentes distintos es ancho. La cifra del 41,7% arrastra un intervalo de confianza del 95% de 33,1 a 50,9%. La dirección — entre agentes distintos es bastante peor que dentro de un mismo agente — es el hallazgo sobre el que yo actuaría. El segundo decimal no.
El 27,67% de AgenticFlict no es una predicción para tu repositorio. Es una tasa poblacional sobre 59.000 repositorios con estructuras, culturas de revisión y usos de agentes radicalísimamente distintos. Un código bien factorizado con tareas bien acotadas quedará muy por debajo. Es un motivo para medir, no un número con el que planificar.
La referencia humana del 10–20% viene de otros estudios con otros métodos. Compararlos es útil en cuanto a dirección y no es un experimento controlado. Las PR de agentes además suelen ser más grandes y producirse más deprisa, y parte de la brecha seguro que es eso y no algo intrínseco a los agentes.
No estoy diciendo que el ADE sea una mala herramienta. El aislamiento por worktree es sencillamente correcto, y el bucle de anotar y devolver al agente es lo mejor de la categoría. Mi argumento va sobre la distancia entre lo que resuelve y lo que un fundador supone que resuelve, no sobre la calidad de lo que hace.
Las estrellas no son adopción y desde luego no son retención. 75.000 estrellas en una categoría que se mueve rápido te dice que llegó la atención. No te dice nada sobre cuántos de esos repositorios la siguen usando en marzo.
Nada de esto está medido sobre los conflictos semánticos, tampoco por mí. He argumentado que existen y que las tasas publicadas, por tanto, subestiman el problema. No puedo decirte cuánto, y de momento nadie puede.
Ejecutar agentes de código en paralelo dejó de ser un problema difícil este año. Worktrees aislados, un clic, treinta agentes soportados, licencia MIT, funciona desde el móvil. Esa parte está terminada.
Aterrizar lo que producen no lo está, es medible y claramente más difícil que aterrizar trabajo humano, y es la mitad que ningún ADE dice resolver, porque no se puede resolver dentro de la herramienta. Depende de cómo esté factorizado tu código y de con cuánta precisión acotaste las tareas, y ambas cosas eran tu trabajo antes de que existiera nada de esto.
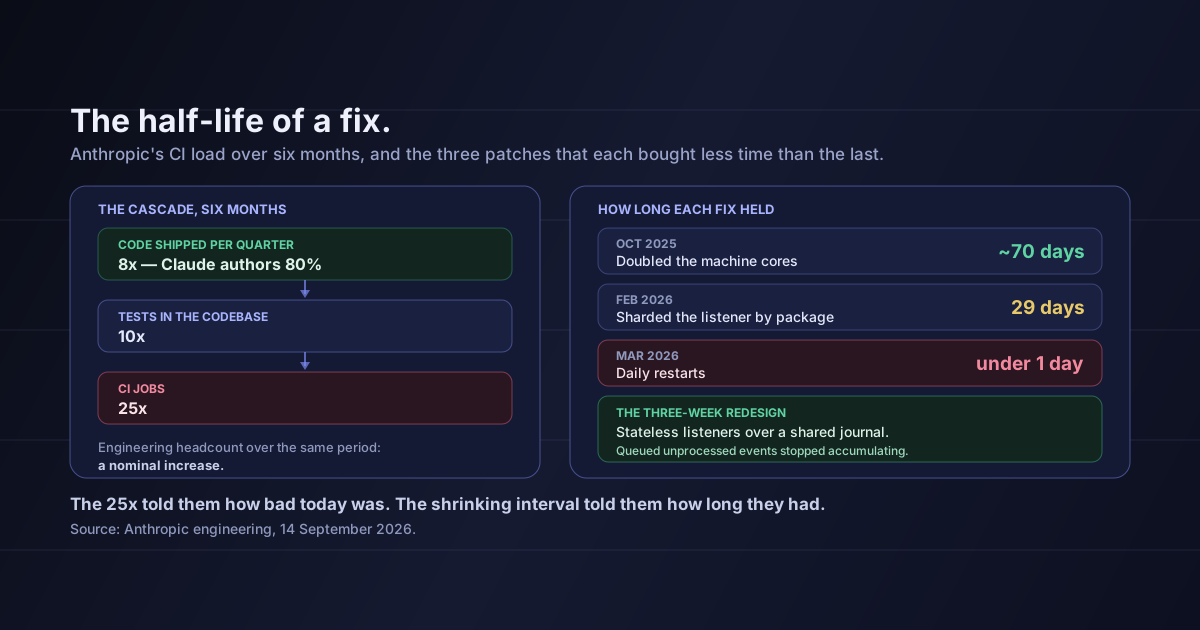
El patrón es el que no deja de repetirse en la ingeniería con agentes: el cuello de botella no desaparece, se mueve, y se mueve hacia lo que todavía exige criterio. La generación se volvió paralela. La integración no, y la integración es donde está el criterio.
Antes de abrir más el abanico, cuenta tus costuras. Si el número es menor que el de agentes que ibas a ejecutar, no estás comprando rendimiento: estás comprando conflictos de merge a una tasa documentada, y pagando el precio completo por agente por ese privilegio.
Fuentes: Orca en GitHub — la licencia MIT, la lista de agentes soportados, el modelo de aislamiento por worktree, la descripción de repartir un prompt entre cinco agentes y el recuento de estrellas a 22 de septiembre de 2026. ArshTechPro, "Orca Explained", 20 de septiembre de 2026 — el encuadre del ADE, la estructura de worktree más terminal más vista previa, el bucle de anotación de diffs y la nota de que los agentes en paralelo multiplican el consumo. Ogenrwot y Businge, "AgenticFlict" — las 142.000 pull requests, los 59.000 repositorios, las 107.000 simulaciones de merge, la tasa del 27,67% de conflictos textuales, las 336.000 regiones de conflicto y la referencia humana del 10–20% procedente de trabajos previos. Xu, Subramanian y Karthik, "AI Agent Pull Requests on GitHub" — las 33.596 PR en 2.807 repositorios, las cifras de concurrencia del 79,4% y el 95%, la simulación sobre 747 pares, las tasas del 19,8% y el 41,7% con sus intervalos de confianza, el 0,5% de pares entre agentes distintos y el 84,4% de archivos de código fuente. Daniel Vaughan, "When Agents Collide", 28 de julio de 2026 — la taxonomía de conflictos 57,6% / 26,8% / 15,1% y la observación de que el aislamiento por worktree evita las colisiones de directorio pero no los conflictos de merge. La distinción entre reparto redundante y divisivo, la correspondencia entre las clases de conflicto de git y los fallos de reparto, arquitectura y especificación, el argumento de las costuras y todas las recomendaciones de la sección 7 son míos. Para el argumento de que el cuello de botella se mueve, mira las cifras de CI de Anthropic, y sobre quién debería revisar todo este trabajo, contrata antes al revisor que al programador.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.