Microsoft puso a trabajar 1024 agentes de código sin jefe. Multiplicar los agentes por 128 dio 9,5 puntos

By Surya Pratap
29 de septiembre de 2026
9 min read
AI & Technology

29 de septiembre de 2026
9 min read
 Más agentes, sobre todo antesHover to explore
Lo habitual al ejecutar muchos agentes de código es poner a uno al mando: un planificador divide el trabajo y lo reparte. Ese planificador se convierte en el cuello de botella en cuanto hay más trabajadores de los que puede seguir. Un artículo de Microsoft Research publicado la semana pasada lo elimina por completo y escala el resultado hasta 1024 agentes. El diseño merece estudiarse. Las cifras del titular hay que leerlas con cuidado.
Todo lo que sigue procede de «Agensh: Scaling Organizational Intelligence to 1,024 Agents», de Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia y Furu Wei, de Microsoft Research, publicado en arXiv el 22 de septiembre de 2026. Es un preprint y no ha pasado revisión por pares. La lectura a partir de la sección 3 es mía.
ProgramBench entrega a un agente un programa compilado y le pide reconstruir el software desde cero —un código completo que compile y se comporte igual— en seis horas y sin acceso a internet. La puntuación es la proporción de pruebas ocultas que supera el programa reconstruido.
Agensh se probó en las cinco tareas más difíciles de las 200 de ProgramBench, elegidas por lo mal que las resuelven los modelos actuales. Abarcan procesamiento multimedia, simulación molecular, conversión de documentos, interpretación de lenguajes e indexación de código. Todos los trabajadores usaron el mismo modelo, GPT-5.6-sol con esfuerzo de razonamiento alto.
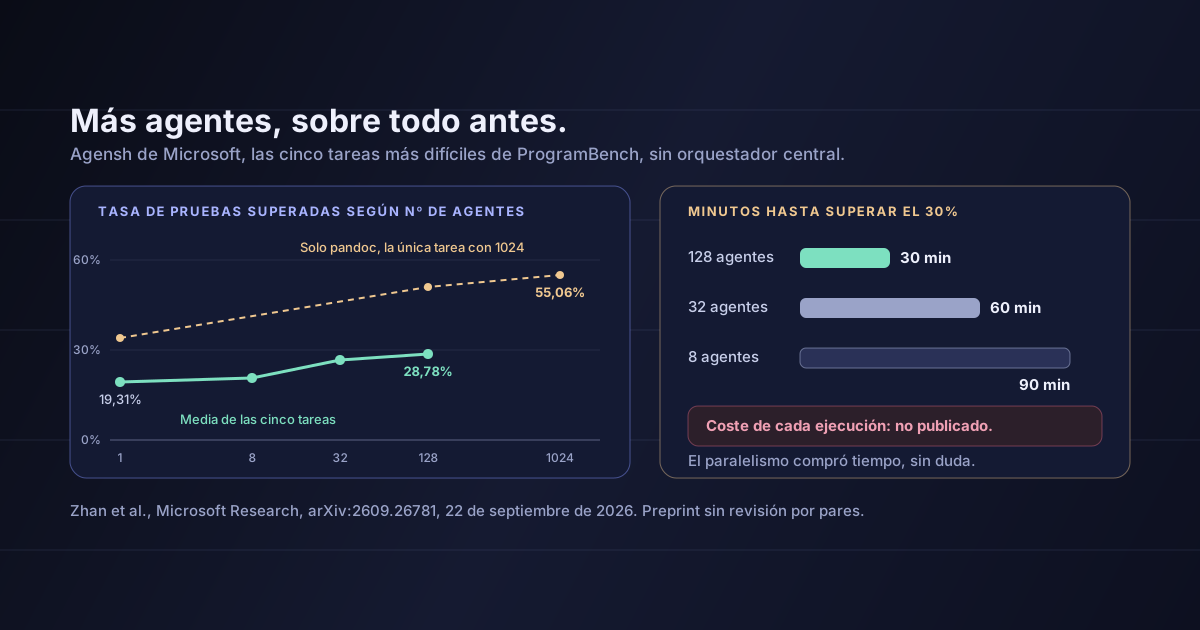
Tasa media de pruebas superadas en las cinco tareas:
| Agentes | Tasa media de pruebas superadas | Cambio respecto a la fila anterior |
|---|---|---|
| 1 | 19,31% | — |
| 8 | 20,68% | +1,37 puntos |
| 32 | 26,52% | +5,84 puntos |
| 128 | 28,78% | +2,26 puntos |
De 1 agente a 128 son unos 9,5 puntos, lo que los autores describen como una mejora relativa de aproximadamente el 49%.
Solo una tarea, el conversor de documentos pandoc, se ejecutó con los 1024 agentes completos:
Ocho veces más agentes que en la ejecución de 128 añadieron unos 4 puntos en la única tarea en que se probó.
La curva sube. Sube despacio, y cada paso cuesta muchos más agentes que el anterior.
La cifra más práctica del artículo no es la puntuación final, sino lo rápido que cada configuración llegó a algo útil. Los autores indican que 128 agentes superaron una tasa de pruebas superadas del 30% a los 30 minutos. Con 32 agentes tardaron 60 minutos, y con 8, 90.
Eso es lo que el paralelismo compra con seguridad: llegar antes a un nivel dado. El techo también se movió, pero poco. El tiempo hasta un nivel funcional se movió mucho.
Para un fundador, la distinción importa. Si lo que pagas es un plazo más corto para un trabajo que, si no, podrías esperar, más agentes son una compra de latencia, y eso se puede presupuestar. Si esperas que más agentes resuelvan problemas que un solo agente no puede, este artículo indica que el efecto existe, pero es pequeño en relación con el número de agentes añadidos.
El diseño es la parte que merece copiarse, y es más sencillo de lo que sugiere la escala. Hay tres piezas compartidas:
Un espacio de trabajo compartido. Un servidor git. Cada trabajador tiene su propia copia y su rama, y fusiona en una rama principal. Git registra quién cambió qué y detecta los conflictos de fusión. Si una fusión queda bloqueada, el trabajador incorpora lo último de los demás, resuelve el conflicto y vuelve a fusionar.
Una interfaz de mensajes. Canales compartidos por tarea más mensajes directos, entregados de forma asíncrona y con historial, para que los trabajadores acuerden quién se encarga de qué y desenreden dependencias.
Un contexto compartido. Un registro de solo anexado con entradas tipadas —OBSERVED, FACT, FAIL, CLAIM, PATCH_SUMMARY— en el que cualquier trabajador puede buscar. Antes de empezar, cada trabajador publica un CLAIM que describe el alcance que asume.
Cada trabajador ejecuta el mismo ciclo: leer el contexto compartido, reclamar una parte del trabajo, hacerla, comprobarla contra los criterios de aceptación de esa parte, fusionar y publicar qué cambió y por qué. No hay bloqueos. El solapamiento se gestiona con reclamaciones y conversación.
Un detalle muestra dónde está el coste real de la coordinación. Para reducir las disputas sobre quién se encarga de qué, los autores no arrancaron todos los agentes a la vez. Arrancaron uno cada 30 segundos durante la primera hora y, después, uno cada 3 segundos. Incluso con todo el diseño basado en la autoorganización, hubo que gestionar la llegada.
Los autores también describen comportamientos que surgieron al crecer el grupo: con 8 agentes, los trabajadores acordaron una interfaz y la implementaron cada uno por su lado; con 128, eligieron revisores según quién había trabajado en código relacionado; con 1024, varios trabajadores asumieron la integración y otros retomaron tareas que otros habían abandonado.
El artículo no publica cuánto costó ninguna de estas ejecuciones: ni totales de tokens, ni gasto en API, ni cómputo por punto ganado. Da los límites por trabajador —hasta 272.000 tokens de entrada y 128.000 de salida— y un presupuesto de seis horas, y nada más.
Eso importa porque la afirmación sobre el escalado es en realidad una afirmación sobre el precio. «128 veces más agentes por 9,5 puntos» solo es un buen trato si sabes cuánto cuestan 128 veces más agentes. Sin eso, los resultados muestran que más agentes pueden ayudar, no que merezcan la pena. No voy a estimar el coste a partir de los límites de tokens. Los trabajadores no gastan necesariamente todo su margen, y una estimación parecería más precisa de lo que es.
La pregunta que hay que hacer a cualquier resultado de escalado de agentes
No «¿subió la puntuación?», sino «¿cuántos puntos por dólar en cada paso, y cuántos minutos ahorrados?». Esas son las dos cifras que deciden si merece la pena pagar la siguiente duplicación.
No necesitas 1024 agentes para usar este diseño. Casi todo es útil en cuanto ejecutas más de uno.
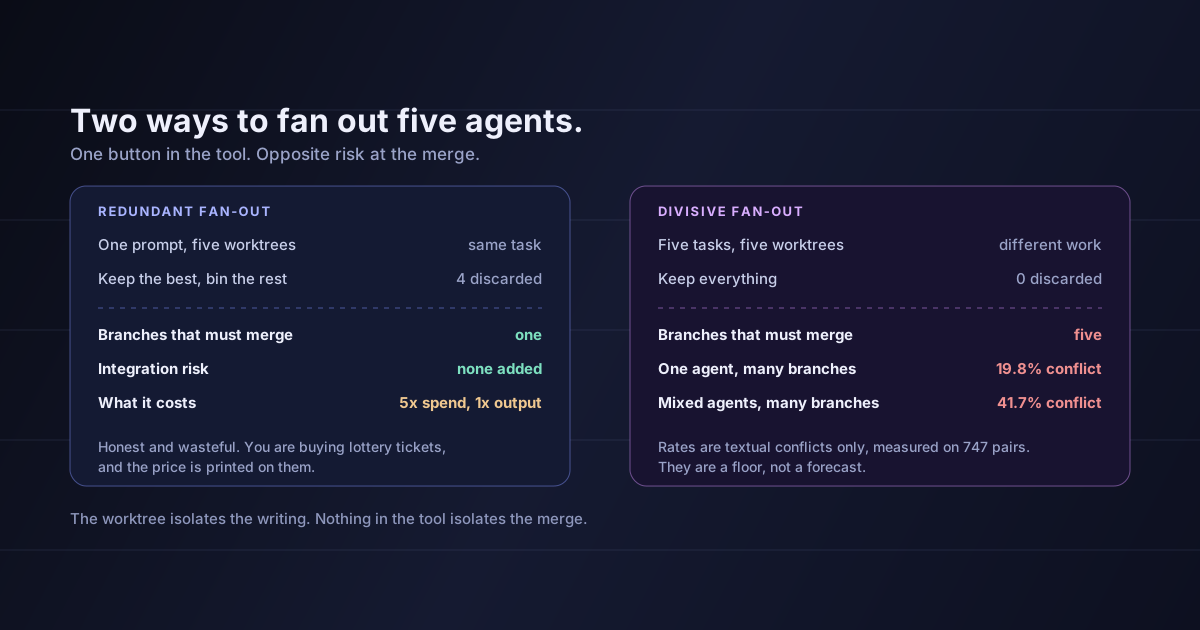
Cada agente anota qué asume antes de empezar. Nuestro análisis anterior sobre repartir el trabajo entre cinco agentes de código concluyó que aislar a los agentes es la parte fácil y que integrar su trabajo es donde chocan: un estudio de 2026 encontró conflictos de fusión textuales en el 27,67% de las pull requests de agentes. Una reclamación visible, hecha antes de empezar, es la forma más barata de reducir tanto los choques como el trabajo duplicado.
Una entrada FAIL ahorra a todos los agentes posteriores repetir un callejón sin salida. Es la línea más valiosa del registro y la que la mayoría de las configuraciones no guarda.
Ramas privadas, una rama principal, y que cada conflicto lo resuelva el agente que lo provocó. Ya tienes esa infraestructura, y ya registra quién hizo qué.
Los trabajadores de Agensh comprueban su trabajo contra los criterios de la subtarea antes de fusionar. Sin ellos, «terminado» significa lo que el agente decida.
Si Microsoft tuvo que espaciar los arranques a esta escala, cinco agentes que leen a la vez la misma lista de tareas vacía también chocarán. Un pequeño retraso entre arranques no cuesta nada.
Registra cuánto se tarda en llegar a «suficientemente bueno» con 1, 2 y 4 agentes en tu propio trabajo. Eso, junto con el coste, te dice dónde dejar de añadir agentes.
Es un preprint. No ha pasado revisión por pares, y los resultados son de un solo equipo en un solo banco de pruebas.
Son cinco tareas y un modelo. Y solo una tarea se ejecutó con 1024 agentes. El patrón puede no mantenerse con otras tareas u otros modelos.
No hay comparación con un orquestador. El artículo sostiene que un orquestador central limita la cooperación, pero no compara Agensh con un sistema orquestado en las mismas tareas. Por este artículo no sabemos si eliminar al jefe es lo que produjo las mejoras.
No he encontrado datos de varianza. No puedo comprobar con lo publicado si el paso de 32 a 128 agentes es mayor que el ruido entre ejecuciones.
ProgramBench tiene una clave de respuestas inusualmente clara. Los agentes pueden ejecutar el programa de referencia y comparar resultados en cualquier momento. La mayor parte del trabajo real de software no tiene ese oráculo, y verificar es mucho más difícil. El diseño podría escalar peor cuando «correcto» es cuestión de criterio.
El coste es desconocido. La sección 5 es una queja sobre datos que faltan, no una conclusión de que las mejoras sean demasiado caras.
Agensh demuestra que los agentes de código pueden coordinarse a una escala en la que un jefe central no daría abasto, con una infraestructura que la mayoría de los equipos ya tiene: git, un canal de mensajes y un registro compartido. Ese diseño es útil con cinco agentes, y casi todo se adopta gratis.
El resultado de escalado es más modesto que su titular. Pasar de 1 agente a 128 añadió unos 9,5 puntos en las tareas más difíciles. Pasar de 128 a 1024 añadió unos 4 en la única tarea en que se probó. La mejora más clara fue la velocidad. Y el artículo omite la única cifra que diría si algo de esto merece pagarse.
Copia esta semana el registro de reclamaciones y el de fallos. Antes de añadir más agentes, mide qué aporta cada uno, en minutos y en dinero.
Fuente: Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia y Furu Wei, «Agensh: Scaling Organizational Intelligence to 1,024 Agents», Microsoft Research, arXiv:2609.26781v1, 22 de septiembre de 2026: la configuración de ProgramBench, la selección de las cinco tareas, el modelo y los límites de tokens, las tasas medias de pruebas superadas del 19,31%, 20,68%, 26,52% y 28,78%, las cifras de pandoc del 33,89%, 50,94% y 55,06%, la mejora relativa de aproximadamente el 49%, los tiempos de 30, 60 y 90 minutos hasta el umbral, los tres componentes de la infraestructura y las entradas tipadas del contexto, el calendario de arranque escalonado y los comportamientos emergentes, todo tal como se publica ahí. Las diferencias en puntos de la sección 2 son cálculos míos a partir de esas cifras. Las lecturas de las secciones 3 a 6 son mías. Sobre la cuestión previa de cómo repartir el trabajo entre unos pocos agentes de código, ver dos formas de repartir el trabajo entre cinco agentes de código. Sobre por qué un agente que lo lee todo cuesta más de lo que parece, ver cada archivo que lee tu agente se queda en la factura.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.