Os inquiridos de IA disseram que 98% sabiam a resposta. Entre pessoas reais, 52%. Não valides a tua startup com utilizadores sintéticos

By Surya Pratap
1 de outubro de 2026
9 min read
MVP Strategy

1 de outubro de 2026
9 min read
 Confiantes, moderados e erradosHover to explore
Cada vez mais fundadores validam ideias sem falar com ninguém. Descrevem o cliente-alvo a um modelo de linguagem, geram umas centenas de «utilizadores sintéticos» e perguntam-lhes se comprariam. As respostas chegam depressa, saem baratas e vêm cheias de certeza. A Pew Research testou agora essa mesma ideia contra pessoas reais, com cuidado, e o problema é precisamente essa certeza.
Os números vêm de dois relatórios do Pew Research Center publicados a 30 de setembro de 2026 por Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer e Aaron Smith: «Can AI stand in for human survey takers? Not really» e «How synthetic polling results change based on the AI model». A Pew estudou sondagens de opinião pública, não investigação de produto. Aplicar os resultados aos fundadores é leitura minha, a partir da secção 3.
A Pew gere o American Trends Panel, um grande painel de adultos americanos reais que inquire repetidamente. Para este estudo, criou um «gémeo digital» de cada membro do painel: deu-se a um modelo de IA os dados demográficos da pessoa e as respostas dela a um inquérito anterior de tipologia política, e pediu-se-lhe que respondesse a novos inquéritos como essa pessoa responderia.
Os gémeos responderam a três inquéritos reais do início de 2026, cerca de 300 perguntas no total, com a mesma redação e as mesmas instruções que os humanos. Depois, a Pew comparou as respostas dos gémeos com as das pessoas reais. O modelo principal foi o Claude Opus 4.6, da Anthropic. Um segundo relatório repetiu o exercício com o GPT-5.1, da OpenAI.
Este é quase o melhor cenário possível para inquiridos sintéticos. Cada gémeo foi construído a partir das próprias respostas detalhadas de uma pessoa real, não de uma descrição curta de persona.
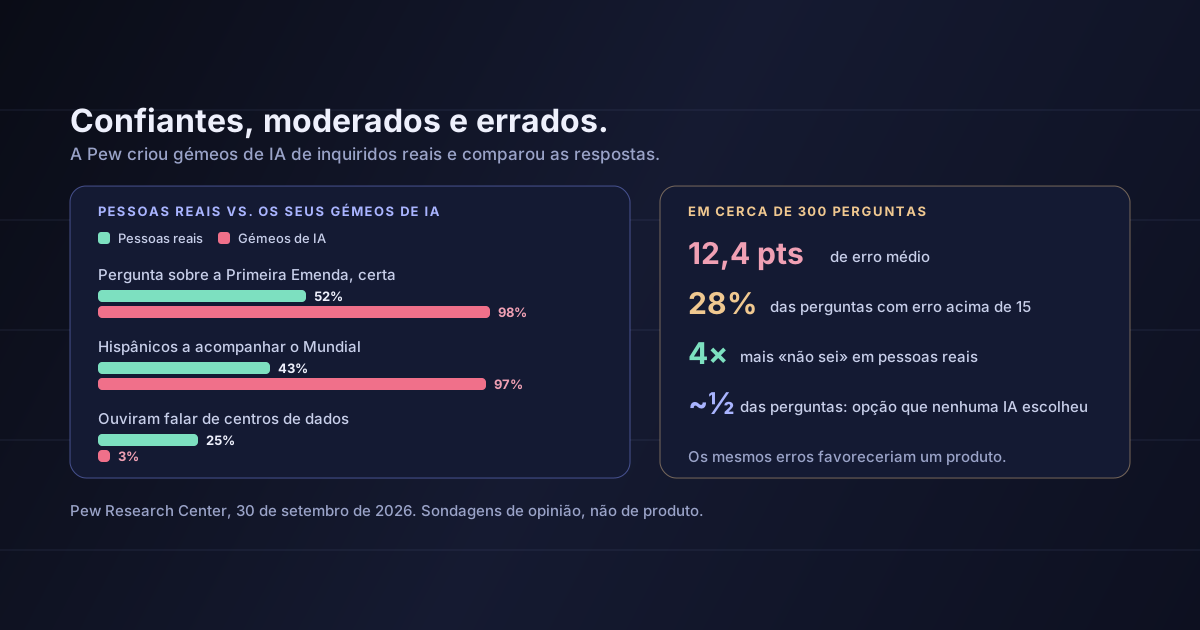
Nos três inquéritos, as respostas da IA desviaram-se das reais 12,4 pontos percentuais em média. Em cerca de 28% das perguntas o erro foi superior a 15 pontos, e diferenças de 20 a 40 pontos em respostas concretas eram comuns.
Alguns exemplos mostram a forma dos erros:
A conclusão da Pew: os modelos de IA «não são um substituto adequado» para inquirir pessoas reais sobre temas de grande importância, e os seus resultados «diferem de formas muitas vezes imprevisíveis».
Os gémeos foram construídos com as próprias respostas das pessoas reais e, mesmo assim, discordaram delas doze pontos em média.
A Pew encontrou padrões consistentes na forma como a IA errava. Cada um corresponde a algo que os fundadores se sentem tentados a perguntar a utilizadores sintéticos.
Sabem demasiado. Os gémeos de IA acertaram as perguntas de conhecimento muito mais vezes do que as pessoas reais: 98% contra 52% numa delas. Um cliente sintético vai perceber a tua categoria, o teu jargão e a tua proposta de valor. A maioria dos teus clientes reais não, e é nessa diferença que os produtos falham.
Raramente têm dúvidas. As pessoas reais escolheram «não sei» cerca de quatro vezes mais do que a IA. Na investigação de clientes, «não sei, nunca pensei nisso» é muitas vezes a resposta mais importante que podes obter. Os utilizadores sintéticos quase nunca a dão.
Saltam os extremos. Em quase metade das perguntas, pelo menos uma opção de resposta não foi escolhida por nenhum inquirido de IA. Quem nunca compraria, e o pequeno grupo que compraria amanhã, são exatamente os que uma amostra sintética deixa de fora.
Fazem o papel do estereótipo. Os gémeos de IA responderam como a caricatura do seu grupo: 97% dos gémeos hispânicos acompanhavam o Mundial contra 43% na realidade, 95% dos gémeos republicanos viam Israel com bons olhos contra 58%. Descreve o teu cliente ideal e o modelo vai responder como o cliché desse cliente.
A quinta falha é a que mais importa para tudo o que é novo. Os maiores erros foram em acontecimentos recentes — a pergunta sobre centros de dados falhou por 22 pontos —, apesar de o modelo ter acesso a tendências anteriores. Uma categoria de produto nova é, por definição, algo com que as pessoas reais ainda não se cruzaram. É exatamente a situação em que as respostas sintéticas são menos fiáveis.
O segundo relatório da Pew correu os mesmos gémeos digitais em dois modelos diferentes. Discordaram entre si tanto quanto discordaram da realidade.
Um modelo tornou toda a gente moderada. O outro tornou toda a gente extrema. O resumo da Pew: cada amostra sintética «pintou um retrato muito diferente do público americano», e «nenhuma refletiu verdadeiramente a opinião pública real».
Para um fundador, isto significa que o «mercado» descrito por um estudo com utilizadores sintéticos depende em parte do modelo que usares. Muda de modelo e a tua curva de disponibilidade para pagar mexe-se.
A Pew não diz que a IA é inútil na investigação. Aponta dois usos em que ajuda: classificar respostas reais a perguntas abertas e escrever o código para analisar os resultados. Em ambos, a IA processa o que pessoas reais disseram em vez de o inventar.
Para os fundadores, a mesma regra dá uma lista útil:
Pede a um modelo que sugira perguntas e depois corta as que induzem a resposta. É rápido, e nada do que produz conta como prova.
Passa o teu inquérito por um modelo para encontrar perguntas confusas ou duplas antes de pessoas reais o verem.
Põe o modelo a fazer de comprador cético para treinares o teu pitch. Trata isso como treino, não como previsão do que os compradores vão dizer.
Depois de falares com pessoas reais, usa um modelo para etiquetar os temas das tuas notas. É o uso que a Pew subscreve.
O que não consegue fazer é dizer-te se as pessoas querem o que estás a construir, quantas são, ou quanto pagariam.
Cinco conversas reais com pessoas que têm o problema dizem-te mais do que quinhentas sintéticas, porque te podem surpreender. Podem dizer «não sei», «nunca ouvi falar disso» ou «resolvemos isso com uma folha de cálculo há anos» — exatamente as respostas que, segundo a Pew, a IA quase nunca dá.
Se nunca organizaste essas conversas, os nossos guias sobre como preparar uma chamada de descoberta e sobre como transformar o interesse de uma comunidade no primeiro cliente pagante explicam como fazer.
A Pew estudou opinião pública, não procura por produtos. As perguntas eram sobre política, atualidade e conhecimento. Aplico os padrões à investigação de clientes porque o mecanismo é o mesmo, mas a Pew não testou perguntas sobre produtos.
Foram comparados dois modelos. O Claude Opus 4.6 foi o modelo principal, e a comparação acrescentou o GPT-5.1. O número principal de 12,4 pontos é a média de três inquéritos; a comparação entre modelos indica 11,4 pontos para o Claude e 13,3 para o GPT nas perguntas que abrangeu. Outros modelos, prompts ou métodos podem sair-se melhor ou pior.
Melhores métodos podem reduzir a diferença. A própria Pew o diz: modelos mais recentes e novas formas de construir amostras sintéticas podem produzir erros menores. É uma medição do presente, não um limite permanente.
Os teus utilizadores sintéticos assentam provavelmente em menos informação. Os gémeos da Pew foram construídos com as próprias respostas detalhadas de cada pessoa. A maioria das personas dos fundadores é um parágrafo de descrição. Isso sugere que os utilizadores sintéticos de um fundador se sairiam pior, mas é uma inferência minha, não algo que a Pew tenha testado.
A Pew construiu a versão mais cuidadosa de inquiridos sintéticos que a maioria dos fundadores pode esperar — gémeos de IA de pessoas reais, construídos com as suas próprias respostas — e, mesmo assim, falharam por cerca de 12 pontos em média. Sabiam mais do que as pessoas reais, estavam mais seguros do que elas, evitavam os extremos e respondiam como o estereótipo do seu grupo. Saíram-se pior nos temas novos. E mudar de modelo mudou o retrato.
Para uma startup, isto não são casos raros. São exatamente os erros que fariam um produto parecer mais desejado, mais bem compreendido e com um apelo mais amplo do que realmente tem.
Usa a IA para preparar as conversas com clientes e para as analisar. Não para as substituir.
Fontes: Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer e Aaron Smith, «Can AI stand in for human survey takers? Not really», Pew Research Center, 30 de setembro de 2026 — o método dos gémeos digitais, os três inquéritos do American Trends Panel do início de 2026 e as suas cerca de 300 perguntas, o erro médio de 12,4 pontos, a proporção de perguntas acima de 15 pontos, os exemplos dos centros de dados, da Primeira Emenda, da NATO e do Mundial, a diferença de quatro vezes no «não sei», as opções que nenhum inquirido de IA escolheu, os exemplos de estereótipos e as conclusões da Pew sobre o que a IA pode e não pode fazer. Os mesmos autores, «How synthetic polling results change based on the AI model», Pew Research Center, 30 de setembro de 2026 — a comparação entre o Claude Opus 4.6 e o GPT-5.1, os erros de 11,4 e 13,3 pontos, as taxas de opções intermédias, os exemplos de desacordo entre modelos e a ressalva sobre métodos futuros. As citações são aqui reproduzidas em tradução. A aplicação à investigação de clientes das secções 3 a 6 é minha.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.