
Treinar o GLM e outros modelos abertos com o seu próprio código: o que isso lhe dá de facto (2026)

By Surya Pratap
29 de julho de 2026
11 min read
AI & Technology

29 de julho de 2026
11 min read
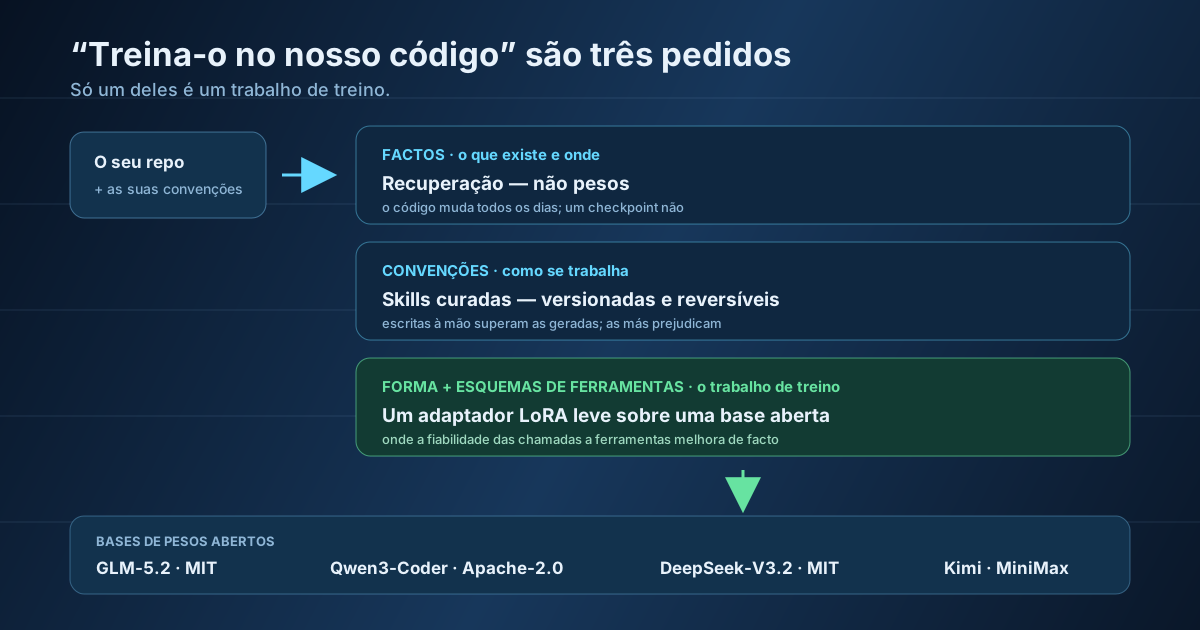
De poucas em poucas semanas, um fundador faz uma versão da mesma pergunta: podemos pegar num modelo aberto como o GLM, treiná-lo com o nosso código e obter um agente que programe como a nossa equipa programa? É um bom instinto, e em 2026 é finalmente razoável: o panorama de pesos abertos é sólido o suficiente para construir em cima dele, e um fine-tuning que antes custava dezenas de milhares custa hoje menos do que um almoço. Mas o pedido esconde uma armadilha. «Treinem-no com o nosso código» são na verdade três pedidos distintos debaixo do mesmo casaco, e só um deles é um trabalho de treino. As equipas que fazem fine-tuning antes de os separar passam um mês a produzir um modelo que escreve no estilo da casa e continua sem saber que serviço é responsável pela nova tentativa de faturação.
Este é um guia prático para o fazer pela ordem certa: como está neste momento o panorama de pesos abertos, como separar os três pedidos, o que um adaptador LoRA resolve de forma mensurável, quanto custa tudo e como escolher um modelo base com o seu próprio repositório em vez da tabela classificativa de outra pessoa.
Comecemos pelo porquê de valer a pena. O GLM-5.2, lançado pela Z.ai em junho de 2026, é um modelo mixture-of-experts de 744 mil milhões de parâmetros com uma janela de contexto de um milhão de tokens, pesos completos no Hugging Face e licença MIT. Foi construído expressamente para programação, raciocínio e trabalho agêntico com ferramentas, e fica a cerca de um ponto percentual do Opus 4.8 da Anthropic num benchmark agêntico essencial, a mais ou menos um quinto do custo. A parte da licença MIT importa mais do que o benchmark: pode treiná-lo, distribuí-lo e alojá-lo sem pedir nada a ninguém.
Não é a única opção, e a base certa depende da forma da sua carga de trabalho. O Qwen3-Coder-480B é Apache-2.0 e ronda os 69,6% no SWE-bench Verified, com variantes mais pequenas muito mais fáceis de alojar por conta própria. O DeepSeek-V3.2 tem licença MIT e chega a cerca de 70%. O Kimi K2.6 é a escolha para trabalho multimodal e multiagente, e o MiniMax M3 para trabalhos de baixo custo e alto débito. Na prática, o GLM-5.2 é a escolha por omissão mais forte para trabalho de agentes com contexto longo e horizonte longo, enquanto o Qwen3-Coder é onde a maioria das equipas acaba quando precisa de algo que corra em hardware que controla.
Uma ressalva sobre os números: o GLM-5.2 saiu sem benchmarks independentes publicados, apresentado pelo fabricante como melhor do que as versões anteriores em programação de horizonte longo. Trate cada número desta secção como um filtro, não como uma decisão. O que nos leva à parte que realmente importa.
Os benchmarks filtram, o seu repositório decide
Tome a decisão final com um conjunto de avaliação privado construído a partir das suas próprias tarefas, executado sobre o checkpoint quantizado exato que vai implementar, dentro da mesma framework de agentes que vai usar em produção. Um modelo que lidera uma tabela classificativa em precisão total pode comportar-se de forma muito diferente a 4 bits dentro do seu harness.
Quando alguém diz que quer um modelo treinado com o seu código, normalmente quer três coisas diferentes ao mesmo tempo. Nomeá-las separadamente é a maior parte do trabalho.
O primeiro pedido são os factos. O que existe na base de código, onde está, que serviço é dono de que tabela, o que aquela função auxiliar devolve de facto. Isto é conhecimento, e o conhecimento muda: o seu repositório muda todos os dias e um conjunto de pesos não. Meter factos num checkpoint significa voltar a treinar sempre que alguém faz merge. Este pedido pertence à recuperação, e fica na recuperação para sempre. O consenso de 2026 é taxativo: se a resposta depende de dados que mudam, use recuperação, e faça fine-tuning apenas para comportamentos que não devem mudar.
O segundo pedido são as convenções. Como a sua equipa faz as coisas: a lista de revisão, o procedimento de migrações, a forma de embrulhar os erros, a regra de que nada fala com a base de dados fora de uma classe repositório. Parece um problema de treino e quase nunca é. Ficheiros de skills curados, instruções simples que descrevem quando e como fazer algo, dão-lhe o mesmo comportamento de imediato, funcionam com qualquer fornecedor de modelos e podem ser editados, versionados, testados e revertidos sem tocar num checkpoint. O fine-tuning muda o comportamento de forma permanente e é lento e incómodo de reverter; um ficheiro de skill é um pull request.
Há aqui uma ressalva importante, e é uma das conclusões de investigação mais úteis do ano: a mera presença de skills não garante nada. As skills geradas automaticamente não trazem qualquer benefício em média, as curadas e escritas por pessoas superam consistentemente a referência sem skills, e as de baixa qualidade degradam de forma mensurável o desempenho do agente. Por isso, não aponte um modelo ao seu repositório e lhe peça que escreva as suas próprias convenções. Peça ao seu melhor engenheiro que escreva dez verdadeiras, à mão, a partir de coisas que correm realmente mal nas revisões.
O terceiro pedido são a forma e os esquemas de ferramentas, e este é um verdadeiro trabalho de treino. Pôr o modelo a emitir as suas chamadas à API interna com os seus nomes de parâmetros, a seguir exatamente a sua estrutura de saída e a escolher de forma fiável a ferramenta certa do seu próprio conjunto é precisamente aquilo em que o fine-tuning é bom. Isto é forma, não factos, e é estável de uma maneira que a localização dos ficheiros não é.
O exemplo publicado mais claro do terceiro pedido é o de uma equipa que precisava de um modelo que percebesse os seus esquemas de ferramentas e a sua nomenclatura de parâmetros específicos. A taxa de sucesso das chamadas a ferramentas do agente era de 40%, o que, se já lançou um agente, reconhecerá como o número em que nada funciona e toda a gente culpa o modelo. Depois de um fine-tuning QLoRA estavam nos 90%. A execução custou cerca de 1.500 $ no total numa única RTX 4090, e ficou a menos de 1% de um fine-tuning completo em todos os benchmarks que mediram.
Repare no que mudou. Não o conhecimento do modelo sobre o sistema deles, nem a sua capacidade geral de programar, mas a sua conformidade com a interface deles. Essa é a promessa honesta de treinar com o seu próprio código: agentes que deixam de se atrapalhar com as suas ferramentas. Se o seu agente falha hoje porque inventa nomes de parâmetros, devolve estruturas mal formadas ou escolhe a ferramenta errada, um adaptador resolve isso. Se falha porque não conhece a sua arquitetura, um adaptador não resolve, e nenhuma quantidade de treino resolverá.
A computação em bruto é agora quase gratuita. Um fine-tuning LoRA ou QLoRA de um modelo de 7–8B custa 3–10 $ em tempo de GPU: duas a quatro horas numa A100 alugada, menos de 3 $ numa 4090 que já tenha. Uma execução QLoRA de 70B fica em cerca de 15–30 $. Os serviços geridos cobram aproximadamente 0,48–0,50 $ por milhão de tokens, pelo que um trabalho típico de 50M de tokens num modelo de 8B fica em cerca de 25 $ alojado, contra 3–10 $ feito por si. A LoRA é a escolha certa na esmagadora maioria dos casos, e os adaptadores combinam-se surpreendentemente bem: um adaptador de estilo de código e um adaptador de raciocínio de segurança praticamente não interferem um com o outro.
A fatura de GPU não é o custo
Treinar custa 10 $. O orçamento real vai para curar exemplos que representem a forma como a sua equipa trabalha de facto e para construir o conjunto de avaliação que lhe diz se o adaptador ajudou. As equipas que saltam as duas coisas ficam com um modelo confiantemente diferente em vez de mensuravelmente melhor, e sem forma de saber qual dos dois.
A sequência em que os profissionais convergiram em 2026 é prompt, depois recuperação, depois fine-tuning, depois destilação, e o fine-tuning com maior retorno é um adaptador LoRA leve sobre um modelo base forte, combinado com recuperação em vez de a substituir. Cada passo é mais barato e mais reversível do que o seguinte, por isso trabalhar por ordem significa que muitas vezes descobre que pode parar mais cedo.
Essa ordem também o protege do erro mais caro aqui, que é prender-se a um checkpoint cedo demais. A recuperação permite-lhe trocar de modelo base livremente; um fine-tuning não. Dada a velocidade a que este campo avança, do GLM-5.1 ao 5.2 em poucos meses, quer que a parte do seu sistema que codifica o seu negócio seja a que consegue levar para um modelo base melhor numa tarde.
Há uma razão para esta conversa girar em torno do GLM e do Qwen e não das API fechadas. Treinar com o seu próprio código significa que o seu código passa a ser dados de treino, e com pesos MIT ou Apache-2.0 pode executar esse processo inteiramente dentro de infraestrutura que controla, o que faz a diferença entre uma conversa com a sua equipa de segurança e uma conversa com as equipas de segurança dos seus clientes. Para quem opera com compromissos de residência de dados ou condições de tratamento empresariais, alojar por conta própria uma base aberta é muitas vezes a única versão deste projeto que sobrevive à revisão.
A segunda razão é a portabilidade. Pesos abertos mais um harness de agentes agnóstico ao modelo significam que o adaptador que treinou este trimestre pode passar para o que liderar o campo no próximo. É uma posição bem diferente de construir o seu fluxo de trabalho sobre o produto de fine-tuning alojado de um único fornecedor e esperar que os preços se mantenham.
Se quer saber se alguma coisa disto vale o seu tempo, não comece por uma execução de treino. Comece por descobrir qual dos três pedidos lhe está realmente a custar.
Faça-o por essa ordem e acontece uma de duas coisas. Ou descobre que a maior parte da sua dor eram factos e convenções, e resolveu-a numa semana com recuperação e ficheiros de skills, de graça, saltando por completo o projeto de treino. Ou encontra um núcleo duro de falhas de interface que nenhum prompt resolve, e gasta 10 $ a transformar uma taxa de 40% nas chamadas a ferramentas em algo que pode lançar. Ambos são bons resultados. O mau é aquele em que começa pelo fine-tuning, porque é a parte mais interessante, e acaba com um modelo que aprendeu o estilo da casa suficientemente bem para errar nele de forma convincente.
O panorama de pesos abertos ultrapassou este ano um limiar real: pela primeira vez, um fundador pode pegar num modelo de programação de classe de fronteira com licença MIT, adaptá-lo às suas próprias interfaces pelo preço de um café e correr tudo em hardware que controla. É uma mudança genuína naquilo que uma equipa pequena pode possuir. Convém apenas lembrar que a alavanca vem de saber a qual dos três pedidos está a responder, não da execução de treino em si.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.