Um modelo de programação de uso geral sabe escrever React e Python como a internet aberta os escreve. Não conhece os limites dos módulos do seu monorepo, o seu framework interno de RPC, o wrapper de autenticação que todos os serviços devem usar, nem o facto de a sua equipa ter banido um padrão há três anos, depois de uma falha. Essa distância, entre a forma como o mundo programa e a forma como a sua empresa programa, é exatamente o que um modelo com fine-tuning resolve. E em 2026, construir o stack para o fazer é muito mais acessível do que a maioria dos líderes de engenharia supõe.
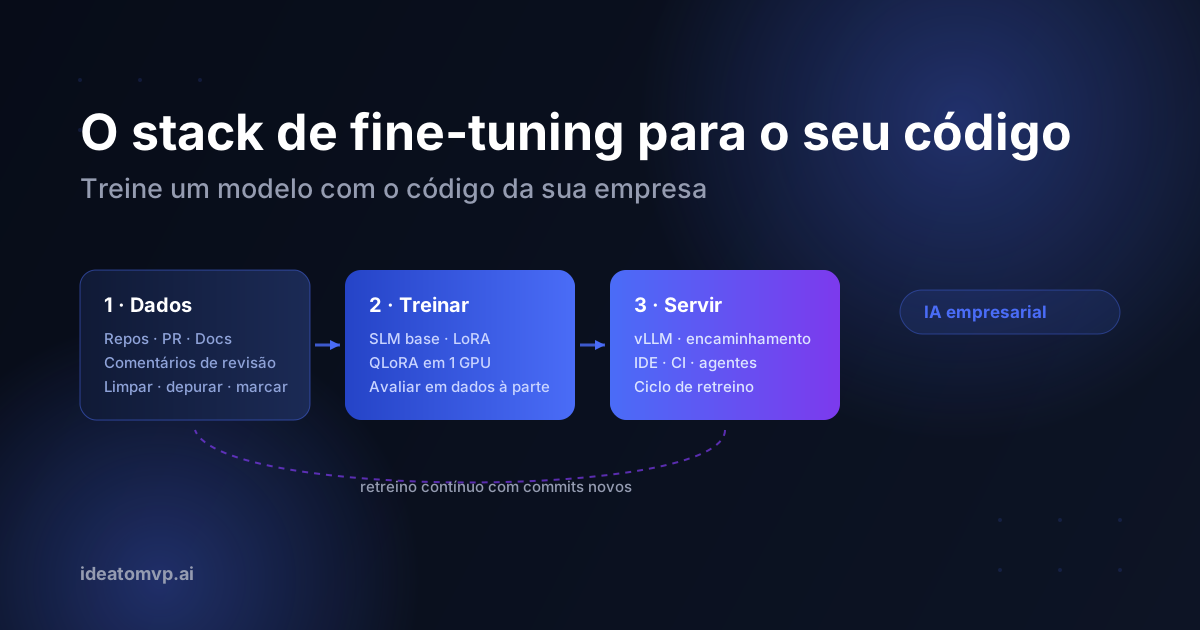
Este é um percurso prático, camada a camada, pelo stack de que precisa para fazer o fine-tuning de um modelo com uma base de código empresarial específica: o pipeline de dados, a escolha do modelo base, a camada de treino, a avaliação, a disponibilização e o ciclo de retreino que mantém o modelo atualizado à medida que o seu código evolui. Aborda também a decisão que vem primeiro: se deve sequer fazer fine-tuning, ou se a recuperação basta.
Primeiro: fine-tuning versus RAG versus contexto longo
Antes de reservar uma única GPU, seja honesto sobre o problema que está a resolver. Há três ferramentas em concorrência, e não são intermutáveis:
- A recuperação (RAG) ensina factos. «O que faz esta função? Onde está definido o cliente de pagamentos?» Se precisa de fundamentar as respostas no código e na documentação atuais, um RAG sobre um índice vetorial do seu repositório é mais barato, mais rápido de lançar e atualiza-se no instante em que o código muda. Comece por aqui.
- O fine-tuning ensina comportamento e estilo. «Escreve código como nós o escrevemos.» As convenções de nomes, os idiomas de tratamento de erros, as bibliotecas preferidas, a estrutura da casa para um serviço: padrões demasiado difusos para caber num prompt e demasiado consistentes para deixar a um modelo genérico. É aqui que o fine-tuning é único.
- O contexto longo resolve o pontual. Para uma única tarefa grande, colar os ficheiros relevantes na janela de contexto de um modelo de fronteira basta muitas vezes. Não escala para cada developer, todos os dias, a um custo previsível, e é precisamente por isso que as equipas acabam por passar ao fine-tuning.
A resposta madura é normalmente fine-tuning mais RAG: um modelo que interiorizou o seu estilo e as suas convenções e que recupera o seu código atual no momento da inferência, para que os seus factos nunca estejam desatualizados. O resto deste guia constrói essa combinação.
Camada 1: o pipeline de dados (80% do trabalho)
Qualquer profissional honesto lhe dirá o mesmo: o modelo é fácil; o projeto são os dados. Um fine-tuning é tão bom quanto os exemplos com que aprende, e uma base de código empresarial é uma fonte desarrumada. O pipeline tem quatro fases.
- Recolher. Recorra às fontes que realmente mostram como a sua equipa constrói: os repositórios de código, os pull requests integrados e os respetivos comentários de revisão, os documentos internos de desenho e os ADR, os pedidos resolvidos e os runbooks. Os PR e as conversas de revisão valem ouro: captam não só o código, mas também o raciocínio e as correções.
- Limpar e filtrar. Retire segredos e credenciais (inegociável, e faça-o antes de qualquer coisa chegar a um servidor de treino), remova código gerado, dependências incluídas no repositório e lockfiles, elimine módulos mortos e obsoletos, e desduplique ficheiros quase idênticos para que o código repetitivo não domine o sinal.
- Dar forma aos exemplos. Decida o formato da tarefa. Para um modelo de preenchimento automático, use exemplos fill-in-the-middle (FIM) tirados de ficheiros reais. Para um assistente que segue instruções, construa pares instrução–resposta: «Acrescenta um endpoint paginado a este serviço» emparelhado com o diff real que o fez. O título e a descrição do PR como instrução e o diff integrado como resposta são uma fonte poderosa e quase gratuita de dados de instruções.
- Separar e reservar. Reserve um conjunto de teste antes de treinar, de preferência os commits mais recentes, para que a avaliação imite o uso real: prever código que o modelo nunca viu. Nunca deixe que ficheiros de teste passem para o treino.
A barreira de licenças e privacidade
Os seus dados de treino são a sua propriedade intelectual mais sensível. Essa é a maior razão para correr todo o stack em infraestrutura que controla: uma VPC privada, GPU reservadas ou instalações próprias. Confirme que tem o direito de treinar com cada fonte (atenção ao código de terceiros e com licença copyleft dentro do monorepo), elimine dados pessoais e segredos, e registe exatamente o que entrou em cada execução de treino. Quando o stack é seu, isto torna-se uma propriedade da arquitetura e não uma promessa do fornecedor.
Camada 2: escolher o modelo base
Não está a treinar um modelo do zero: está a adaptar uma base sólida de pesos abertos que já percebe de programação. Escolha entre a geração atual de modelos de código abertos (as famílias Qwen-Coder, Code Llama, DeepSeek-Coder e StarCoder, além de modelos gerais pequenos como o Phi e o Gemma). Três fatores orientam a escolha:
- Tamanho face à tarefa. Para o preenchimento automático em linha e tarefas de assistente bem delimitadas, um modelo de 3B–8B ajustado com o seu código é rápido, barato de disponibilizar e muitas vezes bate um modelo genérico muito maior nos seus padrões específicos. Reserve os de 14B–34B para raciocínio real entre vários ficheiros. Maior não é o objetivo; a adequação sim.
- Licença. Confirme que os pesos permitem uso comercial e interno. É uma caixa jurídica a assinalar, não um pormenor: resolva-a antes de construir sobre uma base.
- Comprimento de contexto e suporte de FIM. As tarefas de código abrangem vários ficheiros, por isso privilegie bases com contexto longo e treino nativo fill-in-the-middle se o seu caso de uso for o preenchimento automático.
Camada 3: a camada de treino (LoRA / QLoRA)
Quase de certeza que não precisa de um fine-tuning completo. Os métodos eficientes em parâmetros, o LoRA e o seu primo quantizado QLoRA, treinam um pequeno conjunto de pesos adaptadores sobre uma base congelada, o que significa que pode adaptar um modelo de 7B numa única GPU moderna em horas, pelo preço de um bom jantar. As ferramentas estão maduras: bibliotecas como Hugging Face PEFT, Axolotl e Unsloth envolvem todo o ciclo.
O que realmente importa nesta camada:
- Os adaptadores mantêm tudo modular. Como um adaptador LoRA é um ficheiro pequeno, separado dos pesos base, pode treinar um adaptador por equipa, por linguagem ou por serviço, e trocá-los no momento da disponibilização. Retreinar é barato e o raio de impacto é pequeno.
- Proteja-se do esquecimento catastrófico. Treinar em excesso com uma base de código estreita pode piorar o modelo em programação geral. Misture uma porção de dados de código de uso geral, mantenha taxas de aprendizagem moderadas e pare cedo com base na sua curva de avaliação, e não num número fixo de épocas.
- Registe cada execução. Versione em conjunto o conjunto de dados, o modelo base, os hiperparâmetros e o adaptador resultante. Quando um modelo regride, precisa de saber exatamente o que mudou.
Quanto à capacidade de computação: alugue antes de comprar. Uma GPU reservada na cloud (uma A100 ou H100 na CoreWeave, na Lambda ou no nível reservado de um hiperescalador) é o ponto de entrada certo. Só passe para hardware próprio quando o volume de treino e de inferência for suficientemente estável para o justificar.
Camada 4: a avaliação (a camada que as equipas saltam e de que se arrependem)
Um fine-tuning que «parece melhor» numa demo não é um resultado. A diferença entre um programa de modelos em produção e um projeto de ciência é um verdadeiro sistema de avaliação que corre a cada retreino. Para código, tem opções invulgarmente boas:
- Testes baseados em execução. O código pode ser verificado. Gere preenchimentos para tarefas reservadas, corra-os contra os seus testes unitários reais e meça quantos passam. Construa um conjunto interno ao estilo do SWE-bench a partir dos seus próprios problemas resolvidos e dos respetivos testes: é o sinal mais honesto que pode obter.
- Verificações de estilo e convenções. Passe o código gerado pelos seus linters, formatadores e verificadores de tipos. Um modelo que interiorizou as suas convenções produz código que passa sem problemas pelas suas barreiras de CI.
- Frente a frente com a referência. Compare sempre o modelo ajustado com o modelo base em bruto e com uma API de fronteira forte na mesma tarefa. Se não bater ambos na sua métrica, aprendeu algo valioso antes de o lançar.
Camada 5: a disponibilização e a camada de aplicação
Um adaptador treinado guardado num armazenamento de objetos não ajuda ninguém. A camada de disponibilização é onde o modelo encontra os developers:
- Servidor de inferência. Disponibilize com vLLM, TGI ou Ollama para inferência de alto débito e baixa latência, crítica para o preenchimento automático, em que tudo acima de umas centenas de milissegundos parece avariado. Quantize (GPTQ/AWQ) para caber mais concorrência em cada GPU.
- Recuperação no momento da inferência. Combine o modelo ajustado com RAG sobre o seu repositório atual, para que tenha o estilo incorporado e os factos atualizados no contexto. É esta a recompensa do fine-tuning mais RAG.
- Superfície de entrega. Disponibilize-o onde os developers já trabalham: uma extensão do IDE para o preenchimento automático, um endpoint de chat para perguntas, um bot de CI para revisão, ou como ferramenta dentro de um fluxo de trabalho agêntico.
- Encaminhamento. Não tem de servir todos os pedidos a partir do seu modelo. Encaminhe os pedidos frequentes e do seu domínio para o modelo ajustado, e escale os raros, verdadeiramente difíceis e abertos para uma API de fronteira. Coloque cada pedido na camada mais barata que o resolva bem.
Camada 6: o ciclo de retreino
Uma base de código é um alvo em movimento. O modelo que treina no primeiro trimestre está subtilmente errado no terceiro, porque as suas convenções, dependências e arquitetura evoluíram. A peça final do stack é um ciclo, não um marco: com uma cadência mensal ou trimestral, leve ao pipeline os PR integrados mais recentes, retreine o adaptador, corra o sistema de avaliação e promova o novo adaptador apenas se bater o atual nas suas métricas. Cada ciclo alarga a distância entre o seu modelo e tudo o que um concorrente consiga obter com prompts a um modelo genérico, porque essa distância é o seu conhecimento de engenharia acumulado.
O stack num relance
- Dados: recolher repositórios, PR e documentação → limpar, desduplicar, retirar segredos → dar forma de pares FIM ou de instruções → reservar os commits recentes.
- Modelo base: um modelo de código de pesos abertos dimensionado para a tarefa, com uma licença clara e contexto longo.
- Treino: LoRA/QLoRA com PEFT, Axolotl ou Unsloth numa GPU reservada, com execuções versionadas e proteção contra o esquecimento.
- Avaliação: testes de execução, verificações de lint e de tipos, e comparações frente a frente com referências num conjunto reservado.
- Disponibilização: vLLM/TGI + RAG, entregue no IDE, na CI ou num agente, com encaminhamento para uma API de fronteira para os casos difíceis.
- Retreino: um ciclo agendado que mantém o adaptador atualizado à medida que o código evolui.
Conclusão
Fazer o fine-tuning de um modelo com a base de código da sua empresa já não é um esforço de investigação reservado aos laboratórios de IA: é um projeto de engenharia com um stack bem testado. Um pipeline de dados disciplinado, uma base de pesos abertos, umas horas de treino LoRA numa GPU alugada, um verdadeiro sistema de avaliação, uma camada de disponibilização rápida e um ciclo de retreino. Acerte nos dados e o resto é canalização. O que obtém é uma inteligência que nenhum concorrente consegue comprar nem obter à força de prompts: um modelo que escreve código como a sua organização o escreve.
Se está a ponderar por onde começar (se deve fazer fine-tuning ou apoiar-se na recuperação, que tarefa adaptar primeiro, ou como montar o pipeline em segurança na sua própria infraestrutura), marque uma chamada de descoberta gratuita e desenhamos o stack consigo.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.