Duas formas de distribuir cinco agentes de código — uma desperdiça quatro, a outra entra em conflito 41,7% das vezes

By Surya Pratap
22 de setembro de 2026
12 min read
AI & Technology

22 de setembro de 2026
12 min read
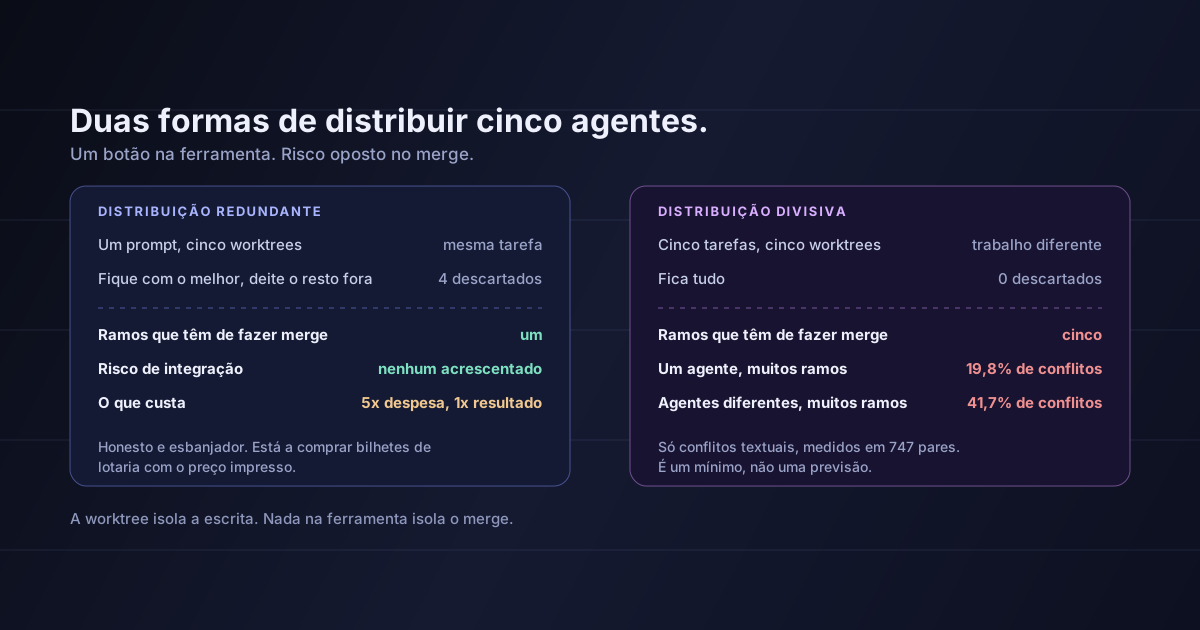 Distribuição redundante e distribuição divisivaHover to explore
Este ano surgiu uma categoria de ferramentas sem que ninguém lhe desse nome muito alto, e o interessante não é aquilo que faz bem. É aquilo que, em silêncio, deixa para si.
Este artigo parte do Orca, o ambiente de agentes em paralelo da Stably AI com licença MIT, e do artigo explicativo do ArshTechPro publicado a 20 de setembro de 2026; do conjunto de dados AgenticFlict de Daniel Ogenrwot e John Businge; do estudo de Xu, Subramanian e Karthik sobre pull requests concorrentes de agentes; e da análise que Daniel Vaughan fez desse estudo. A secção 8 diz em que números confio e até onde. A distinção entre as duas distribuições, o argumento das costuras e todas as recomendações são meus.
O ambiente de desenvolvimento de agentes — ADE, e sim, estamos a uma letra de IDE de propósito — é uma aplicação de secretária que não contém nenhum modelo. Contém uma frota.
O Orca é o que se destacou. Tem licença MIT, corre em macOS, Windows e Linux com uma aplicação de acompanhamento para telemóvel, e o seu próprio argumento é franco: "Corra o Codex, o ClaudeCode, o OpenCode ou o Pi lado a lado — cada um na sua worktree, acompanhados num só sítio." Suporta uns trinta agentes CLI com nome próprio e, na prática, qualquer um. Quando consultei o repositório a 22 de setembro, estava em cerca de 75.000 estrelas; as análises escritas durante o verão citam números mais próximos de 60.000, portanto a curva é suficientemente inclinada para que qualquer número que leia já esteja errado.
O mecanismo é uma primitiva do git que ali está desde 2015 e que subitamente tem uma aplicação de eleição:
Uma tarefa, uma worktree. Cada agente recebe o seu próprio diretório de trabalho partilhando o mesmo armazém de objetos — um sistema de ficheiros real, um ramo real, sem stash.
Uma worktree, um terminal. A sessão do agente, os seus testes e o seu servidor de pré-visualização ficam todos circunscritos a esse diretório.
Sem disputas pelo .git/index.lock. A falha em que dois agentes escrevem no mesmo diretório de trabalho e se corrompem mutuamente simplesmente não pode acontecer.
Diffs que se podem anotar. Deixa comentários em markdown em linhas concretas do diff, agrupa-os e devolve-os ao agente como feedback.
Isto é boa engenharia e resolve um incómodo genuíno. Se alguma vez quis começar uma segunda tarefa enquanto um agente se debatia com a primeira, sabe exatamente que problema está aqui a ser resolvido.
A worktree isola a escrita. Nada na ferramenta isola o merge.
Aqui está o que me fez querer escrever isto. A ferramenta oferece um só gesto — distribui isto por cinco agentes — e esse gesto único cobre duas operações completamente diferentes.
A distribuição redundante é a demonstração. Um prompt, cinco agentes, cinco worktrees, cinco tentativas da mesma tarefa. Lê os cinco diffs, fica com o melhor e apaga quatro ramos. O próprio texto do Orca descreve-o: distribua um prompt por cinco agentes, compare os resultados, faça merge do vencedor.
A distribuição divisiva é aquilo para onde se acaba por passar. Cinco tarefas diferentes, cinco worktrees, cinco agentes, e no fim quer as cinco. Não se deita nada fora, porque deitar fora nunca foi o objetivo: o objetivo era fazer cinco coisas no tempo de uma.
Na interface são iguais. São opostas.
| Distribuição redundante | Distribuição divisiva | |
|---|---|---|
| O que varia | O agente ou a semente | A tarefa |
| Ramos que guarda | Um | Todos |
| Ramos que têm de fazer merge | Um | Todos |
| Risco de integração acrescentado | Nenhum | O tema deste artigo |
| O que paga | N× de despesa por 1× de resultado | N× de despesa por N× de resultado, menos os conflitos |
A distribuição redundante é um bilhete de lotaria com o preço à vista. Gasta cinco vezes para obter um resultado e sabe à partida que quatro quintos da despesa vão para o lixo. O analista citado na cobertura diz-o sem rodeios: correr o Claude Code três vezes em paralelo consome três vezes a sua quota. Não há custo oculto porque o desperdício é precisamente a parte visível.
É na distribuição divisiva que o custo oculto vive. Parece mais poupada — não se deita nada fora! — e é exatamente por isso que se migra para ela, normalmente na primeira semana depois de instalar a coisa.
Há três trabalhos empíricos de 2026 que tocam neste ponto e, lidos em conjunto, contam uma história coerente.
Quão comum já é o trabalho concorrente de agentes?
Xu, Subramanian e Karthik percorreram 33.596 pull requests escritos por agentes em 2.807 repositórios. Com sobreposição temporal exata, 79,4% dos PR de agentes estavam ativos ao mesmo tempo que outro PR de agente, em 40,2% dos repositórios. Alargando a janela para uma semana, passa a 95% dos PR em 53,4% dos repositórios.
A distribuição divisiva não é uma prática de fronteira que alguém poderia experimentar. É a condição por omissão de qualquer repositório com agentes lá dentro.
Com que frequência é que esse trabalho colide?
O conjunto de dados AgenticFlict, de Daniel Ogenrwot e John Businge, é o mais amplo: mais de 142.000 pull requests de agentes vindos de mais de 59.000 repositórios, dos quais mais de 107.000 foram reproduzidos por simulação determinista de merge. O resultado: 27,67% — mais de 29.000 PR — produziram conflitos textuais de merge, espalhados por mais de 336.000 regiões de conflito distintas.
A comparação que lhe dá gume: os estudos anteriores sobre pull requests escritos por pessoas situam-se em geral na faixa dos 10 a 20%. As contribuições de agentes estão a entrar em conflito entre uma vez e meia e duas vezes e meia mais do que as humanas.
Interessa saber quais são os agentes?
Esta é a descoberta que reenquadra o produto. Xu e colegas correram simulações de merge sobre 747 pares de PR e separaram-nos:
A funcionalidade de bandeira é o pior caso
Os pares de agentes diferentes entraram em conflito a cerca do dobro da taxa dos pares do mesmo agente. A capacidade que encabeça qualquer ADE — corra o Claude Code e o Codex e o Cursor lado a lado, porque haveria de ser fiel a um só — é, em modo divisivo, a configuração de que os dados menos gostam. Dois agentes treinados de forma diferente, arrancados a partir de ficheiros de sistema diferentes e com opiniões diferentes sobre nomes, arrumação de ficheiros e onde deve viver um auxiliar, vão divergir estruturalmente de maneiras que duas execuções do mesmo agente em geral evitam.
Vale a pena dizê-lo com honestidade: na prática, a sobreposição entre agentes diferentes continua a ser rara — apenas 0,5% dos pares concorrentes envolvia agentes distintos, em 122 de 2.807 repositórios. O valor de 41,7% é o que acontece se o fizer, medido numa amostra pequena. E toda a proposta de valor do ADE consiste em tornar fácil precisamente aquilo que era raro.
Decomponha o que estes conflitos são na verdade e o quadro deixa de ser sobre controlo de versões. Segundo a análise que Vaughan fez do estudo, os pares em conflito repartem-se em três:
| Classe de conflito | Proporção | O que significa na verdade |
|---|---|---|
| Sobreposição textual | 57,6% | Dois agentes editaram as mesmas linhas. Uma falha de divisão: pôs duas pessoas numa só secretária |
| Modificar / apagar | 26,8% | Um agente alterou o que o outro apagou. Uma decisão de arquitetura que ninguém tomou, tomada duas vezes e de forma diferente |
| Adicionar / adicionar | 15,1% | Ambos os agentes criaram o mesmo ficheiro. Uma falha de especificação: a nenhum foi dito que o outro precisaria dele |
Só a primeira é um problema de merge. As outras duas — cerca de 42% em conjunto — são estruturais, não se resolvem mecanicamente e não são sequer conflitos entre ramos. São conflitos entre dois planos, descobertos no pior momento possível: depois de ambos os planos estarem inteiramente implementados.
Um conflito de adicionar/adicionar é especialmente revelador. Dois agentes concluíram em separado que fazia falta um ficheiro, inventaram-no, e nenhum sabia do outro. Nenhuma quantidade de ferramentas de merge resolve isso. A resolução está a montante, naquilo que lhes disse.
E repare onde estes conflitos caem: 84,4% dos ficheiros em conflito eram código-fonte, não ficheiros de bloqueio nem manifestos de dependências. Não é o conflito maçador mas mecânico que se resolve ficando com a versão do outro. É daqueles em que tem de perceber os dois lados.
Esta é a parte que sublinharia se só pudesse guardar um parágrafo.
Todas estas taxas dizem respeito apenas a conflitos textuais. Os autores dizem-no sem rodeios: os números são um limite inferior conservador que exclui as falhas de compilação e os conflitos semânticos. Ou seja, medem os casos em que o git parou e o avisou.
O caso perigoso é o outro.
O conflito que faz merge sem sujidade
Dois agentes em duas worktrees. Um renomeia uma função e atualiza todas as chamadas que consegue ver. O outro acrescenta uma chamada nova, num ficheiro que o primeiro nunca abriu, com o nome antigo. Ficheiros diferentes. Nenhuma linha sobreposta. O git faz merge sem um resmungo — e agora tem um ramo que não compila ou, pior, um que compila. Mude uma regra de validação num ramo e confie na regra antiga no outro: fica com CI verde e um erro que aparece em produção quinze dias depois. Não existe um marcador de conflito para "estas duas alterações discordam sobre o que é verdade".
As worktrees isolam ao nível do sistema de ficheiros. Não coordenam ao nível semântico, e dois ramos podem tocar em ficheiros inteiramente disjuntos e mesmo assim contradizer-se — através de tabelas de rotas, exportações agregadas, definições de tipos partilhadas, configuração, esquemas de base de dados ou uma simples suposição sobre como algo se comporta.
Portanto a leitura honesta dos 27,67% é: essa é a fatia em que o problema se anunciou sozinho. Ninguém mediu a fatia em que não o fez, e não é zero.
Aqui está o reenquadramento sobre o qual eu construiria, e não é de todo sobre ferramentas.
Todos os ADE o convidam a responder à pergunta quantos agentes devo correr? com um número tirado do orçamento ou da máquina. Cinco soa bem. Cinco é o que o marketing mostra. Mas a restrição real nada tem a ver com quotas:
Pode correr em paralelo tantos agentes quantas as costuras que o seu código tiver — fronteiras dos dois lados das quais duas alterações se podem escrever sem precisarem de se ver.
Uma costura é um módulo com uma interface estável, um serviço atrás de um contrato de API, uma migração que só adiciona, um componente que mais ninguém importa. Se o seu código tem quatro costuras verdadeiras, quatro agentes é o teto. Correr oito significa que quatro deles estão a escrever contra pressupostos que os outros quatro estão a mudar ao mesmo tempo, e descobrirá quais no momento do merge, às taxas acima.
Isto explica algo que de outro modo parece um paradoxo: as equipas com código bem fatorizado contam que os agentes em paralelo funcionam lindamente, as equipas com código emaranhado contam o caos, e ambas correm exatamente o mesmo software. A variável não é a ferramenta. É o número de costuras.
Dá também a resposta honesta a devemos adotar isto? Se tem três costuras, comprar um gestor de frota para doze agentes é comprar capacidade que não consegue usar. O trabalho que desbloqueia o paralelismo é o mesmo aborrecido trabalho de modularidade de sempre — uma conclusão pouco satisfatória e, creio, verdadeira.
Cinco coisas, por ordem, e nenhuma delas exige que deixe de usar uma ferramenta de que goste.
Não precisa de um estudo; precisa do git merge-tree. Pegue nos ramos que os seus agentes produziram no último mês, reproduza cada par contra a sua base de merge e conte quantos entram em conflito. Esse número é seu: reflete a estrutura de costuras do seu código, não a média do sector. Se ficar bastante abaixo dos 19,8%, a sua divisão é melhor do que a típica e pode alargar mais. Se passar dos 40%, acrescentar agentes é acrescentar retrabalho.
Uma simulação de merge é barata o suficiente para correr num hook sempre que um agente escreve um ficheiro. Saber que dois agentes seguem para as mesmas linhas vale imenso ao minuto três e quase nada à segunda hora, quando ambos já construíram por cima da colisão.
Antes de uma distribuição, nomeie que caminhos cada tarefa pode tocar — e trate um agente que sai do seu conjunto como sinal de que a tarefa estava mal delimitada, não como algo a deixar passar. O AGENTS.md é o sítio certo para as fronteiras que valem de tarefa para tarefa; veja o que os melhores repositórios escrevem realmente no deles.
Faça aterrar um ramo, rebase o seguinte sobre a nova base e, havendo conflito, dê ao agente a base rebaseada e deixe-o refazer a alteração em vez de resolver à mão um conflito entre duas coisas que não escreveu. Que o agente acerte o seu próprio trabalho com a realidade atual é melhor desfecho do que ser você a arbitrar entre dois planos em que não participou.
19,8% contra 41,7% é a decisão mais barata de todo este artigo. Guarde a comparação entre vários agentes para a distribuição redundante, onde escolhe um vencedor e deita o resto fora: aí a divergência de estilo é justamente o objetivo e não lhe custa nada, porque só um ramo aterra.
A regra prática por baixo das cinco:
Use muitos agentes quando for guardar um resultado e um agente quando for guardar muitos. O ADE transforma ambos num único clique, e é precisamente por isso que a distinção tem de viver na sua cabeça.
747 pares é uma amostra pequena e o intervalo entre agentes diferentes é largo. O valor de 41,7% traz um intervalo de confiança de 95% de 33,1 a 50,9%. A direção — entre agentes diferentes é bastante pior — é a descoberta com que eu agiria. A segunda casa decimal não.
Os 27,67% do AgenticFlict não são uma previsão para o seu repositório. É uma taxa populacional sobre 59.000 repositórios com estruturas, culturas de revisão e usos de agentes radicalmente diferentes. Um código bem fatorizado com tarefas bem delimitadas ficará muito abaixo. É uma razão para medir, não um número com que planear.
A referência humana dos 10 a 20% vem de outros estudos com outros métodos. Compará-los é útil quanto ao sentido e não é uma experiência controlada. Os PR de agentes também são tipicamente maiores e produzidos mais depressa, e parte da diferença será de certeza isso e não algo intrínseco aos agentes.
Não estou a dizer que o ADE é uma má ferramenta. O isolamento por worktree é francamente correto, e o ciclo de anotar e devolver ao agente é o melhor da categoria. O meu argumento é sobre a distância entre o que resolve e o que um fundador supõe que resolve — não sobre a qualidade daquilo que faz.
As estrelas não são adoção e muito menos retenção. 75.000 estrelas numa categoria que se move depressa diz-lhe que a atenção chegou. Não lhe diz nada sobre quantos desses repositórios ainda a usarão em março.
Nada disto está medido sobre os conflitos semânticos, nem por mim. Argumentei que existem e que as taxas publicadas, por isso, subestimam o problema. Não lhe sei dizer quanto, e por enquanto ninguém sabe.
Correr agentes de código em paralelo deixou de ser um problema difícil este ano. Worktrees isoladas, um clique, trinta agentes suportados, licença MIT, funciona no telemóvel. Essa parte está terminada.
Fazer aterrar o que produzem não está, é mensuravelmente mais difícil do que fazer aterrar trabalho humano, e é a metade que nenhum ADE diz resolver — porque não se resolve dentro da ferramenta. Depende de como o seu código está fatorizado e de com que precisão delimitou as tarefas, e ambas as coisas eram trabalho seu antes de tudo isto existir.
O padrão é o que não pára de se repetir na engenharia com agentes: o estrangulamento não desaparece, muda de sítio, e muda-se para aquilo que ainda exige critério. A geração tornou-se paralela. A integração não, e é na integração que está o critério.
Antes de alargar a distribuição, conte as suas costuras. Se o número for menor do que o de agentes que ia correr, não está a comprar débito: está a comprar conflitos de merge a uma taxa documentada, e a pagar preço inteiro por agente por esse privilégio.
Fontes: Orca no GitHub — a licença MIT, a lista de agentes suportados, o modelo de isolamento por worktree, a descrição de distribuir um prompt por cinco agentes e a contagem de estrelas a 22 de setembro de 2026. ArshTechPro, "Orca Explained", 20 de setembro de 2026 — o enquadramento do ADE, a estrutura de worktree mais terminal mais pré-visualização, o ciclo de anotação de diffs e a nota de que agentes em paralelo multiplicam o consumo. Ogenrwot e Businge, "AgenticFlict" — os 142.000 pull requests, os 59.000 repositórios, as 107.000 simulações de merge, a taxa de 27,67% de conflitos textuais, as 336.000 regiões de conflito e a referência humana dos 10 a 20% vinda de trabalhos anteriores. Xu, Subramanian e Karthik, "AI Agent Pull Requests on GitHub" — os 33.596 PR em 2.807 repositórios, os números de concorrência de 79,4% e 95%, a simulação sobre 747 pares, as taxas de 19,8% e 41,7% com os seus intervalos de confiança, os 0,5% de pares entre agentes diferentes e os 84,4% de ficheiros de código-fonte. Daniel Vaughan, "When Agents Collide", 28 de julho de 2026 — a taxonomia de conflitos 57,6% / 26,8% / 15,1% e a observação de que o isolamento por worktree evita as colisões de diretório mas não os conflitos de merge. A distinção entre distribuição redundante e divisiva, a correspondência entre as classes de conflito do git e as falhas de divisão, arquitetura e especificação, o argumento das costuras e todas as recomendações da secção 7 são meus. Para o argumento de que o estrangulamento muda de sítio, veja os números de CI da Anthropic, e sobre quem deveria rever todo este trabalho, contrate primeiro o revisor e só depois o programador.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.