A Microsoft pôs 1024 agentes de código a trabalhar sem chefe. 128 vezes mais agentes renderam 9,5 pontos

By Surya Pratap
29 de setembro de 2026
9 min read
AI & Technology

29 de setembro de 2026
9 min read
 Mais agentes, sobretudo mais cedoHover to explore
A forma habitual de pôr muitos agentes de código a trabalhar é deixar um deles no comando: um planeador divide o trabalho e distribui-o. Esse planeador torna-se o estrangulamento assim que há mais trabalhadores do que consegue acompanhar. Um artigo da Microsoft Research publicado na semana passada elimina-o por completo e leva o resultado até 1024 agentes. O desenho merece ser estudado. Os números de destaque pedem uma leitura cuidadosa.
Tudo o que se segue vem de «Agensh: Scaling Organizational Intelligence to 1,024 Agents», de Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia e Furu Wei, da Microsoft Research, publicado no arXiv a 22 de setembro de 2026. É um preprint e não passou por revisão por pares. A leitura a partir da secção 3 é minha.
O ProgramBench entrega a um agente um programa compilado e pede-lhe que reconstrua o software de raiz — um código completo que compile e se comporte da mesma forma — em seis horas e sem acesso à internet. A pontuação é a proporção de testes ocultos em que o programa reconstruído passa.
O Agensh foi testado nas cinco tarefas mais difíceis das 200 do ProgramBench, escolhidas pelo mau desempenho dos modelos atuais nelas. Abrangem processamento multimédia, simulação molecular, conversão de documentos, interpretação de linguagens e indexação de código. Todos os trabalhadores usaram o mesmo modelo, o GPT-5.6-sol com esforço de raciocínio alto.
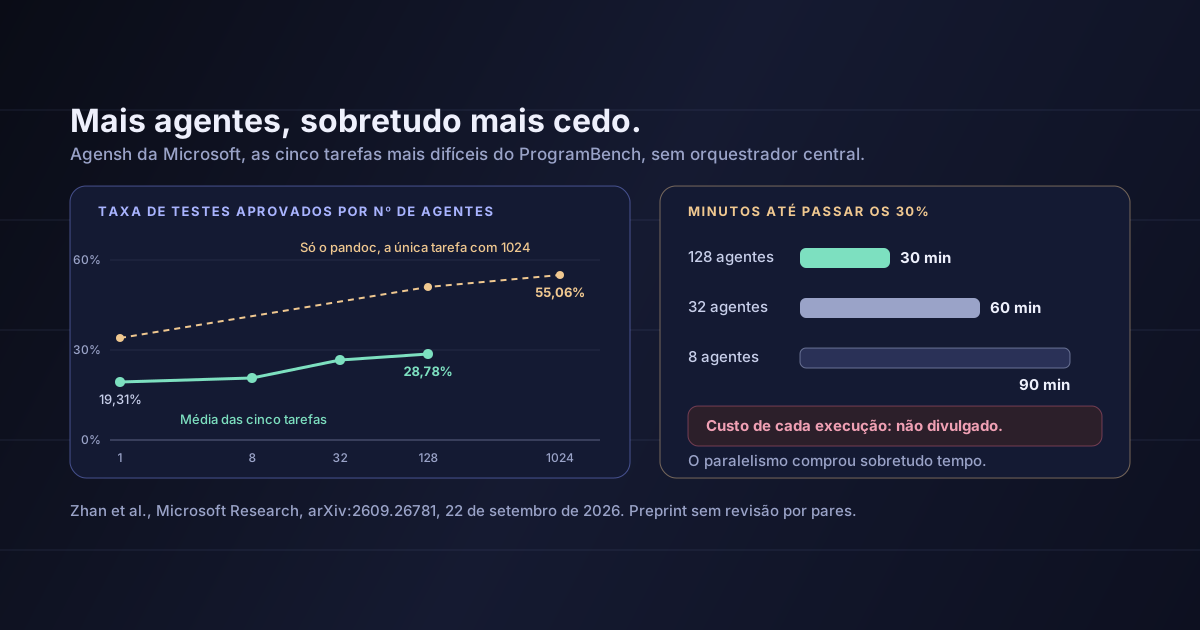
Taxa média de testes aprovados nas cinco tarefas:
| Agentes | Taxa média de testes aprovados | Diferença face à linha anterior |
|---|---|---|
| 1 | 19,31% | — |
| 8 | 20,68% | +1,37 pontos |
| 32 | 26,52% | +5,84 pontos |
| 128 | 28,78% | +2,26 pontos |
De 1 agente para 128 são cerca de 9,5 pontos, o que os autores descrevem como uma melhoria relativa de cerca de 49%.
Só uma tarefa, o conversor de documentos pandoc, foi corrida com os 1024 agentes completos:
Oito vezes mais agentes do que na execução com 128 acrescentaram cerca de 4 pontos, na única tarefa em que se experimentou.
A curva sobe. Sobe devagar, e cada passo custa muito mais agentes do que o anterior.
O número mais prático do artigo não é a pontuação final. É a rapidez com que cada configuração chegou a algo útil. Os autores indicam que 128 agentes passaram uma taxa de testes aprovados de 30% aos 30 minutos. Com 32 agentes foram precisos 60 minutos, e com 8, 90.
É isto que o paralelismo compra com segurança: chegar mais cedo a um determinado nível. O teto também subiu, mas pouco. O tempo até um nível utilizável mudou muito.
Para um fundador, a distinção importa. Se o que estás a pagar é um prazo mais curto para um trabalho que, de outra forma, poderias esperar, mais agentes são uma compra de latência, e isso tem preço calculável. Se esperas que mais agentes resolvam problemas que um só agente não resolve, este artigo sugere que o efeito existe, mas é pequeno face ao número de agentes acrescentados.
O desenho é a parte que vale a pena copiar, e é mais simples do que a escala sugere. Há três peças partilhadas:
Um espaço de trabalho partilhado. Um servidor git. Cada trabalhador tem a sua cópia e o seu ramo e faz merge para um ramo principal. O git regista quem mudou o quê e deteta conflitos de merge. Se um merge fica bloqueado, o trabalhador traz o trabalho mais recente dos outros, resolve o conflito e volta a fazer merge.
Uma interface de mensagens. Canais partilhados por tarefa e mensagens diretas, entregues de forma assíncrona e com histórico, para que os trabalhadores combinem quem faz o quê e desfaçam dependências.
Um contexto partilhado. Um registo só de acréscimo com entradas tipificadas — OBSERVED, FACT, FAIL, CLAIM, PATCH_SUMMARY — que qualquer trabalhador pode pesquisar. Antes de começar, o trabalhador publica um CLAIM a descrever o âmbito que assume.
Cada trabalhador corre o mesmo ciclo: ler o contexto partilhado, reivindicar uma parte do trabalho, fazê-la, verificá-la contra os critérios de aceitação dessa parte, fazer merge e publicar o que mudou e porquê. Não há bloqueios. A sobreposição resolve-se com reivindicações e conversa.
Um pormenor mostra onde está o custo real da coordenação. Para reduzir disputas sobre quem faz o quê, os autores não arrancaram todos os agentes ao mesmo tempo. Arrancaram um a cada 30 segundos na primeira hora e, depois, um a cada 3 segundos. Mesmo com todo o desenho assente na auto-organização, a chegada teve de ser gerida.
Os autores descrevem também comportamentos que surgiram à medida que o grupo cresceu: com 8 agentes, os trabalhadores combinaram uma interface e implementaram-na cada um por si; com 128, escolheram revisores consoante quem tinha trabalhado em código relacionado; com 1024, vários trabalhadores assumiram a integração e outros retomaram tarefas abandonadas.
O artigo não divulga quanto custou qualquer destas execuções: nem totais de tokens, nem gastos em API, nem computação por ponto ganho. Indica os limites por trabalhador — até 272.000 tokens de entrada e 128.000 de saída — e um orçamento de seis horas, e mais nada.
Isso importa porque a afirmação sobre a escala é, na verdade, uma afirmação sobre o preço. «128 vezes mais agentes por 9,5 pontos» só é um bom negócio se souberes quanto custam 128 vezes mais agentes. Sem isso, os resultados mostram que mais agentes podem ajudar, não que compensem. Não vou estimar o custo a partir dos limites de tokens. Os trabalhadores não gastam necessariamente todo o limite, e uma estimativa pareceria mais precisa do que é.
A pergunta a fazer a qualquer resultado de escala de agentes
Não «a pontuação subiu?», mas «quantos pontos por dólar em cada passo, e quantos minutos poupados?». São os dois números que decidem se vale a pena comprar a próxima duplicação.
Não precisas de 1024 agentes para usar este desenho. Quase tudo é útil assim que tens mais do que um.
Cada agente regista o que assume antes de começar. A nossa análise anterior sobre dividir o trabalho entre cinco agentes de código concluiu que isolar os agentes é a parte fácil e que é ao integrar o trabalho deles que colidem: um estudo de 2026 encontrou conflitos de merge textuais em 27,67% dos pull requests de agentes. Uma reivindicação visível, feita antes de o trabalho começar, é a forma mais barata de reduzir tanto as colisões como o trabalho duplicado.
Uma entrada FAIL poupa a todos os agentes seguintes repetir um beco sem saída. É a linha mais valiosa do registo, e a que a maioria das configurações não guarda.
Ramos privados, um ramo principal, e cada conflito resolvido pelo agente que o causou. Já tens esta infraestrutura, e ela já regista quem fez o quê.
Os trabalhadores do Agensh verificam o trabalho contra os critérios da subtarefa antes do merge. Sem eles, «feito» significa o que o agente decidir.
Se a Microsoft teve de espaçar os arranques a esta escala, cinco agentes a ler ao mesmo tempo a mesma lista de tarefas vazia também vão colidir. Um pequeno intervalo entre arranques não custa nada.
Regista quanto tempo leva a chegar a «suficientemente bom» com 1, 2 e 4 agentes no teu próprio trabalho. Isso, junto com o custo, diz-te onde parar de acrescentar agentes.
É um preprint. Não passou por revisão por pares, e os resultados vêm de uma só equipa num só conjunto de testes.
São cinco tarefas e um modelo. E só uma tarefa foi corrida com 1024 agentes. O padrão pode não se manter noutras tarefas ou noutros modelos.
Não há comparação com um orquestrador. O artigo defende que um orquestrador central limita a cooperação, mas não compara o Agensh com um sistema orquestrado nas mesmas tarefas. Não sabemos, por este artigo, se foi a remoção do chefe que produziu os ganhos.
Não encontrei dados de variância. Com o que está publicado, não consigo verificar se o salto de 32 para 128 agentes é maior do que o ruído entre execuções.
O ProgramBench tem uma chave de respostas invulgarmente clara. Os agentes podem correr o programa de referência e comparar resultados a qualquer momento. A maior parte do trabalho real de software não tem esse oráculo, e verificar é muito mais difícil. O desenho pode escalar pior quando «correto» é uma questão de critério.
O custo é desconhecido. A secção 5 é uma queixa sobre dados em falta, não uma conclusão de que os ganhos são demasiado caros.
O Agensh mostra que agentes de código se conseguem coordenar a uma escala em que um chefe central não daria conta, com infraestrutura que a maioria das equipas já tem: git, um canal de mensagens e um registo partilhado. Esse desenho é útil com cinco agentes, e quase tudo se adota sem custo.
O resultado de escala é mais modesto do que o título. Passar de 1 agente para 128 acrescentou cerca de 9,5 pontos nas tarefas mais difíceis. Passar de 128 para 1024 acrescentou cerca de 4 na única tarefa em que se experimentou. O ganho mais claro foi a velocidade. E o artigo deixa de fora o único número que diria se alguma coisa disto vale a pena pagar.
Copia esta semana o registo de reivindicações e o de falhas. Antes de acrescentares mais agentes, mede o que cada um te dá, em minutos e em dinheiro.
Fonte: Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia e Furu Wei, «Agensh: Scaling Organizational Intelligence to 1,024 Agents», Microsoft Research, arXiv:2609.26781v1, 22 de setembro de 2026 — a configuração do ProgramBench, a seleção das cinco tarefas, o modelo e os limites de tokens, as taxas médias de testes aprovados de 19,31%, 20,68%, 26,52% e 28,78%, os números do pandoc de 33,89%, 50,94% e 55,06%, a melhoria relativa de cerca de 49%, os tempos de 30, 60 e 90 minutos até ao limiar, as três componentes da infraestrutura e as entradas tipificadas do contexto, o calendário de arranque escalonado e os comportamentos emergentes, tal como aí publicados. As diferenças em pontos da secção 2 são cálculos meus a partir desses números. As leituras das secções 3 a 6 são minhas. Sobre a questão anterior de como dividir o trabalho entre alguns agentes de código, ver duas formas de dividir o trabalho entre cinco agentes de código. Sobre porque é que um agente que lê tudo custa mais do que parece, ver cada ficheiro que o teu agente lê fica na fatura.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.