AI-respondenten zeiden dat 98% het antwoord wist. Bij echte mensen was dat 52%. Valideer je startup niet met synthetische gebruikers

By Surya Pratap
1 oktober 2026
9 min read
MVP Strategy

1 oktober 2026
9 min read
 Zelfverzekerd, gematigd en ernaastHover to explore
Steeds meer founders valideren ideeën zonder met iemand te praten. Ze beschrijven hun doelklant aan een taalmodel, genereren een paar honderd 'synthetische gebruikers' en vragen of die zouden kopen. De antwoorden komen snel, kosten weinig en klinken zeker. Pew Research heeft precies dat idee nu zorgvuldig getest tegen echte mensen, en juist die zekerheid is het probleem.
De cijfers komen uit twee rapporten van Pew Research Center, op 30 september 2026 gepubliceerd door Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer en Aaron Smith: 'Can AI stand in for human survey takers? Not really' en 'How synthetic polling results change based on the AI model'. Pew onderzocht opiniepeilingen, geen productonderzoek. De toepassing op founders is mijn interpretatie, vanaf sectie 3.
Pew beheert het American Trends Panel, een groot panel van echte Amerikaanse volwassenen dat het herhaaldelijk ondervraagt. Voor dit onderzoek bouwde Pew van elk panellid een 'digitale tweeling': een AI-model kreeg de demografische gegevens van die persoon en diens antwoorden op een eerdere enquête over politieke typologie, en moest daarna nieuwe enquêtes invullen zoals die persoon dat zou doen.
De tweelingen vulden drie echte enquêtes uit begin 2026 in, samen zo'n 300 vragen, met dezelfde formulering en instructies als de mensen. Daarna vergeleek Pew hun antwoorden met wat de echte mensen hadden gezegd. Het hoofdmodel was Claude Opus 4.6 van Anthropic. Een tweede rapport herhaalde de oefening met GPT-5.1 van OpenAI.
Dit komt dicht bij het beste scenario voor synthetische respondenten. Elke tweeling was gebouwd op de eigen gedetailleerde antwoorden van een echt persoon, niet op een korte persona-beschrijving.
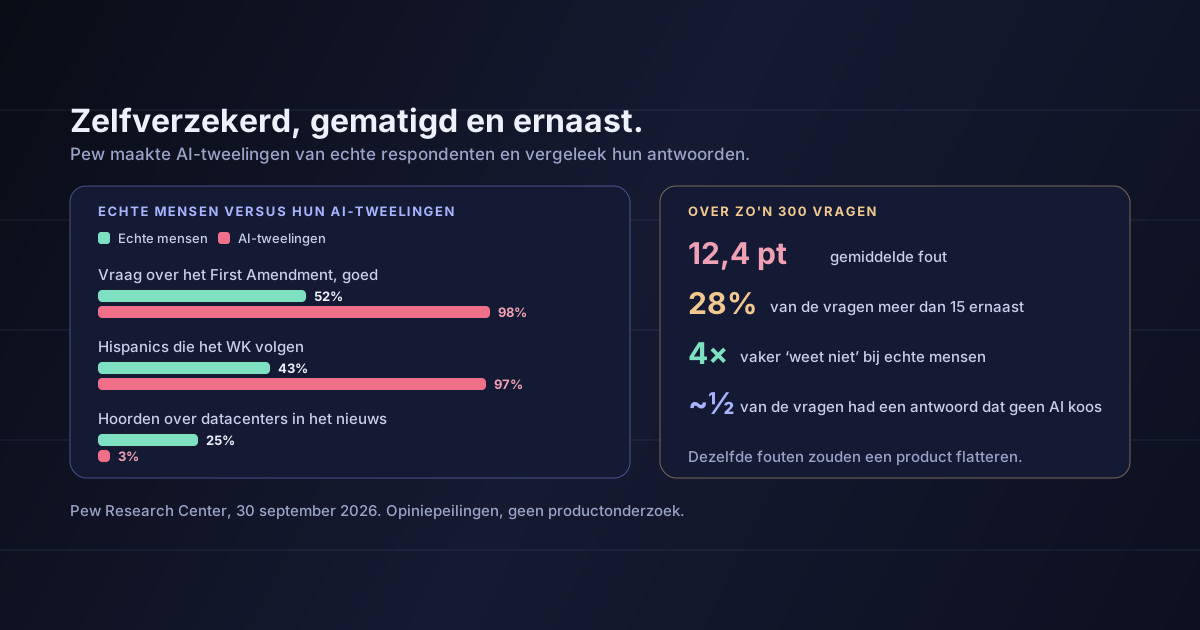
Over de drie enquêtes zaten de AI-antwoorden gemiddeld 12,4 procentpunt naast de echte. Bij ongeveer 28% van de vragen was de fout groter dan 15 punten, en verschillen van 20 tot 40 punten op afzonderlijke antwoorden kwamen vaak voor.
Een paar voorbeelden laten zien hoe die fouten eruitzien:
De conclusie van Pew: AI-modellen zijn 'geen adequate vervanging' voor het ondervragen van echte mensen over onderwerpen van breed belang, en hun uitkomsten 'verschillen op manieren die vaak onvoorspelbaar zijn'.
De tweelingen waren gebouwd op de eigen antwoorden van de echte mensen, en zaten er toch gemiddeld twaalf punten naast.
Pew vond vaste patronen in hoe de AI het mis had. Elk daarvan past bij iets wat founders synthetische gebruikers graag vragen.
Ze weten te veel. AI-tweelingen beantwoordden kennisvragen veel vaker goed dan echte mensen: 98% tegen 52% op één ervan. Een synthetische klant begrijpt je categorie, je jargon en je waardepropositie. De meeste echte klanten niet, en in dat gat gaan producten onderuit.
Ze twijfelen zelden. Echte mensen kozen ongeveer vier keer zo vaak 'weet niet' als de AI. In klantonderzoek is 'weet ik niet, nooit over nagedacht' vaak het belangrijkste antwoord dat je kunt krijgen. Synthetische gebruikers geven het bijna nooit.
Ze slaan de uitersten over. Bij bijna de helft van de vragen werd minstens één antwoordoptie door geen enkele AI-respondent gekozen. De mensen die nooit zouden kopen, en de kleine groep die morgen zou kopen, zijn precies degenen die een synthetische steekproef weglaat.
Ze spelen het stereotype. AI-tweelingen antwoordden als de karikatuur van hun groep: 97% van de Hispanic tweelingen volgde het WK tegen 43% in werkelijkheid, 95% van de Republikeinse tweelingen was positief over Israël tegen 58%. Beschrijf je ideale klant, en het model antwoordt als het cliché van die klant.
De vijfde fout doet er het meest toe voor alles wat nieuw is. De grootste missers zaten bij recente gebeurtenissen — de vraag over datacenters zat er 22 punten naast — ook al had het model toegang tot eerdere trends. Een nieuwe productcategorie is per definitie iets wat echte mensen nog niet zijn tegengekomen. Juist daar zijn synthetische antwoorden het minst betrouwbaar.
Pew's tweede rapport liet dezelfde digitale tweelingen draaien op twee verschillende modellen. Ze waren het net zo oneens met elkaar als met de werkelijkheid.
Het ene model maakte iedereen gematigd. Het andere maakte iedereen extreem. De samenvatting van Pew: elke synthetische steekproef 'schetste een heel ander beeld van het Amerikaanse publiek', en 'geen van beide weerspiegelde de werkelijke publieke opinie echt'.
Voor een founder betekent dit dat de 'markt' die een onderzoek met synthetische gebruikers beschrijft, deels afhangt van het model dat je toevallig gebruikt. Wissel van model, en je curve van betalingsbereidheid verschuift.
Pew zegt niet dat AI nutteloos is in onderzoek. Het noemt twee plekken waar het helpt: echte antwoorden op open vragen indelen, en de code schrijven om enquêteresultaten te analyseren. In beide gevallen verwerkt de AI wat echte mensen zeiden, in plaats van het te verzinnen.
Voor founders levert dezelfde regel een bruikbare lijst op:
Laat een model vragen voorstellen en schrap daarna de sturende. Het gaat snel, en niets wat het oplevert telt als bewijs.
Haal je enquête door een model om verwarrende of dubbele vragen te vinden voordat echte mensen hem zien.
Laat een sceptische koper naspelen om je pitch te oefenen. Zie het als sparren, niet als voorspelling van wat kopers gaan zeggen.
Gebruik een model, nadat je met echte mensen hebt gepraat, om thema's in je notities te labelen. Dat is het gebruik dat Pew onderschrijft.
Wat het niet kan, is je vertellen of mensen willen wat je bouwt, hoeveel mensen dat zijn, of wat ze zouden betalen.
Vijf echte gesprekken met mensen die het probleem hebben, vertellen je meer dan vijfhonderd synthetische, omdat ze je kunnen verrassen. Ze kunnen 'weet niet' zeggen, 'nooit van gehoord' of 'dat hebben we jaren geleden met een spreadsheet opgelost' — precies de antwoorden die de AI volgens Pew bijna nooit geeft.
Heb je die gesprekken nog nooit opgezet, dan beschrijven onze gidsen over een discovery call voorbereiden en over interesse uit een community omzetten in een eerste betalende klant hoe je dat aanpakt.
Pew onderzocht publieke opinie, geen productvraag. De vragen gingen over politiek, actualiteit en kennis. Ik pas de patronen toe op klantonderzoek omdat het mechanisme hetzelfde is, maar Pew testte geen productvragen.
Er zijn twee modellen vergeleken. Claude Opus 4.6 was het hoofdmodel, en de vergelijking voegde GPT-5.1 toe. Het hoofdcijfer van 12,4 punten is het gemiddelde over drie enquêtes; de modelvergelijking geeft 11,4 punten voor Claude en 13,3 voor GPT op de vragen die erin zaten. Andere modellen, prompts of methoden kunnen het beter of slechter doen.
Betere methoden kunnen het gat verkleinen. Pew zegt dat zelf: nieuwere modellen en nieuwe manieren om synthetische steekproeven te bouwen kunnen kleinere fouten opleveren. Dit is een meting van nu, geen blijvende grens.
Jouw synthetische gebruikers zijn waarschijnlijk op minder gebouwd. De tweelingen van Pew waren gebouwd op de eigen gedetailleerde antwoorden van elke persoon. De meeste persona's van founders zijn een alinea beschrijving. Dat wijst erop dat synthetische gebruikers van een founder het slechter zouden doen, maar dat is mijn afleiding, niet iets wat Pew heeft getest.
Pew bouwde de zorgvuldigste versie van synthetische respondenten waarop de meeste founders kunnen hopen — AI-tweelingen van echte mensen, gebouwd op hun eigen antwoorden — en die zaten er toch gemiddeld zo'n 12 punten naast. Ze wisten meer dan echte mensen, waren zekerder dan echte mensen, vermeden de uitersten en antwoordden als het stereotype van hun groep. Bij nieuwe onderwerpen deden ze het het slechtst. En een ander model gaf een ander beeld.
Voor een startup zijn dat geen randgevallen. Het zijn precies de fouten die een product gewilder, beter begrepen en breder aantrekkelijk laten lijken dan het echt is.
Gebruik AI om klantgesprekken voor te bereiden en te analyseren. Niet om ze te vervangen.
Bronnen: Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer en Aaron Smith, 'Can AI stand in for human survey takers? Not really', Pew Research Center, 30 september 2026: de methode met digitale tweelingen, de drie enquêtes van het American Trends Panel uit begin 2026 met zo'n 300 vragen, de gemiddelde fout van 12,4 punten, het aandeel vragen boven 15 punten, de voorbeelden over datacenters, het First Amendment, de NAVO en het WK, het viervoudige verschil in 'weet niet', de antwoordopties die geen AI-respondent koos, de voorbeelden van stereotypen en de conclusies van Pew over wat AI wel en niet kan. Dezelfde auteurs, 'How synthetic polling results change based on the AI model', Pew Research Center, 30 september 2026: de vergelijking tussen Claude Opus 4.6 en GPT-5.1, de fouten van 11,4 en 13,3 punten, de percentages middenantwoorden, de voorbeelden van onenigheid tussen modellen en het voorbehoud over toekomstige methoden. De citaten zijn hier vertaald weergegeven. De toepassing op klantonderzoek in secties 3 tot en met 6 is van mij.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.