Twee manieren om vijf coding agents uit te waaieren — de ene verspilt er vier, de andere botst in 41,7% van de gevallen

By Surya Pratap
22 september 2026
12 min read
AI & Technology

22 september 2026
12 min read
 Redundante en verdelende uitwaaieringHover to explore
Dit jaar kwam er een toolcategorie bij zonder dat iemand haar erg hard benoemde, en het interessante eraan is niet wat ze goed doet. Het is wat ze stilletjes bij jou laat liggen.
Dit artikel werkt vanuit Orca, de MIT-gelicentieerde omgeving voor parallelle agents van Stably AI, en de uitleg van ArshTechPro van 20 september 2026; de AgenticFlict-dataset van Daniel Ogenrwot en John Businge; de studie van Xu, Subramanian en Karthik naar gelijktijdige pull requests van agents; en de analyse die Daniel Vaughan van die studie maakte. Sectie 8 zegt welke cijfers ik vertrouw en hoe ver. Het onderscheid tussen de twee uitwaaieringen, het argument van de naden en elke aanbeveling zijn van mij.
De agent development environment — ADE, en ja, we zitten met opzet één letter van IDE af — is een desktopapplicatie die geen model bevat. Ze bevat een vloot.
Orca is degene die doorbrak. MIT-gelicentieerd, draait op macOS, Windows en Linux met een mobiele companion-app, en de eigen pitch is botweg: "Draai Codex, ClaudeCode, OpenCode of Pi naast elkaar — elk in een eigen worktree, op één plek gevolgd." Het ondersteunt een stuk of dertig met naam genoemde CLI-agents en in de praktijk elke willekeurige. Toen ik de repository op 22 september bekeek stond die op ongeveer 75.000 sterren; reviews van deze zomer noemen cijfers rond de 60.000, dus de curve is steil genoeg dat elk getal dat je leest al achterhaald is.
Het mechanisme is een git-primitief dat er sinds 2015 ligt en ineens een killer-toepassing heeft:
Eén taak, één worktree. Elke agent krijgt een eigen checkout-map die dezelfde object store deelt — een echt bestandssysteem, een echte branch, geen gestash.
Eén worktree, één terminal. De sessie van de agent, de testruns en de preview-server vallen allemaal binnen die map.
Geen gevecht om .git/index.lock. Het scenario waarin twee agents dezelfde werkmap beschrijven en elkaar corrumperen kan simpelweg niet optreden.
Diffs die je kunt annoteren. Je zet markdown-opmerkingen op specifieke diff-regels, bundelt ze en stuurt ze als feedback terug naar de agent.
Dit is goed engineeringwerk en het lost een echte ergernis op. Als je ooit een tweede taak hebt willen starten terwijl een agent zich door de eerste worstelde, weet je precies welk probleem hier wordt aangepakt.
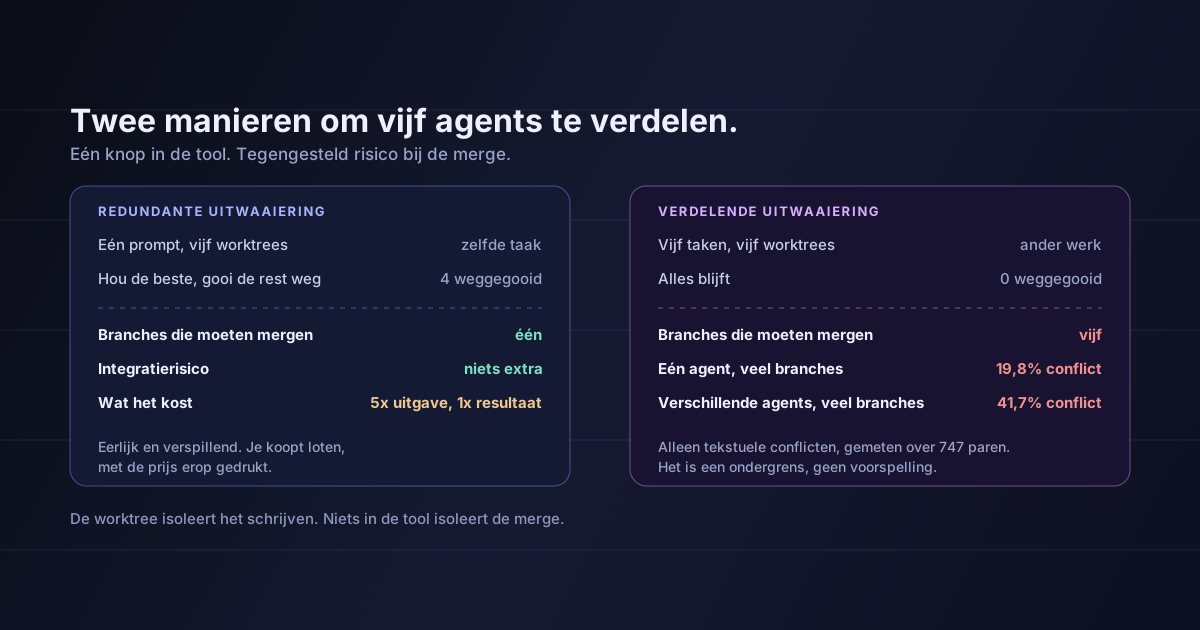
De worktree isoleert het schrijven. Niets in de tool isoleert de merge.
Dit is wat me dit wilde laten schrijven. De tool biedt één gebaar — waaier dit uit over vijf agents — en dat ene gebaar dekt twee volstrekt verschillende operaties.
Redundante uitwaaiering is de demo. Eén prompt, vijf agents, vijf worktrees, vijf pogingen tot dezelfde taak. Je leest de vijf diffs, houdt de beste en verwijdert vier branches. De eigen tekst van Orca beschrijft het: waaier één prompt uit over vijf agents, vergelijk de resultaten, merge de winnaar.
Verdelende uitwaaiering is waar je naartoe groeit. Vijf verschillende taken, vijf worktrees, vijf agents, en aan het eind wil je alle vijf. Er gaat niets weg, want weggooien was nooit het punt — het punt was vijf dingen doen in de tijd van één.
In de interface zien ze er hetzelfde uit. Ze zijn elkaars tegendeel.
| Redundante uitwaaiering | Verdelende uitwaaiering | |
|---|---|---|
| Wat varieert | De agent of de seed | De taak |
| Branches die je houdt | Eén | Allemaal |
| Branches die moeten mergen | Eén | Allemaal |
| Extra integratierisico | Geen | Het onderwerp van dit artikel |
| Wat je betaalt | N× uitgave voor 1× resultaat | N× uitgave voor N× resultaat, min de conflicten |
Redundante uitwaaiering is een eerlijk geprijsd lot. Je geeft vijf keer uit om één resultaat te krijgen, en je weet vooraf dat vier vijfde van de uitgave wordt weggegooid. De reviewer die in de berichtgeving wordt geciteerd zegt het onomwonden: Claude Code drie keer parallel draaien gebruikt drie keer je quotum. Er zijn geen verborgen kosten, omdat de verspilling juist het zichtbare deel is.
Bij verdelende uitwaaiering zitten de verborgen kosten wel. Het oogt zuiniger — er gaat niets weg! — en precies daarom stapt men erop over, meestal binnen een week na installatie.
Drie stukken empirisch werk uit 2026 raken hieraan, en samen gelezen vertellen ze een samenhangend verhaal.
Hoe gewoon is gelijktijdig agentwerk al?
Xu, Subramanian en Karthik namen 33.596 door agents geschreven pull requests in 2.807 repositories door. Bij exacte overlap in de tijd was 79,4% van de agent-PR's tegelijk actief met een andere agent-PR, in 40,2% van de repositories. Verbreed je het venster tot een week, dan is het 95% van de PR's in 53,4% van de repositories.
Verdelende uitwaaiering is geen randpraktijk die iemand zou kunnen proberen. Het is de standaardtoestand van elke repository waar agents in werken.
Hoe vaak botst dat werk?
De AgenticFlict-dataset van Daniel Ogenrwot en John Businge is de brede: ruim 142.000 pull requests van agents uit meer dan 59.000 repositories, waarvan er ruim 107.000 opnieuw zijn afgespeeld met deterministische merge-simulatie. De uitkomst: 27,67% — ruim 29.000 PR's — leverde tekstuele merge-conflicten op, verspreid over meer dan 336.000 afzonderlijke conflictregio's.
De vergelijking die het scherp maakt: eerdere studies van door mensen geschreven pull requests komen doorgaans uit op 10 tot 20%. Bijdragen van agents botsen dus anderhalf tot tweeënhalf keer zo vaak als die van mensen.
Maakt het uit wélke agents?
Dit is de bevinding die het product herkadert. Xu en collega's draaiden merge-simulaties op 747 PR-paren en splitsten ze:
De vlaggenschipfunctie is het slechtste geval
Paren van verschillende agents botsten ongeveer twee keer zo vaak als paren van dezelfde agent. De kopcapaciteit van elke ADE — draai Claude Code én Codex én Cursor naast elkaar, want waarom trouw blijven aan één — is in verdelende modus juist de configuratie waar de data het minst van houden. Twee agents die anders getraind zijn, vanuit andere systeembestanden gestart worden en andere opvattingen hebben over naamgeving, bestandsindeling en waar een helper thuishoort, gaan structureel uiteenlopen op manieren die twee runs van dezelfde agent meestal vermijden.
Eerlijkheidshalve: in het wild is overlap tussen verschillende agents nog zeldzaam — slechts 0,5% van de gelijktijdige paren betrof verschillende agents, in 122 van 2.807 repositories. De 41,7% beschrijft wat er gebeurt als je het doet, gemeten op een kleine steekproef. En de hele waardepropositie van de ADE is om precies dat zeldzame makkelijk te maken.
Ontleed wat die conflicten werkelijk zijn en het beeld gaat niet langer over versiebeheer. Uit de analyse die Vaughan van de studie maakte, splitsen de botsende paren zich in drieën:
| Conflictklasse | Aandeel | Wat het werkelijk betekent |
|---|---|---|
| Tekstuele overlap | 57,6% | Twee agents bewerkten dezelfde regels. Een fout in de verdeling: je gaf twee mensen één bureau |
| Wijzigen / verwijderen | 26,8% | De ene agent wijzigde wat de andere verwijderde. Een architectuurbesluit dat niemand nam, twee keer genomen, verschillend |
| Toevoegen / toevoegen | 15,1% | Beide agents maakten hetzelfde bestand aan. Een fout in de specificatie: geen van beide wist dat de ander het nodig had |
Alleen de eerste is een merge-probleem. De andere twee — samen ruwweg 42% — zijn structureel, laten zich niet mechanisch oplossen en zijn eigenlijk helemaal geen conflicten tussen branches. Het zijn conflicten tussen twee plannen, ontdekt op het slechtst denkbare moment: nadat beide plannen volledig zijn geïmplementeerd.
Een toevoegen/toevoegen-conflict is bijzonder veelzeggend. Twee agents concludeerden onafhankelijk dat er een bestand moest bestaan, verzonnen het, en geen van beide wist van de ander. Geen enkele hoeveelheid merge-gereedschap repareert dat. De reparatie ligt stroomopwaarts, in wat je ze hebt verteld.
En let op waar deze conflicten landen: 84,4% van de botsende bestanden was broncode, geen lockbestanden of dependency-manifesten. Dit is niet het saaie maar mechanische conflict dat je oplost door die van de ander te nemen. Het is het soort waarbij je beide kanten moet begrijpen.
Dit is het stuk dat ik zou onderstrepen als ik maar één alinea mocht houden.
Al deze percentages gaan uitsluitend over tekstuele conflicten. De auteurs zeggen het met zoveel woorden: de cijfers zijn een conservatieve ondergrens die buildfouten en semantische conflicten uitsluit. Ze meten dus de gevallen waarin git stopte en het je vertelde.
Het gevaarlijke geval is het andere.
Het conflict dat schoon merget
Twee agents in twee worktrees. De ene hernoemt een functie en werkt elke aanroep bij die hij kan zien. De andere voegt een nieuwe aanroep toe, in een bestand dat de eerste nooit heeft geopend, op de oude naam. Verschillende bestanden. Geen overlappende regels. Git merget het zonder morren — en nu heb je een branch die niet compileert of, erger, eentje die dat wel doet. Verander een validatieregel in de ene branch en vertrouw in de andere op de oude regel: je krijgt groene CI en een bug die twee weken later in productie opduikt. Er bestaat geen conflictmarkering voor "deze twee wijzigingen zijn het oneens over wat waar is".
Worktrees isoleren op het niveau van het bestandssysteem. Ze coördineren niet op semantisch niveau, en twee branches kunnen volledig losstaande bestanden raken en elkaar toch tegenspreken — via routetabellen, gebundelde exports, gedeelde typedefinities, configuratie, databaseschema's of gewoon een aanname over hoe iets zich gedraagt.
De eerlijke lezing van 27,67% is dus: dat is het deel waar het probleem zichzelf aankondigde. Niemand heeft gemeten hoe groot het deel is waar dat niet gebeurde, en nul is het niet.
Dit is de herkadering waarop ik zou bouwen, en ze gaat helemaal niet over tooling.
Elke ADE nodigt je uit de vraag hoeveel agents moet ik draaien? te beantwoorden met een getal uit je budget of uit je machine. Vijf voelt goed. Vijf is wat de marketing laat zien. Maar de echte beperking heeft niets met quota te maken:
Je kunt zoveel agents parallel draaien als je codebase naden heeft — grenzen waarover twee wijzigingen geschreven kunnen worden zonder elkaar te hoeven zien.
Een naad is een module met een stabiele interface, een service achter een API-contract, een migratie die alleen toevoegt, een component die niemand anders importeert. Heeft je codebase vier echte naden, dan is vier agents het plafond. Acht draaien betekent dat er vier schrijven tegen aannames die de andere vier op dat moment veranderen, en je ontdekt welke bij de merge, tegen de percentages hierboven.
Dit verklaart iets dat anders een paradox lijkt: teams met een goed gefactoreerde codebase melden dat parallelle agents prachtig werken, teams met een verknoopte melden chaos, en beide draaien exact dezelfde software. De tool is niet de variabele. Het aantal naden wel.
Het geeft ook het eerlijke antwoord op moeten we dit aanschaffen? Heb je drie naden, dan koop je met een vlootbeheerder voor twaalf agents capaciteit die je niet kunt gebruiken. Het werk dat parallellisme ontsluit is hetzelfde saaie modulariteitswerk als altijd — een onbevredigende conclusie, en ik denk een ware.
Vijf dingen, op volgorde, en geen ervan vraagt je te stoppen met een tool die je bevalt.
Je hebt geen studie nodig; je hebt git merge-tree nodig. Neem de branches die je agents de afgelopen maand maakten, speel elk paar af tegen hun merge-base en tel hoeveel er botsen. Dat getal is van jou: het weerspiegelt de nadenstructuur van jouw codebase, niet het gemiddelde van de sector. Zit het ruim onder 19,8%, dan is je verdeling beter dan gebruikelijk en kun je verder uitwaaieren. Zit het boven 40%, dan voegen extra agents vooral herstelwerk toe.
Een merge-simulatie is goedkoop genoeg om in een hook te draaien telkens als een agent een bestand schrijft. Dat twee agents op dezelfde regels afstevenen is bij minuut drie enorm waardevolle informatie en bij uur twee bijna niets meer waard, als beide al op de botsing hebben doorgebouwd.
Benoem vóór een uitwaaiering welke paden elke taak mag raken — en beschouw een agent die buiten zijn set grijpt als signaal dat de taak verkeerd afgebakend was, niet als iets om door te laten. AGENTS.md is de juiste plek voor grenzen die over taken heen gelden; zie wat de beste repositories er werkelijk in zetten.
Laat één branch landen, rebase de volgende op de nieuwe basis en geef de agent bij een conflict de gerebasete basis, zodat hij de wijziging opnieuw doet in plaats van dat jij met de hand een conflict oplost tussen twee dingen die je niet hebt geschreven. Dat de agent zijn eigen werk afstemt op de actuele werkelijkheid is een betere uitkomst dan dat jij rechter speelt tussen twee plannen waar je niet bij was.
19,8% tegenover 41,7% is de goedkoopste beslissing in dit hele artikel. Bewaar de vergelijking tussen meerdere agents voor redundante uitwaaiering, waar je een winnaar kiest en de rest weggooit: daar is uiteenlopende stijl juist het hele punt en kost het je niets, omdat er maar één branch landt.
De vuistregel onder alle vijf:
Gebruik veel agents als je één resultaat gaat houden, en één agent als je er veel gaat houden. De ADE maakt van beide één klik, en juist daarom moet dit onderscheid in jouw hoofd zitten.
747 paren is een kleine steekproef en het interval tussen verschillende agents is breed. Het cijfer van 41,7% draagt een 95%-betrouwbaarheidsinterval van 33,1 tot 50,9%. De richting — tussen verschillende agents fors slechter dan binnen één agent — is de bevinding waar ik naar zou handelen. De tweede decimaal niet.
De 27,67% van AgenticFlict is geen voorspelling voor jouw repository. Het is een populatiepercentage over 59.000 repositories met sterk uiteenlopende structuren, reviewculturen en agentgebruik. Een goed gefactoreerde codebase met strak afgebakende taken komt er ver onder uit. Het is een reden om te meten, geen getal om mee te plannen.
De menselijke basislijn van 10 tot 20% komt uit andere studies met andere methoden. Ertussen vergelijken is qua richting bruikbaar en is geen gecontroleerd experiment. PR's van agents zijn bovendien meestal groter en sneller gemaakt, en een deel van het verschil zit vast daarin en niet in iets wat eigen is aan agents.
Ik beweer niet dat de ADE een slechte tool is. Isolatie via worktrees is regelrecht correct, en de lus van annoteren en terugsturen naar de agent is het beste in de categorie. Mijn betoog gaat over het gat tussen wat de tool oplost en wat een founder aanneemt dat ze oplost — niet over de kwaliteit van wat ze doet.
Sterren zijn geen adoptie en zeker geen retentie. 75.000 sterren in een snel bewegende categorie vertelt je dat de aandacht er is. Het vertelt je niets over hoeveel van die repositories de tool in maart nog gebruiken.
Niets hiervan is gemeten op de semantische conflicten, ook door mij niet. Ik heb betoogd dat ze bestaan en dat de gepubliceerde percentages het probleem dus onderschatten. Ik kan je niet zeggen met hoeveel, en niemand anders kan dat voorlopig ook niet.
Coding agents parallel draaien hield dit jaar op een moeilijk probleem te zijn. Geïsoleerde worktrees, één klik, dertig ondersteunde agents, MIT-gelicentieerd, werkt op je telefoon. Dat deel is af.
Landen wat ze produceren is niet af, is aantoonbaar lastiger dan menselijk werk laten landen, en is de helft die geen enkele ADE claimt op te lossen — omdat het niet in de tool oplosbaar is. Het hangt af van hoe je code gefactoreerd is en hoe precies je taken afgebakend waren, en beide waren jouw werk voordat dit alles bestond.
Het patroon is dat wat zich in agentic engineering blijft herhalen: de bottleneck verdwijnt niet, hij verplaatst zich, en hij verplaatst zich naar wat nog oordeel vergt. Genereren werd parallel. Integreren niet, en integreren is waar het oordeel zit.
Tel je naden voordat je de uitwaaiering vergroot. Is dat getal kleiner dan het aantal agents dat je wilde draaien, dan koop je geen doorvoer — dan koop je merge-conflicten tegen een gedocumenteerd percentage, en betaal je per agent de volle prijs voor dat voorrecht.
Bronnen: Orca op GitHub — de MIT-licentie, de lijst met ondersteunde agents, het isolatiemodel per worktree, de beschrijving van één prompt uitwaaieren over vijf agents en het aantal sterren per 22 september 2026. ArshTechPro, "Orca Explained", 20 september 2026 — de ADE-kadering, de structuur van worktree plus terminal plus preview, de lus van diff-annotatie en de opmerking dat parallelle agents het verbruik vermenigvuldigen. Ogenrwot en Businge, "AgenticFlict" — de 142.000 pull requests, 59.000 repositories, 107.000 merge-simulaties, het percentage van 27,67% tekstuele conflicten, de 336.000 conflictregio's en de menselijke basislijn van 10 tot 20% uit eerder werk. Xu, Subramanian en Karthik, "AI Agent Pull Requests on GitHub" — de 33.596 PR's in 2.807 repositories, de cijfers van 79,4% en 95% gelijktijdigheid, de simulatie over 747 paren, de percentages van 19,8% en 41,7% met hun betrouwbaarheidsintervallen, het aandeel van 0,5% paren tussen verschillende agents en de 84,4% broncodebestanden. Daniel Vaughan, "When Agents Collide", 28 juli 2026 — de conflicttaxonomie 57,6% / 26,8% / 15,1% en de observatie dat isolatie via worktrees mapbotsingen voorkomt maar merge-conflicten niet. Het onderscheid tussen redundante en verdelende uitwaaiering, de koppeling van de conflictklassen van git aan fouten in verdeling, architectuur en specificatie, het argument van de naden en elke aanbeveling in sectie 7 zijn van mij. Voor het argument dat de bottleneck zich verplaatst, zie de CI-cijfers van Anthropic, en over wie al dat werk zou moeten reviewen, neem eerst de reviewer aan, dan de programmeur.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.