
GLM en andere open modellen trainen op je eigen code: wat het je echt oplevert (2026)

By Surya Pratap
29 juli 2026
11 min read
AI & Technology

29 juli 2026
11 min read
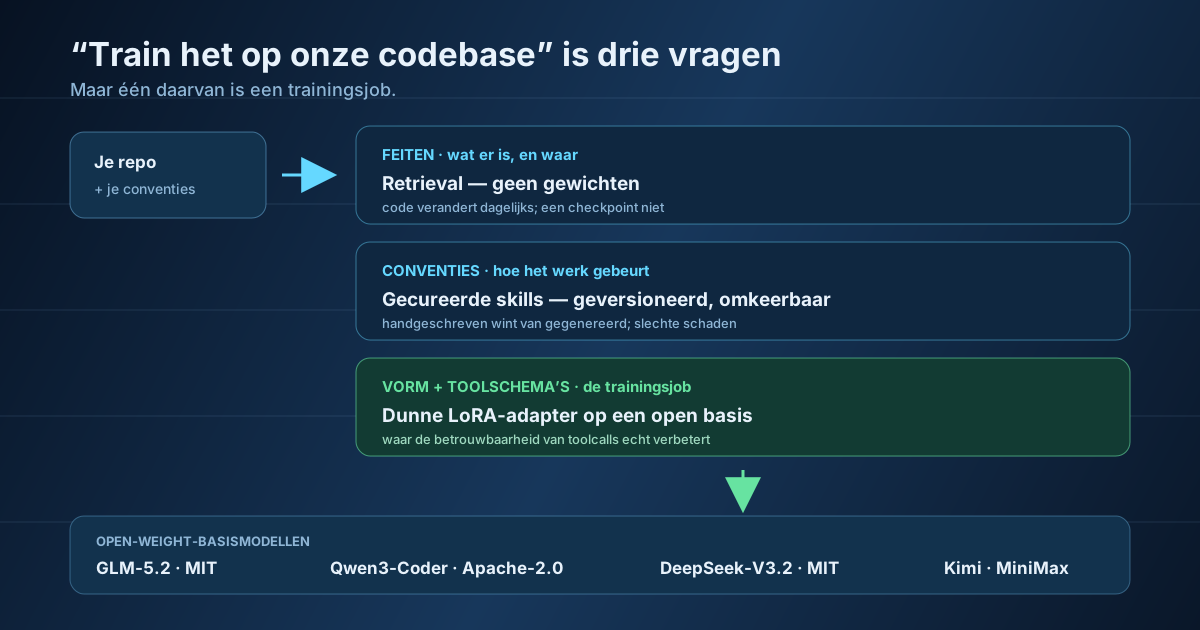
Om de paar weken stelt een founder een variant van dezelfde vraag: kunnen we een open model als GLM nemen, het trainen op onze codebase en een agent krijgen die code schrijft zoals ons team code schrijft? Het is een goed instinct, en in 2026 eindelijk ook een redelijk instinct: het open-weight-veld is sterk genoeg om op te bouwen, en een fine-tune die vroeger tienduizenden kostte, kost nu minder dan een lunch. Maar het verzoek verbergt een valkuil. 'Train het op onze codebase' zijn eigenlijk drie aparte vragen in één jas, en maar één daarvan is een trainingsjob. Teams die fine-tunen voordat ze die uit elkaar halen, zijn een maand bezig met een model dat in de huisstijl schrijft en nog steeds niet weet welke service eigenaar is van de retry van de facturatie.
Dit is een praktische gids om het in de juiste volgorde te doen: hoe het open-weight-veld er nu uitziet, hoe je de drie vragen uit elkaar haalt, wat een LoRA-adapter meetbaar oplost, wat het geheel kost en hoe je een basismodel kiest op je eigen repo in plaats van op het leaderboard van een ander.
Begin bij de vraag waarom dit überhaupt de moeite waard is. GLM-5.2, in juni 2026 uitgebracht door Z.ai, is een mixture-of-experts-model van 744 miljard parameters met een contextvenster van een miljoen tokens, volledige gewichten op Hugging Face en een MIT-licentie. Het is expliciet gebouwd voor programmeren, redeneren en agentisch werk met tools, en het komt op een belangrijke agentische benchmark tot op ongeveer een procentpunt van Opus 4.8 van Anthropic, tegen ongeveer een vijfde van de kosten. Het MIT-deel is belangrijker dan de benchmark: je mag erop trainen, het uitrollen en het hosten zonder iemand iets te vragen.
Het is niet de enige optie, en de juiste basis hangt af van de vorm van je workload. Qwen3-Coder-480B is Apache-2.0 en zit rond 69,6% op SWE-bench Verified, met kleinere varianten die veel makkelijker zelf te hosten zijn. DeepSeek-V3.2 heeft een MIT-licentie en haalt ongeveer 70%. Kimi K2.6 is de keuze voor multimodaal en multi-agentwerk, en MiniMax M3 voor goedkope jobs met hoge doorvoer. In de praktijk is GLM-5.2 de sterkste standaardkeuze voor agentwerk met lange context en lange horizon, terwijl Qwen3-Coder is waar de meeste teams uitkomen als ze iets nodig hebben dat draait op hardware die ze zelf beheren.
Eén kanttekening bij de cijfers: GLM-5.2 verscheen zonder gepubliceerde onafhankelijke benchmarks en werd door de maker gepositioneerd als beter dan eerdere versies op programmeerwerk met lange horizon. Behandel elk cijfer in deze sectie als filter, niet als besluit. Wat ons brengt bij het deel dat er echt toe doet.
Benchmarks filteren, je repo beslist
Neem de uiteindelijke beslissing met een privé-evaluatieset die is opgebouwd uit je eigen taken, gedraaid op het exacte gekwantiseerde checkpoint dat je gaat uitrollen, binnen hetzelfde agentframework dat je in productie gebruikt. Een model dat bovenaan een leaderboard staat op volle precisie, kan zich op 4 bit binnen jouw harness heel anders gedragen.
Wanneer iemand zegt een model te willen dat op zijn code is getraind, wil hij meestal drie verschillende dingen tegelijk. Ze apart benoemen is het grootste deel van het werk.
De eerste vraag gaat over feiten. Wat er in de codebase bestaat, waar het staat, welke service eigenaar is van welke tabel, wat die helper eigenlijk teruggeeft. Dit is kennis, en kennis verandert: je repo verandert dagelijks, een set gewichten niet. Feiten in een checkpoint bakken betekent hertrainen elke keer dat iemand merget. Deze vraag hoort bij retrieval, en blijft daar permanent. De consensus in 2026 is er bot over: als het antwoord afhangt van data die verandert, gebruik dan retrieval, en fine-tune alleen voor gedrag dat niet hoort te veranderen.
De tweede vraag gaat over conventies. Hoe je team dingen doet: de reviewchecklist, de migratieprocedure, de manier waarop fouten worden ingepakt, de regel dat niets buiten een repositoryklasse met de database praat. Het lijkt een trainingsprobleem en is dat bijna nooit. Gecureerde skill-bestanden, gewone instructies die beschrijven wanneer en hoe je iets doet, geven je direct hetzelfde gedrag, werken met elke modelprovider en kun je bewerken, versioneren, testen en terugdraaien zonder een checkpoint aan te raken. Fine-tunen verandert gedrag permanent en is traag en lastig terug te draaien; een skill-bestand is een pull request.
Er is hier een belangrijke kanttekening, en het is een van de nuttigere onderzoeksbevindingen van het jaar: de aanwezigheid van skills alleen garandeert niets. Automatisch gegenereerde skills leveren gemiddeld niets op, gecureerde, door mensen geschreven skills verslaan consequent de baseline zonder skills, en skills van lage kwaliteit verslechteren de prestaties van de agent meetbaar. Laat een model dus niet op je repo los met de vraag om zijn eigen conventies te schrijven. Laat je sterkste engineer er tien echte schrijven, met de hand, op basis van dingen die in reviews echt misgaan.
De derde vraag gaat over vorm en toolschema's, en dit is wél een echte trainingsjob. Het model je interne API-calls laten uitsturen met jouw parameternamen, je outputstructuur exact laten volgen en betrouwbaar de juiste tool uit je eigen toolset laten kiezen: dat is precies waar fine-tunen goed in is. Dit is vorm, geen feiten, en het is stabiel op een manier die bestandslocaties niet zijn.
Het duidelijkste gepubliceerde voorbeeld van de derde vraag is een team dat een model nodig had dat hun specifieke toolschema's en parameternamen begreep. Het slagingspercentage van de toolcalls van hun agent was 40%, en wie weleens een agent heeft gelanceerd, herkent dat als het getal waarbij niets werkt en iedereen het model de schuld geeft. Na een QLoRA-fine-tune zaten ze op 90%. De run kostte alles bij elkaar ongeveer $1.500 op één RTX 4090, en kwam op elke gemeten benchmark binnen 1% van een volledige fine-tune.
Let op wat er verschoof. Niet de kennis van het model over hun systeem, en niet zijn algemene programmeervaardigheid, maar zijn naleving van hun interface. Dat is de eerlijke belofte van trainen op je eigen code: agents die niet meer met je tools stuntelen. Faalt je agent nu omdat hij parameternamen verzint, misvormde structuren teruggeeft of de verkeerde tool kiest, dan lost een adapter dat op. Faalt hij omdat hij je architectuur niet kent, dan doet een adapter dat niet, en geen enkele hoeveelheid training doet dat.
De ruwe rekenkracht is inmiddels bijna gratis. Een LoRA- of QLoRA-fine-tune van een model van 7–8B kost $3–$10 aan GPU-tijd: twee tot vier uur op een gehuurde A100, minder dan $3 op een 4090 die je al hebt. Een QLoRA-run op 70B komt uit rond $15–$30. Managed services rekenen ongeveer $0,48–$0,50 per miljoen tokens, dus een typische job van 50M tokens op een 8B-model kost zo'n $25 gehost tegenover $3–$10 als je het zelf doet. LoRA is in de overgrote meerderheid van de gevallen de juiste keuze, en adapters combineren verrassend goed: een adapter voor codestijl en een adapter voor security-redeneringen zitten elkaar grotendeels niet in de weg.
De GPU-rekening is niet de kostenpost
Trainen kost $10. Het echte budget gaat naar het cureren van voorbeelden die laten zien hoe je team echt werkt, en naar het bouwen van de evaluatieset die je vertelt of de adapter heeft geholpen. Teams die beide overslaan, krijgen een model dat zelfverzekerd anders is in plaats van meetbaar beter, en hebben geen manier om te zien welke van de twee.
De volgorde waar praktijkmensen in 2026 op uitkwamen is prompt, dan retrieval, dan fine-tunen, dan distilleren, en de fine-tune met het hoogste rendement is een dunne LoRA-adapter op een sterk basismodel, gecombineerd met retrieval in plaats van als vervanging ervan. Elke stap is goedkoper en beter terug te draaien dan de volgende, dus wie op volgorde werkt, ontdekt vaak dat hij vroeg kan stoppen.
Die volgorde beschermt je ook tegen de duurste fout hier: je te vroeg aan een checkpoint vastketenen. Met retrieval kun je vrij van basismodel wisselen; met een fine-tune niet. Gezien hoe snel dit veld beweegt, van GLM-5.1 naar 5.2 binnen een paar maanden, wil je dat het deel van je systeem dat je bedrijfslogica vastlegt, het deel is dat je in een middag naar een beter basismodel kunt meenemen.
Er is een reden dat dit gesprek over GLM en Qwen gaat en niet over de gesloten API's. Trainen op je eigen code betekent dat je code trainingsdata wordt, en met MIT- of Apache-2.0-gewichten kun je dat hele proces binnen infrastructuur draaien die je zelf beheert. Dat is het verschil tussen een gesprek met je eigen securityteam en een gesprek met de securityteams van je klanten. Voor iedereen die werkt onder afspraken over dataresidentie of zakelijke verwerkingsvoorwaarden is zelf een open basismodel hosten vaak de enige versie van dit project die de review overleeft.
De tweede reden is overdraagbaarheid. Open weights plus een model-agnostisch agentharness betekent dat de adapter die je dit kwartaal hebt getraind, kan verhuizen naar wat volgend kwartaal bovenaan staat. Dat is een wezenlijk andere positie dan je workflow bouwen op het gehoste fine-tuningproduct van één leverancier en hopen dat de prijzen standhouden.
Wil je weten of dit je tijd waard is, begin dan niet met een trainingsrun. Begin met uitzoeken welke van de drie vragen je eigenlijk geld kost.
Doe dat op volgorde en er gebeurt een van twee dingen. Of je ontdekt dat het meeste pijn in feiten en conventies zat, en dan heb je het in een week opgelost met retrieval en skill-bestanden, gratis, en het trainingsproject helemaal overgeslagen. Of je vindt een harde kern van interfacefouten die geen enkele prompt oplost, en je besteedt $10 om een toolcall-score van 40% om te zetten in iets wat je kunt lanceren. Beide uitkomsten zijn goed. De slechte uitkomst is die waarin je met de fine-tune begint, omdat dat het interessantste deel is, en eindigt met een model dat je huisstijl goed genoeg heeft geleerd om er overtuigend fout in te zijn.
Het open-weight-veld ging dit jaar over een echte drempel: voor het eerst kan een founder een MIT-gelicentieerd codeermodel van frontierklasse nemen, het voor de prijs van een kop koffie aanpassen aan zijn eigen interfaces en het geheel draaien op hardware die hij zelf beheert. Dat is een wezenlijke verschuiving in wat een klein team kan bezitten. Het is alleen goed om te onthouden dat de hefboom zit in weten welke van de drie vragen je beantwoordt, niet in de trainingsrun zelf.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.


