Een algemeen programmeermodel weet hoe je React en Python schrijft zoals het open internet ze schrijft. Het kent de modulegrenzen van je monorepo niet, je interne RPC-framework niet, de auth-wrapper die elke service hoort te gebruiken niet, en ook niet het feit dat je team drie jaar geleden een patroon verbood na een storing. Die kloof, tussen hoe de wereld codeert en hoe jouw bedrijf codeert, is precies wat een gefinetuned model dicht. En in 2026 is het bouwen van de stack daarvoor veel toegankelijker dan de meeste engineeringleiders denken.
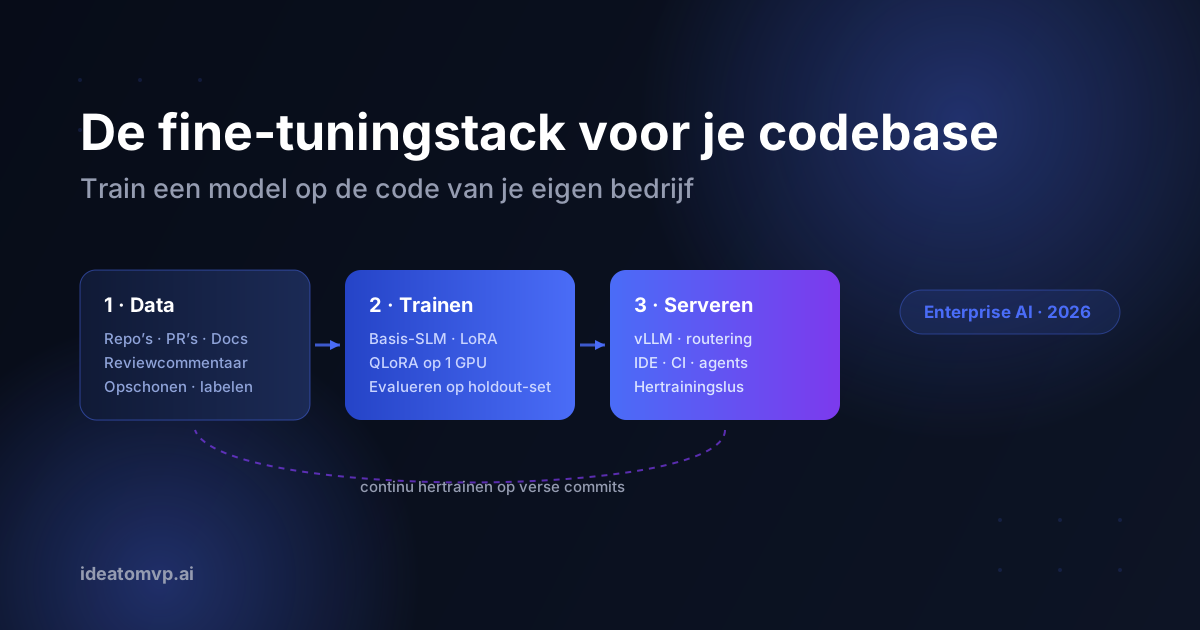
Dit is een praktische doorloop, laag voor laag, van de stack die je nodig hebt om een model te fine-tunen op een specifieke enterprise-codebase: de datapipeline, de keuze van het basismodel, de trainingslaag, evaluatie, serving en de hertrainingslus die het model actueel houdt terwijl je code verandert. Ook de beslissing die eerst komt, komt aan bod: moet je überhaupt fine-tunen, of volstaat retrieval?
Eerst: fine-tuning vs. RAG vs. lange context
Wees eerlijk over het probleem dat je oplost voordat je ook maar één GPU inzet. Hier concurreren drie tools, en ze zijn niet uitwisselbaar:
- Retrieval (RAG) leert feiten. "Wat doet deze functie? Waar is de betalingsclient gedefinieerd?" Moet je antwoorden baseren op de huidige code en docs, dan is RAG over een vectorindex van je repo goedkoper, sneller te shippen en direct bijgewerkt zodra de code verandert. Begin hier.
- Fine-tuning leert gedrag en stijl. "Schrijf code zoals wij die schrijven." De naamgevingsconventies, de idiomen voor foutafhandeling, de favoriete libraries, de vaste opbouw van een service: patronen die te diffuus zijn om in een prompt te proppen en te consistent om aan een generiek model over te laten. Daar is fine-tuning uniek goed in.
- Lange context regelt het eenmalige. Voor één grote taak volstaat het vaak om de relevante bestanden in het contextvenster van een frontier-model te plakken. Dat schaalt niet naar elke developer, elke dag, tegen voorspelbare kosten, en precies daarom stappen teams door naar fine-tuning.
Het volwassen antwoord is meestal fine-tuning plus RAG: een model dat je stijl en conventies heeft geïnternaliseerd en tijdens inferentie je actuele code ophaalt, zodat zijn feiten nooit verouderd zijn. De rest van deze gids bouwt naar die combinatie toe.
Laag 1: de datapipeline (80% van het werk)
Elke eerlijke praktijkmens zegt je hetzelfde: het model is makkelijk, de data is het project. Een fine-tune is zo goed als de voorbeelden waarvan hij leert, en een enterprise-codebase is een rommelige bron. De pipeline heeft vier fasen.
- Verzamelen. Haal data uit de bronnen die echt laten zien hoe je team bouwt: de repositories, gemergede pull requests en hun reviewcommentaar, interne ontwerpdocumenten en ADR's, opgeloste tickets en runbooks. PR's en reviewthreads zijn goud waard: ze leggen niet alleen de code vast, maar ook de redenering en de correcties.
- Opschonen en filteren. Verwijder secrets en credentials (niet onderhandelbaar, en doe het voordat er iets op een trainingsserver komt), haal gegenereerde code, meegeleverde dependencies en lockfiles weg, laat dode en verouderde modules vallen, en ontdubbel bijna identieke bestanden zodat veelvoorkomende boilerplate het signaal niet overheerst.
- Vormgeven tot voorbeelden. Bepaal het taakformaat. Voor een completion-model gebruik je fill-in-the-middle-voorbeelden (FIM) uit echte bestanden. Voor een assistent die instructies volgt, bouw je instructie–antwoordparen: "Voeg een gepagineerd endpoint toe aan deze service" gekoppeld aan de echte diff die dat deed. PR-titel en -beschrijving als instructie, de gemergede diff als antwoord: een krachtige en vrijwel gratis bron van instructiedata.
- Splitsen en achterhouden. Houd een testset apart voordat je traint, bij voorkeur de recentste commits, zodat je evaluatie echt gebruik nabootst: code voorspellen die het model nooit heeft gezien. Laat testbestanden nooit in de training lekken.
De poort voor licenties en privacy
Je trainingsdata is je gevoeligste IP. Dat is de belangrijkste reden om de hele stack te draaien op infrastructuur die je zelf beheert: een private VPC, gereserveerde GPU's of on-prem. Controleer of je het recht hebt om op elke bron te trainen (let op code van derden en copyleft-code in de monorepo), verwijder persoonsgegevens en secrets, en leg exact vast wat er in elke trainingsrun is gegaan. Als je de stack zelf bezit, wordt dit een eigenschap van de architectuur in plaats van een belofte van een leverancier.
Laag 2: het basismodel kiezen
Je traint geen model vanaf nul: je past een sterke open-weight-basis aan die programmeren al begrijpt. Kies uit de huidige generatie open codemodellen (de families Qwen-Coder, Code Llama, DeepSeek-Coder en StarCoder, plus kleine algemene modellen zoals Phi en Gemma). Drie factoren bepalen de keuze:
- Omvang tegenover de taak. Voor inline completion en afgebakende assistenttaken is een model van 3B–8B dat op je code is gefinetuned snel, goedkoop te serveren en vaak beter dan een veel groter generiek model op je eigen patronen. Bewaar 14B–34B voor echt redeneren over meerdere bestanden. Groter is niet het doel; passend wel.
- Licentie. Controleer of de weights commercieel en intern gebruik toestaan. Dat is een juridisch vinkje, geen detail: regel het voordat je op een basis bouwt.
- Contextlengte en FIM-ondersteuning. Codetaken beslaan meerdere bestanden, dus kies bij voorkeur bases met lange context en native fill-in-the-middle-training als completion je use case is.
Laag 3: de trainingslaag (LoRA / QLoRA)
Je hebt vrijwel zeker geen volledige fine-tuning nodig. Parameter-efficiënte methoden, LoRA en de gekwantiseerde variant QLoRA, trainen een kleine set adaptergewichten bovenop een bevroren basis. Daardoor kun je een 7B-model op één moderne GPU in een paar uur aanpassen, voor de prijs van een goed diner. De tooling is volwassen: libraries als Hugging Face PEFT, Axolotl en Unsloth omvatten de hele lus.
Wat er in deze laag echt toe doet:
- Adapters houden het modulair. Omdat een LoRA-adapter een klein bestand is, los van de basisgewichten, kun je één adapter per team, per taal of per service trainen en ze bij het serveren wisselen. Hertrainen is goedkoop en de impact van een fout is klein.
- Voorkom catastrofaal vergeten. Te veel trainen op een smalle codebase kan het model slechter maken in algemeen programmeren. Meng er een deel algemene codedata doorheen, houd learning rates bescheiden en stop vroeg op basis van je evaluatiecurve, niet op een vast aantal epochs.
- Leg elke run vast. Versioneer de dataset, het basismodel, de hyperparameters en de resulterende adapter samen. Gaat een model achteruit, dan moet je precies weten wat er veranderde.
Over rekenkracht: huur voordat je koopt. Een gereserveerde cloud-GPU (een A100 of H100 bij CoreWeave, Lambda of het gereserveerde niveau van een hyperscaler) is het juiste instappunt. Stap pas over op eigen hardware als het volume aan training en inferentie stabiel genoeg is om dat te rechtvaardigen.
Laag 4: evaluatie (de laag die teams overslaan en betreuren)
Een fine-tune die in een demo "beter voelt", is geen resultaat. Het verschil tussen een modelprogramma in productie en een wetenschapsproject is een echte evaluatieharnas die bij elke hertraining draait. Voor code heb je ongewoon goede opties:
- Tests op basis van uitvoering. Code is controleerbaar. Genereer completions voor achtergehouden taken, draai ze tegen je echte unittests en meet hoeveel er slagen. Bouw een interne set in SWE-bench-stijl uit je eigen opgeloste issues en hun tests: dat is het eerlijkste signaal dat je kunt krijgen.
- Controles op stijl en conventies. Haal gegenereerde code door je linters, formatters en typecheckers. Een model dat je conventies heeft geïnternaliseerd, levert code die zonder problemen door je CI-poorten komt.
- Rechtstreeks vergelijken met de baseline. Vergelijk de fine-tune altijd met het ruwe basismodel en met een sterke frontier-API op dezelfde taak. Verslaat hij ze niet allebei op jouw metriek, dan heb je iets waardevols geleerd voordat je shipt.
Laag 5: serving en de applicatielaag
Een getrainde adapter in object storage helpt niemand. De servinglaag is waar het model de developers ontmoet:
- Inferentieserver. Serveer met vLLM, TGI of Ollama voor inferentie met hoge doorvoer en lage latency, cruciaal voor completion, waar alles boven een paar honderd milliseconden kapot aanvoelt. Kwantiseer (GPTQ/AWQ) om meer gelijktijdige verzoeken op elke GPU te passen.
- Retrieval tijdens inferentie. Combineer het gefinetunede model met RAG over je actuele repo, zodat het de stijl ingebakken heeft en actuele feiten in de context. Dat is de opbrengst van fine-tuning plus RAG.
- Afleverpunt. Bied het aan waar developers al werken: een IDE-extensie voor completion, een chat-endpoint voor vragen, een CI-bot voor review, of als tool binnen een agentische workflow.
- Routering. Je hoeft niet elk verzoek vanuit je eigen model te serveren. Stuur de veelvoorkomende verzoeken binnen het domein naar je fine-tune en escaleer de zeldzame, echt moeilijke, open vragen naar een frontier-API. Zet elk verzoek op de goedkoopste laag die het goed afhandelt.
Laag 6: de hertrainingslus
Een codebase is een bewegend doelwit. Het model dat je in Q1 traint, zit er in Q3 subtiel naast, omdat je conventies, dependencies en architectuur zijn opgeschoven. Het laatste onderdeel van de stack is een lus, geen mijlpaal: haal maandelijks of per kwartaal verse gemergede PR's de pipeline in, hertrain de adapter, draai het evaluatieharnas en promoveer de nieuwe adapter alleen als hij de zittende versie verslaat op je metrieken. Elke cyclus vergroot de afstand tussen jouw model en alles wat een concurrent uit een generiek model kan prompten, want die afstand is je opgebouwde engineeringkennis.
De stack in één oogopslag
- Data: repo's, PR's en docs verzamelen → opschonen, ontdubbelen, secrets verwijderen → vormgeven tot FIM- of instructieparen → recente commits achterhouden.
- Basismodel: een open-weight-codemodel op maat van de taak, met een duidelijke licentie en lange context.
- Training: LoRA/QLoRA via PEFT, Axolotl of Unsloth op een gereserveerde GPU, met geversioneerde runs en bescherming tegen vergeten.
- Evaluatie: uitvoeringstests, lint- en typecontroles en rechtstreekse vergelijkingen met baselines op een achtergehouden set.
- Serving: vLLM/TGI + RAG, geleverd in de IDE, CI of een agent, met routering naar een frontier-API voor de moeilijke staart.
- Hertrainen: een geplande lus die de adapter actueel houdt terwijl de code verandert.
De kern
Een model fine-tunen op de codebase van je bedrijf is geen onderzoeksproject meer dat voorbehouden is aan AI-labs: het is een engineeringproject met een beproefde stack. Een gedisciplineerde datapipeline, een open-weight-basis, een paar uur LoRA-training op een gehuurde GPU, een echt evaluatieharnas, een snelle servinglaag en een hertrainingslus. Krijg de data goed en de rest is loodgieterswerk. Wat je overhoudt, is intelligentie die geen concurrent kan kopen of bij elkaar kan prompten: een model dat code schrijft zoals jouw organisatie code schrijft.
Twijfel je waar je moet beginnen (fine-tunen of leunen op retrieval, welke taak je eerst aanpast, of hoe je de pipeline veilig op je eigen infrastructuur opzet)? Plan een gratis discovery call en we brengen de stack samen met je in kaart.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.