Volgens Mythos zat er niets meer in curl. Een startup vond zes CVE's

By Surya Pratap
24 september 2026
10 min read
AI & Technology

24 september 2026
10 min read
 Nul, en toen negenentwintigHover to explore
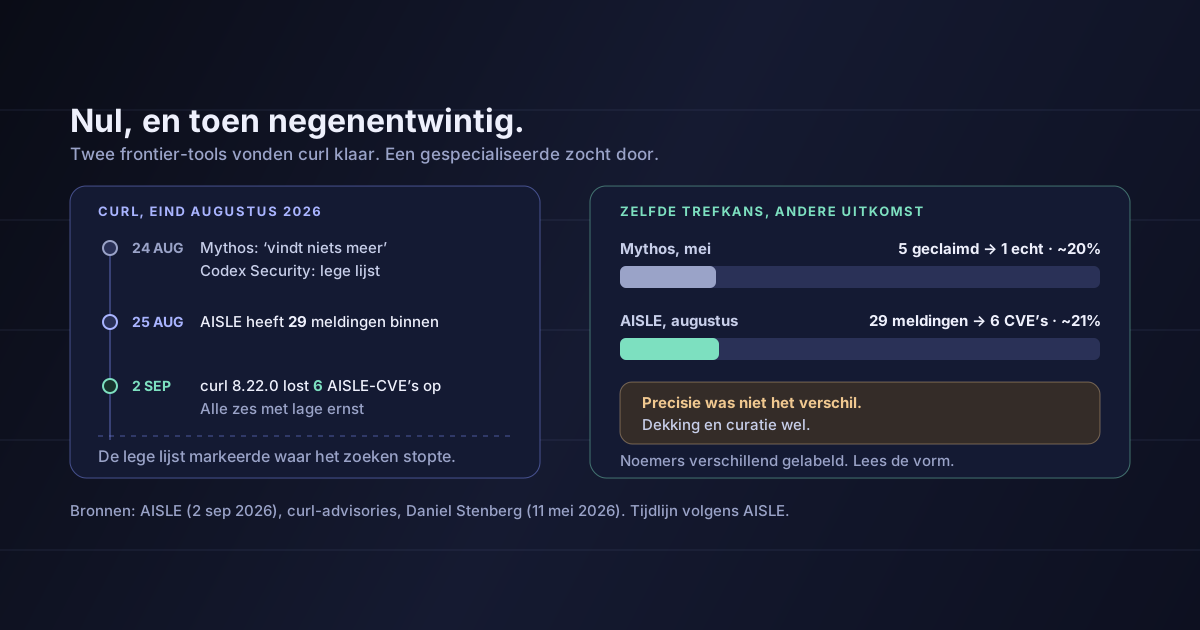
Op 24 augustus plaatste Daniel Stenberg, maintainer van curl, twee korte statusregels. Mythos van Anthropic 'zegt dat het niets meer kan vinden'. Codex Security van OpenAI 'toont een lege lijst'. Een dag later volgde een scorebord: Mythos: 0 / Aisle: 29.
Zes van die negenentwintig meldingen werden CVE's. Ze zijn opgelost in curl 8.22.0, dat op 2 september uitkwam. De meeste berichtgeving kwam neer op startup verslaat OpenAI en Anthropic. Dat klopt, tot op zekere hoogte. Het is ook de minst bruikbare les uit dit verhaal.
De cijfers in dit artikel komen uit het verslag van AISLE over de vondsten in augustus (2 september 2026), de kwetsbaarhedentabel van curl zelf, Daniel Stenbergs verslag van de Mythos-scan (11 mei 2026) en de berichtgeving van ZDNET (4 september 2026). AISLE is een leverancier die over zijn eigen resultaat schrijft; de advisories van curl zijn de onafhankelijke controle. De interpretatie vanaf sectie 3 is van mij.
De tijdlijn is kort genoeg om helemaal te geven.
Anthropic en Alpha-Omega lieten Mythos over de codebase lopen. Het meldde vijf 'bevestigde beveiligingslekken'. Het securityteam van curl bekeek ze en hield er één over, met lage ernst. Drie waren false positives die gedocumenteerd API-gedrag beschreven, één was 'gewoon een bug', en de scan leverde nog zo'n twintig andere bugs op zonder securityimpact. Stenbergs oordeel: de hype was 'vooral marketing', en Mythos was misschien 'een klein beetje beter' dan eerdere tools, niet spectaculair beter.
Mythos kan niets meer vinden. Codex Security: lege lijst. Volgens ZDNET had ZeroPath, een andere AI-scanner, ook niets nieuws gevonden.
Op 28 augustus was het aantal openstaande CVE's bij curl gestegen van drie naar tien, waarvan zes van AISLE.
De tabel van curl noemt ze alle zes: een use-after-free in de OpenSSL-provider, een omzeiling van OpenSSL-pinning, hergebruik van verbindingen met de native CA-store, een omzeiling van het secure-attribuut van cookies met een tab, een cache-hit in de CA-cache van wolfSSL die een callback overschrijft, en een domeincookie op een public suffix. Alle zes hebben lage ernst. Sommige gaan ver terug: de pinning-omzeiling raakt elke versie sinds 7.45.0.
AISLE zegt daarnaast dat het in de junirelease, 8.21.0, zes CVE's op zijn naam kreeg, waaronder een die het omschrijft als de oudste curl-kwetsbaarheid ooit gemeld, geïntroduceerd in maart 2001. Die toeschrijving kon ik niet bevestigen op de pagina's van curl zelf, dus die laat ik buiten het betoog.
Greg Kroah-Hartman, maintainer van de stabiele Linux-kernel, voegde de zin toe die dit groter maakte dan een curl-verhaal: 'Ik zie hetzelfde bij Linux. Geen idee wat Aisle anders doet, maar wow…'
Dit zijn de twee runs op curl waarvan genoeg cijfers zijn gepubliceerd om ze te vergelijken:
Dat is niet dezelfde meting. De vijf van Mythos waren al als bevestigde kwetsbaarheden gelabeld, de 29 van AISLE waren meldingen, en een deel van de overige 23 kan een echte bug zijn geweest in plaats van ruis. Maar de kern blijft overeind: AISLE won niet op precisie. Beide systemen legden de maintainer zo'n vier onbevestigde meldingen voor per echte vondst.
Het verschil was niet dat AISLE vaker gelijk had. Het verschil was dat AISLE nog zocht toen de andere tools al gestopt waren.
Daarmee gaat het verhaal over iets anders. Een frontier-model dat draait, meldt wat het vond en dan zegt dat er niets meer is, vertelt je waar zijn zoektocht ophield. Het resultaat van AISLE laat zien dat de bugs in curl daar niet ophielden. Wat telde was dekking, niet het oordeel over één losse vondst.
Dit deel gaat jou aan, ook als je curl nooit aanraakt.
Zegt een scanner dat hij niets vond, dan weet je wat die tool kon zien vanaf de plek waar hij keek. Je weet niet dat de code schoon is. Dat gold altijd al voor statische analyse en fuzzers, en daarom draaien security-engineers er ook meerdere. Nieuw is dat AI-scanners hun uitslag vloeiend uitleggen. 'Ik heb de codebase doorgelicht en geen verdere kwetsbaarheden gevonden' klinkt als een conclusie, niet als een grens van de dekking.
Twee manieren om dezelfde nul te lezen
Gelezen als oordeel: de code bevat geen verdere problemen van deze soort. Uitrollen.
Gelezen als grens: deze tool, met deze prompt, dit contextbudget en deze zoekstrategie, leverde niets meer op. Iets met een andere strategie misschien wel.
curl in augustus is een zuiver voorbeeld waarin de tweede lezing klopte, bij een van de meest gefuzzte en geauditeerde C-codebases die er zijn.
Als een volwassen project met een fulltime securityproces zes echte CVE's achter twee lege lijsten kan hebben, heeft een SaaS-codebase van twaalf maanden oud die vóór de SOC 2-audit één AI-scan draaide niet veel aangetoond.
Geen van beide posts van AISLE beschrijft een architectuur. Alles wat ik over de werking zou zeggen is dus speculatie, en daar begin ik niet aan. Twee dingen staan wel vast, en die zijn genoeg.
Het eerste is hoe AISLE het zelf formuleert: 'Cybersecuritycapaciteit is grillig: bij goed afgebakende securitytaken kunnen kleinere modellen veel grotere en duurdere LLM's verslaan.' Dat past bij wat wij zien als we nichegerichte agents bouwen. Een generalistisch model is afgesteld om redelijk vaak goed te zijn in alles. Een systeem dat voor één taak is gebouwd kan zijn hele budget aan de zoekruimte van die taak besteden: welke subsystemen, welke configuraties, welke interacties tussen TLS-backends en hergebruik van verbindingen. Alle zes vondsten van augustus zitten precies in zo'n hoek.
Het tweede is wat de maintainer opviel. Stenbergs lof ging niet over ruwe capaciteit. Hij zei dat AISLE 'echt engineeringtijd steekt in zorgen dat wij gecureerde resultaten van topkwaliteit krijgen'. Jim Fuller van Red Hat zei iets vergelijkbaars: het 'heeft harder gewerkt dan alleen een scanner draaien'.
Leg die twee naast elkaar en het product is duidelijk:
Het is geen beter model. Het is een zoekstrategie gericht op één domein, plus curatie op menselijk niveau voordat iets bij de persoon komt die ermee aan de slag moet. Mythos en Codex Security zijn generalistische tools die voor iedereen beschikbaar zijn. AISLE is een systeem dat iemand voor deze klus heeft gebouwd en dat bleef draaien toen het voor de hand liggende terrein al was afgezocht.
Dit is waarschijnlijk het helderste openbare bewijs tot nu toe in een discussie die founders steeds weer met investeerders voeren: wat houdt het lab tegen om dit zelf te doen?
De tool van het lab stopt waar hij generalistisch is. Mythos en Codex Security zijn gebouwd om op elke repository te werken. Juist die breedte is waarom ze als eerste opgaven bij curl. Jouw wig is de diepgang die zij voor één verticale markt niet kunnen verantwoorden.
Verkoop geaccepteerde uitkomsten, geen ruwe output. curl gaf niets om 29 meldingen. Het ging om zes CVE's en de maintainertijd die het kostte om daar te komen. Levert jouw product vondsten, concepten of leads op, dan is het getal dat je klant voelt wat zijn review overleeft, per uur van zijn tijd.
Curatie is product, geen overhead. Dezelfde trefkans van 20% is een cadeau als iemand het vooraf heeft gecontroleerd, en een kostenpost als niemand dat deed. Stenberg noemt de huidige stand van AI-securitymeldingen een 'chaostijdperk van hoge kwaliteit'. Een product dat die chaos opvangt is meer waard dan een product dat hem doorstuurt.
Kies een ground truth die iemand anders beoordeelt. De claim van AISLE is geloofwaardig omdat de maintainers van curl, niet AISLE, bepaalden wat telde. Zoek het equivalent in jouw domein, zoals een auditor, een toezichthouder of een gemergde pull request, en rapporteer daartegen in plaats van tegen je eigen dashboard.
De ongemakkelijke helft van dezelfde les: als jouw product een dunne laag is die één keer een frontier-model aanroept en het antwoord opmaakt, dan weet je nu hoe je concurrent eruitziet.
Vier aanpassingen, allemaal goedkoop:
Twee generalistische frontier-tools hebben vaak dezelfde blinde vlekken. Combineer er één met een klassieke statische analyzer, een fuzzer op je parsers of een gespecialiseerde tool. Verschil in methode vindt de tweede laag.
Noteer welke tool, welke versie, welke paden en welke datum. Een lege uitslag zonder scope belandt anders in een securityvragenlijst als bewijs voor iets wat nooit is gemeten.
Bij één echte vondst op vijf is een scan met veertig items een week engineeringtijd. Bepaal wie beoordeelt en hoe snel voordat je de tool aanzet, anders blijven de meldingen liggen.
Vier van de zes vondsten in curl zitten in het gedrag van TLS-backends, de andere twee in randgevallen bij het parsen van cookies: configuratie-interacties, niet het voor de hand liggende requestpad. In jouw product zijn dat meestal randgevallen in authenticatie, grenzen tussen tenants en alles wat credentials cachet.
AISLE is de bron van het grootste deel van dit verhaal. De tijdlijn, de 29 en de framing komen uit AISLE's eigen post. De tabel van curl bevestigt onafhankelijk de zes CVE's en hun ernst. Niets onafhankelijks bevestigt hoeveel compute, tijd of menselijke inzet het kostte om ze te vinden.
De vergelijking is niet gecontroleerd. Mythos draaide in mei, AISLE eind augustus, op een codebase die tussendoor veranderde en de vondsten van Mythos al had verwerkt. Dat maakt het resultaat van AISLE eerder moeilijker dan makkelijker, maar het blijft geen benchmark.
Alle zes hebben lage ernst. Dat is normaal voor curl, waar zelden nog iets anders te vinden is. Het betekent wel dat dit voorval dekking aantoont, niet het vermogen om kritieke bugs te vinden die anderen misten.
De vergelijking tussen 20% en 21% is grof. De twee noemers waren anders gelabeld, zoals sectie 2 zegt. Ik gebruik hem om te laten zien dat precisie niet het voor de hand liggende verschil was, niet om te beweren dat beide even precies zijn.
De opmerking van Kroah-Hartman over Linux is één zin. 'Ik zie hetzelfde' is een signaal om in de gaten te houden, geen gepubliceerd resultaat.
De makkelijke versie van dit verhaal is David tegen Goliath. De nuttige versie gaat over wat een lege uitslag betekent.
Twee van de best gefinancierde AI-systemen ter wereld keken naar een zwaar geauditeerde codebase en zeiden dat er niets meer te vinden was. Beide beschreven hun eigen zoektocht correct. Een smaller systeem met een andere strategie, en met mensen die de output controleerden voor die de deur uitging, vond binnen enkele dagen zes echte kwetsbaarheden. Zijn trefkans was niet beter. Het ging gewoon door en ruimde zijn eigen rommel op.
Voor een founder die op frontier-modellen bouwt is dat de moat, zonder omhaal: diepgang in één domein en curatie voordat iets bij een mens aankomt. Voor een founder die code uitrolt is het een even directe waarschuwing.
Behandel elk 'geen bevindingen' als de rand van de zoektocht van één tool, en schrijf op waar die rand lag.
Bronnen: AISLE, 'AISLE Discovered Six curl CVEs After OpenAI and Anthropic Found Zero', Stanislav Fort, 2 september 2026: de citaten van Stenberg van 24 en 25 augustus, de 29 meldingen, de stijging van drie naar tien openstaande CVE's en het citaat van Kroah-Hartman, zoals daar gepubliceerd. De kwetsbaarhedentabel van curl voor 8.21.0: de zes identificaties (CVE-2026-80229, -80230, -80231, -80255, -82208, -82209), hun titels, de getroffen versiebereiken en de lage ernst. Daniel Stenberg, 'Mythos finds a curl vulnerability', 11 mei 2026: de vijf geclaimde, de ene bevestigde, de drie false positives, de zo'n twintig bugs en het oordeel 'vooral marketing'. Steven Vaughan-Nichols, ZDNET, via Yahoo Tech, 4 september 2026: het detail over ZeroPath, Stenbergs citaten over het 'chaostijdperk van hoge kwaliteit' en de 'gecureerde resultaten', en de opmerking van Jim Fuller. De claims van AISLE over juni komen uit zijn post over 8.21.0, inclusief het citaat over 'grillige' capaciteit. De vergelijking van verhoudingen in sectie 2 en alles vanaf sectie 3 is van mij. Voor een ander geval waarin het eigen verslag van een agent juist niet te vertrouwen was, zie je coding agent pinde de commit. Voor het argument dat kleine modellen smalle beslissingen winnen, zie het meeste waarvoor je agent een LLM aanroept is een ja of een nee.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.